QGIS 自動化:バッチ処理・グラフィカルモデラー・PyQGIS・AI の4手法を2都市で計測
公開日
繰り返しの多い QGIS ワークフローを自動化する方法は4つあります。多数のファイルに1つのツールをかけるならバッチ処理(Batch Processing)、何度も実行するツールの連鎖ならグラフィカルモデラー(Graphical Modeler)、ループや細かい制御が必要なら PyQGIS スクリプト、普通の文章1つで結果がほしいなら QGIS 内の AI エージェントです。
 ワークフローを自動化する方法は4つあります。多数のファイルに1つのツールをかけるならバッチ処理(Batch Processing)、何度も実行するツールの連鎖ならグラフィカルモデラー(Graphical Modeler)、ループや細かい制御が必要なら
私が読んだチュートリアルは、どれもこの4つのうち1つだけを簡単な例で教えるもので、新しい都市でワークフローをもう一度実行したときに何が起きるかを試したものはありませんでした。2026年11月7日、私は1つの多段階タスク(ドイツ・ビーレフェルトの OpenStreetMap 建物 180,602 件から地区ごとの市街地面積を求める)を QGIS 3.44.15 で4つの方法すべてで実行し、続いて4つともミュンスター(建物 135,577 件、6地区)で再実行しました。どの方法も両都市で合格しましたが、Graphical Modeler の1回は、10 個ではなく 1,058 個のポリゴンを書き出しながら「OK」で終わっていました。
8.1秒
ビーレフェルトでの PyQGIS スクリプト(ミュンスターでは 7.4 秒)
62.7秒
QGIS 上の Graphical Modeler(ヘッドレスでは 44.5 秒)
60秒
1文の指示で AI Agent がミュンスターを再テスト
1,058行
モデルの気づきにくいバグで 10 行の代わりに書き出された数
QGIS の自動化とは?
QGIS の自動化とは、各ダイアログを手でクリックしていくことなく、プロセシングツールやツールの連鎖を複数のレイヤーに対して実行することです。どの方法の土台にも、Processing Toolbox を動かしているのと同じエンジン、QGIS Processing フレームワークがあります。バッチ表、Graphical Modeler の図、Python スクリプト、コマンドラインツール qgis_process のどこから呼んでもツールは同じなので、自動化の方法を選ぶことは、ツールをどうつなぎたいか、そして来月のためにどんなファイルをディスクに残したいかを選ぶことにほかなりません。
テストしたタスクとデータ
都市計画やコンサルティングでよく出てくる作業を選びました。各地区について、建物を地区境界でクリップし、建物の数を数え、その面積を平方メートルで合計し、クリップした建物に 25 m のバッファをかけて1つの市街地ポリゴンにディゾルブし、1地区1行のきれいな GeoPackage を1つ保存する、というものです。
地区の境界をまたぐ建物はクリップされ、接している各地区で1回ずつ数えます。両都市とも BBBike の PBF 抽出(ODbL、OpenStreetMap contributors)からの OpenStreetMap データを使い、すべての計測のために EPSG:25832(ETRS89 / UTM zone 32N)へ再投影しました。
- 都市1 ビーレフェルト: 10 地区(
admin_level=9)にまたがる建物ポリゴン 180,602 件で、クリップ後の建物片は 115,002 件。生の OSM 建物のうち2件のジオメトリが不正だったため、Fix geometries で一度修復し、4つの方法すべてが同じきれいなファイルから始まるようにしました。 - 都市2 ミュンスター(再実行用): 6 地区にまたがる建物ポリゴン 135,577 件で、クリップ後の建物片は 116,382 件。
4つの方法を試す前に、Processing アルゴリズムを呼ばず、素の PyQGIS ジオメトリ呼び出し(QgsSpatialIndex、geometry.intersection()、unaryUnion()、buffer(25, 5))だけで独立した参照結果を作り、チェック用スクリプトを保存しました。合格の条件は、EPSG:25832 の built_up ポリゴンレイヤーを持つ GeoPackage を1つ出力すること、地区ごとの建物数が完全に一致すること、建物面積が参照から 0.5% 以内、市街地ヘクタールが 1% 以内であること、そして後から手で編集しないことです。
方法1:バッチ処理
Processing Toolbox のどのツールにも、ダイアログ左下に Run as Batch Process (バッチプロセスとして実行)ボタンがあります。これを押すとダイアログが表形式になり、1行がその1つのツールの1回の実行になります。
今回のタスクでは、地区ごとの Clip と地区ごとの Buffer はバッチ処理できれいにこなせます。この2つの手順は、10 地区にまったく同じアルゴリズムを繰り返すだけだからです。ただし、ワークフロー全体を一度に処理することはできません。バッチ処理は一度に1つのツールしか実行せず、10 個の別々の出力レイヤーが残り、それをさらにマージして結合し直す必要があるからです。
入力を再投影して分割する
建物に Reproject layer (Vector general)をかけて EPSG:25832 にします。次に地区レイヤーに name フィールドで Split vector layer (Vector general)をかけ、地区ごとに1つの GeoPackage をフォルダに書き出します。
Clip を全地区にバッチ実行する
Clip (Vector overlay)を開き、 Run as Batch Process をクリックして、地区ファイルごとに1行追加します。Input layer には再投影した建物を指定し、Autofill で地区のオーバーレイと出力テーブル名(clip_<district>)を埋め、 Load layers on completion のチェックを外します。ビーレフェルトでは 10 行すべてが 13.7 秒で終わりました(1地区あたり 1.0 から 4.2 秒)。
Dissolve をオンにして Buffer をバッチ実行する
Buffer (Vector geometry)をバッチモードで開きます。クリップ済みレイヤーごとに1行、Distance 25、Segments 5、 Dissolve result にチェックを入れます。ビーレフェルトの 10 個のバッファは 27.7 秒で終わりました。
マージ、集計、テーブルの結合
Merge vector layers を2回実行します(10 個のクリップレイヤーに1回、10 個のバッファレイヤーに1回)。マージしたクリップに layer フィールドでグループ化した Aggregate (Vector geometry)をかけ、building_count(count($id))と building_area_m2(sum(area($geometry)))を求めます。マージしたバッファに Refactor fields (Vector table)をかけ、$area / 10000 というフィールド計算機の式で built_up_ha を計算し、最後に district で Join attributes by field value (Vector general)を実行して1つの出力レイヤーにします。
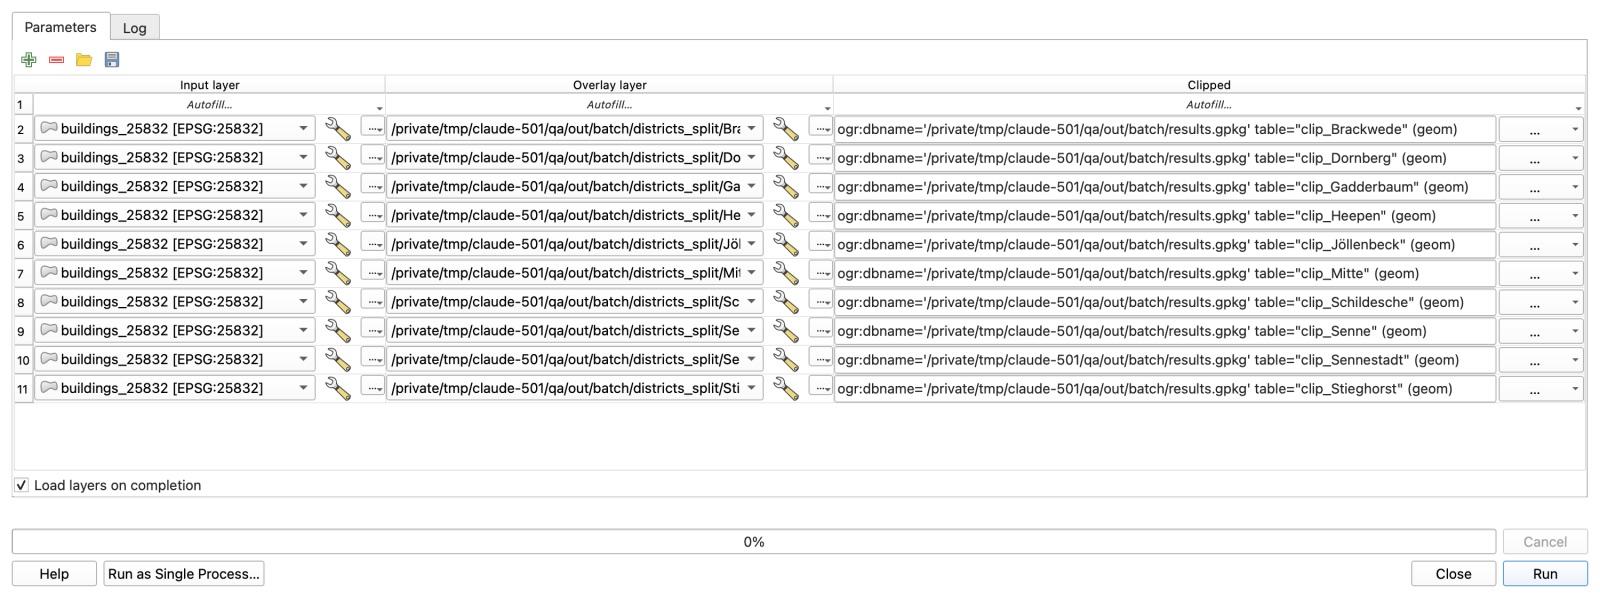
9回の実行(8種類のアルゴリズム)で、ビーレフェルトでのツール実行時間は合計 62.0 秒、地区ごとの数はすべて参照と一致しました。ミュンスターではツール時間が 6 地区で 39.8 秒に下がりましたが、6行のバッチ表を作り直し、9つの手順すべてを手で実行し直す必要がありました。ワークフローが 50 ファイルに1つのツールを繰り返すものではなく、異なるツールの連鎖である場合、バッチ処理は形が合いません。
方法2:グラフィカルモデラー
Graphical Modeler(Processing > Graphical Modeler)では、Processing ツールの連鎖を1つの図につなぎ、.model3 ファイルとして保存できます。作ったモデルは、標準ツールと同じように Processing Toolbox に表示されます。
Modeler の中で地区ごとのループが必要だと思うかもしれませんが、必要ありません。先に建物と地区の間で Intersection を実行すると、建物片はすべて所属地区の name 属性を受け継ぐので、name でグループ化した Aggregate と Dissolve が1回の処理で地区ごとに1行を出力します。(地区の線で建物を厳密に分割する必要がなければ、空間結合を使う手もあります。)
モデルの入力を3つ追加する
新しいモデルに、Buildings と Districts という名前の Vector Layer 入力(Polygons)を2つ、既定値 25 の Buffer distance (m) という名前の Number 入力を1つ追加します。
両方の入力を再投影して交差させる
EPSG:25832 を対象にした Reproject layer ノードを2つ追加します。両方を Intersection ノードにつなぎます(Buildings を Input、Districts を Overlay)。Intersection の Input fields to keep では建物のフィールドを osm_id だけに絞り、Overlay fields to keep では name を残します。
件数用の Aggregate と、ジオメトリ用の Dissolve + Buffer に分岐する
Intersection から1本目の分岐を name でグループ化した Aggregate につなぎ、count($id) と sum(area($geometry)) を計算します。Intersection から2本目の分岐を Dissolve (フィールド name)につなぎ、その後に Buffer (Buffer distance (m) 入力にリンク、セグメント数 5)を置きます。
分岐を結合して出力テーブルを整える
Join attributes by field value を追加して、Aggregate のテーブルを name でバッファ済みポリゴンに結合し、続いて Refactor fields で name を district に名前変更し、built_up_ha を $area / 10000 として計算します。出力を built_up とし、モデルを built_up_by_district.model3 として保存します。
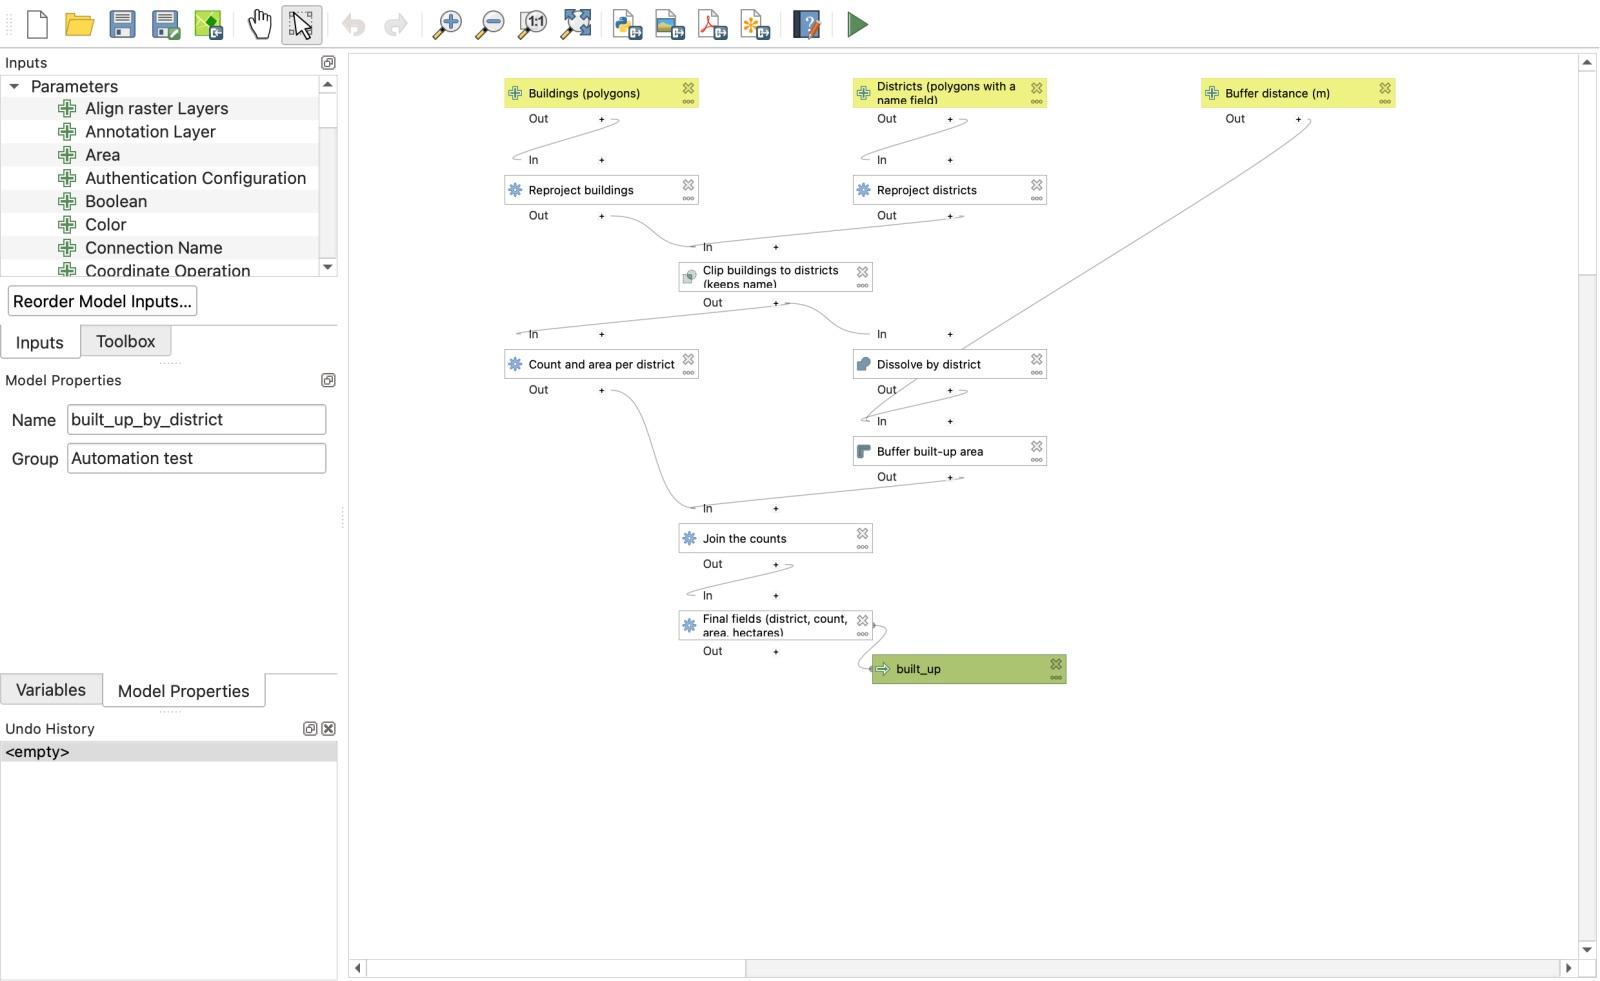
ビーレフェルトでダイアログからモデルを実行すると 62.7 秒かかり、すべてのチェックに合格しました。さらに、まったく同じ .model3 ファイルを、QGIS のウィンドウを開かずに macOS のターミナルから qgis_process で実行すると 44.5 秒でした。
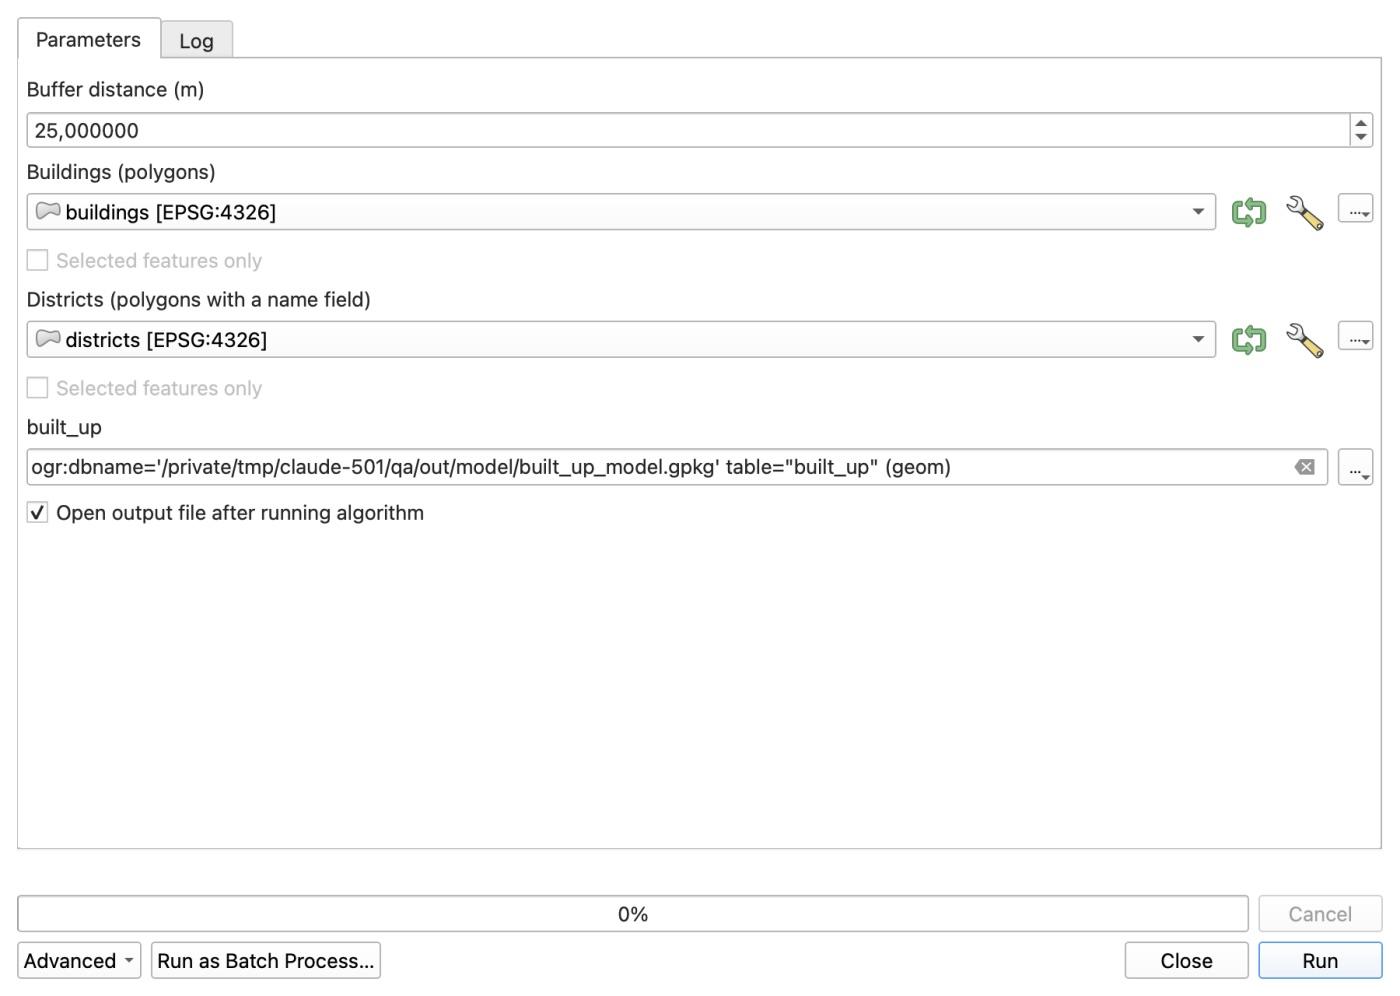
本当の効果はミュンスターでの再実行で現れました。同じモデルのダイアログを開き、2つのドロップダウンで muenster_buildings と muenster_districts を選び、 Run をクリックしただけです。モデルを一切編集せずに 67.2 秒で終わりました。
方法3:Python コンソールでの PyQGIS スクリプト
Python に慣れているなら、Plugins > Python Console > Show Editor の中のスクリプトで、本物の for ループを使え、入力をファイル冒頭の変数にでき、マージの手順もなくなります。
これが QGIS 3.44.15 で実行した 38 行のスクリプト(built_up_by_district.py)です。ファイルパスは短くしています。
# Built-up area by district. Run in the QGIS Python console (Plugins > Python Console > Show Editor > Run).
# Change the first five lines for a new city.
BUILDINGS = "data/bielefeld_buildings.gpkg"
DISTRICTS = "data/bielefeld_districts.gpkg"
NAME_FIELD = "name"
BUFFER_M = 25
OUT = "out/script/built_up_script.gpkg"

import processing
from qgis.core import (QgsVectorLayer, QgsCoordinateReferenceSystem, QgsFeature, QgsField, QgsFields, QgsGeometry)
from qgis.PyQt.QtCore import QVariant

crs = QgsCoordinateReferenceSystem("EPSG:25832")   # metric, Germany
def run(alg, **p):
    return processing.run(alg, p)["OUTPUT"]

buildings = run("native:reprojectlayer", INPUT=BUILDINGS, TARGET_CRS=crs, OUTPUT="memory:")
districts = run("native:reprojectlayer", INPUT=DISTRICTS, TARGET_CRS=crs, OUTPUT="memory:")

result = QgsVectorLayer("MultiPolygon?crs=EPSG:25832", "built_up", "memory")
result.dataProvider().addAttributes([QgsField("district", QVariant.String), QgsField("building_count", QVariant.Int),
                                     QgsField("building_area_m2", QVariant.Double), QgsField("built_up_ha", QVariant.Double)])
result.updateFields()

for d in districts.getFeatures():
    one = run("native:extractbyexpression", INPUT=districts, EXPRESSION=f"$id = {d.id()}", OUTPUT="memory:")
    clipped = run("native:clip", INPUT=buildings, OVERLAY=one, OUTPUT="memory:")
    area = sum(f.geometry().area() for f in clipped.getFeatures())
    built_up = run("native:buffer", INPUT=clipped, DISTANCE=BUFFER_M, SEGMENTS=5, DISSOLVE=True, OUTPUT="memory:")
    geom = next(built_up.getFeatures()).geometry()
    f = QgsFeature(result.fields())
    f.setGeometry(geom)
    f.setAttributes([d[NAME_FIELD], clipped.featureCount(), area, geom.area() / 10000])
    result.dataProvider().addFeature(f)
    print(d[NAME_FIELD], clipped.featureCount(), round(area), round(geom.area() / 10000, 1))

processing.run("native:savefeatures", {"INPUT": result, "OUTPUT": OUT, "LAYER_NAME": "built_up"})
print("saved", OUT)
このスクリプトは中間レイヤーをすべてメモリに置いて地区ごとにループし、群を抜いて速い方法でした(理由はプロファイルしていません)。ビーレフェルトを 8.1 秒で終え、すべての地区で独立した参照結果と 0.00% の差で一致しました。
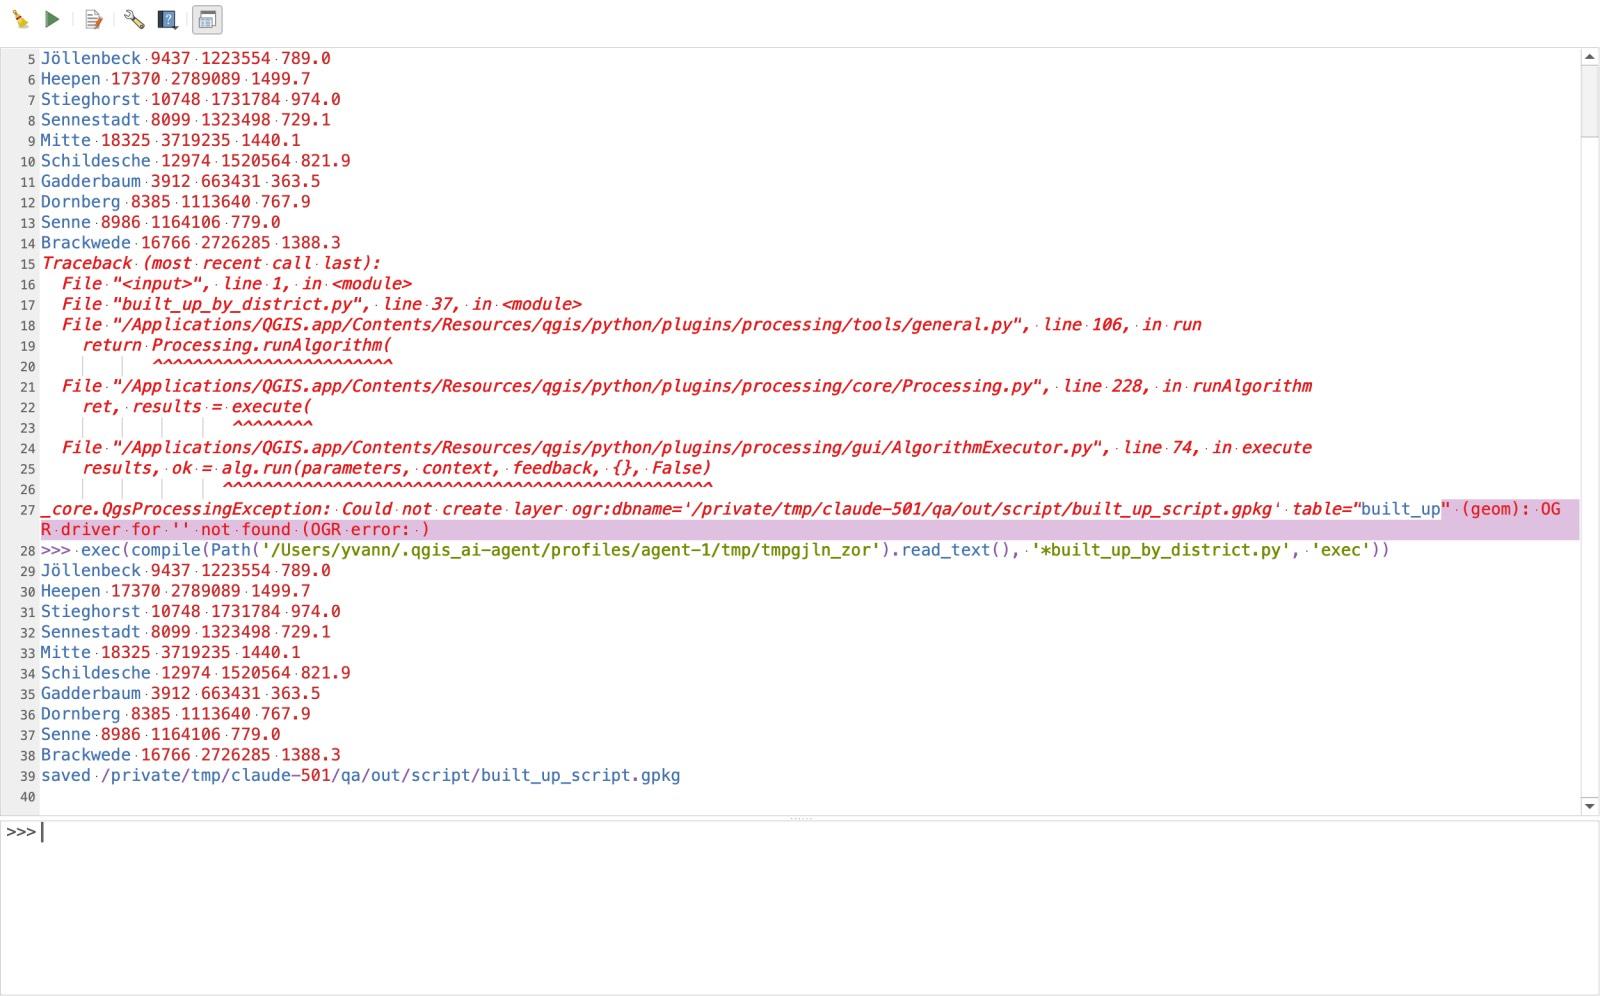
ミュンスターで再実行するために、冒頭の3行(BUILDINGS、DISTRICTS、OUT)を変え、緑色の Run Script 再生ボタンをクリックしました。7.4 秒で終わりました。processing.run の仕組みを詳しく知りたい場合は、PyQGIS ガイドを参照してください。
両都市での4つの方法の比較
2026年11月7日に4つの方法で計測した結果です。
| バッチ処理 | Graphical Modeler | PyQGIS スクリプト | AI Agent(Medium、Balanced) | |
|---|---|---|---|---|
| セットアップ / 構成 | 8 アルゴリズムで 9 回の実行(10 行のバッチ表 2 つ) | 入力 3 + アルゴリズムノード 8 + 出力 1 | Python 38 行、アルゴリズム 5 つ | 普通の英文メッセージ 1 つ(エージェントのツール呼び出し 27 回) |
| ビーレフェルトの処理時間、10 地区 | ツール時間 62.0 秒(1 つずつ開始) | ダイアログで 62.7 秒(qgis_process で 44.5 秒) | 8.1 秒(失敗した保存呼び出しを 1 つ直した後) | Send から回答表まで 110 秒 |
| ミュンスターでの再実行、6 地区 | ツール時間 39.8 秒(バッチ行を作り直し、9 回すべて実行) | 67.2 秒(新しいレイヤーを 2 つ選び、Run をクリック) | 7.4 秒(ファイルパスの 3 行を変え、Run をクリック) | 60 秒(46 語の追加メッセージ 1 つ、ツール呼び出し 15 回) |
参照との最大差 built_up_ha | +0.08% | +0.08% | 0.00% | +0.21% |
| 後に残るもの | 中間レイヤー約 20 個 | .model3 ファイル 1 つ(UI でもヘッドレスでも実行可) | .py スクリプトファイル 1 つ | チャット履歴とプロンプトの文面 |
どの方法も、参照の建物数と建物面積(building_area_m2)に 0.00% の差で一致しました。バッチ処理と Graphical Modeler の built_up_ha に出た +0.08% の差は、Refactor fields の $area がプロジェクトの楕円体上で計測するのに対し、スクリプトと参照は EPSG:25832 の平面上で geometry().area() を使ったことによるものです。
途中で壊れたこと(気づきにくい誤答を含む)
チュートリアルが失敗した実行を見せることはまずないので、その日に出たエラーはすべて記録しました。一番怖かった失敗は、クラッシュでも赤いエラー表示でもなく、成功を報告しながら間違った出力を出した Graphical Modeler の実行でした。
Intersection ノードのフィールドを絞る前に、初めてモデルをヘッドレスで実行したとき、ログにはこう表示されました。
Model processed OK. Executed 8 algorithm(s) total in 84.548 s.
エラーも警告もありません。出力の GeoPackage を確認すると、built_up には 10 個ではなく 1,058 個のポリゴン がありました。
理由はこうです。OpenStreetMap の建物には独自の name 列(店、学校、教会などの名前)があり、地区レイヤーにも name 列があります。Intersection が両レイヤーの全フィールドを結合したとき、建物の name は name のまま残り、地区の name は何の通知もなく name_2 に名前が変わりました。その下流の Aggregate と Dissolve は name でグループ化していたので、地区ではなく建物名でグループ化していたのです。Intersection の Input fields to keep を osm_id に絞ると衝突がなくなり、出力は 10 地区に戻りました。
ほかにも壊れたことが3つあり、自分のデータを自動化する前に知っておく価値があります。
- 不正な OSM ジオメトリは、既定では Processing を止めます ビーレフェルトの建物 180,602 件のうち2件に自己交差するリングがありました。QGIS の既定設定では、Clip は
Feature (18818404) from 'b' has invalid geometryで即座に止まります。入力が生の OpenStreetMap から来ているときは、最初の手順で Fix geometries を実行してください。 - PyQGIS の
savefeaturesは GDAL の接続文字列を嫌います スクリプトの最初の実行(10.0 秒)で、native:savefeaturesにogr:dbname='...' table="built_up"を渡すとOGR driver for '' not foundが出ました。OUTPUTには素の.gpkgパスを渡し、LAYER_NAME: "built_up"を別のパラメータとして指定してください。 - 中間レイヤーを大量に読み込むとセッションがクラッシュしました Load layers on completion にチェックを入れたまま Processing の出力がレイヤーツリーに読み込まれる間に、QGIS が3回クラッシュ(
SIGSEGV)しました。中間のバッチ行でチェックを外すと、クラッシュは止まりました。
方法4:QGIS 内の AI エージェントに頼む
AI Agent は私たちが作っているので、この節は自社プラグインの話です。QGIS の中にチャットパネルをドッキングし、プロジェクトにすでにあるレイヤーとフィールドを調べ、QGIS Processing ツールや PyQGIS を自ら呼び出し、回答する前に出力を確認します。
1回きりの作業や2都市だけのプロジェクトでは、8ノードのグラフィカルモデルを作ったり 38 行のスクリプトをデバッグしたりするのは、タスクに見合わない準備になりがちです。ビーレフェルトの buildings と districts レイヤーを含むプロジェクトを開き、パネルを Medium effort と Balanced 権限に設定して、メッセージを1つ送りました。
The project has two layers: "buildings" (OSM buildings of Bielefeld, Germany) and "districts" (its 10 city districts, the district name is in the field "name"). For each district: clip the buildings to the district, count the buildings, sum their footprint area in square meters, and build a 25 m buffer around the clipped buildings, dissolved into one built-up polygon, with its area in hectares. Measure in a metric CRS (EPSG:25832). Write one GeoPackage at [output folder]/built_up_agent.gpkg with a single polygon layer named built_up, one feature per district, fields district, building_count, building_area_m2, built_up_ha, in EPSG:25832. Then show me the result table.
(両方のプロンプトとも出力パスは短くしています。透明性のための注記: 最初の試行では、Send をクリックして9秒後、回答が返る前に QGIS が Qt スロットのセグフォルトでクラッシュしました。プロジェクトを開き直し、まったく同じプロンプトを1回だけ送り、その後は再送していません。)
エージェントは 110 秒 で 27 回のツール呼び出し(12 run_processing、7 get_algorithm_help、4 execute_code、2 get_layer_info、1 export_layer、1 get_features)を行い、Processing の内部エラー1件から権限カードを出さずに自力で立ち直り、GeoPackage を書き出し、10 地区の表をチャットに表示しました。頼んでもいないのに、回答の中でこう指摘してもいました。"The 25 m buffers can extend across district boundaries and overlap."(25 m のバッファは地区境界をまたいで重なることがあります。)
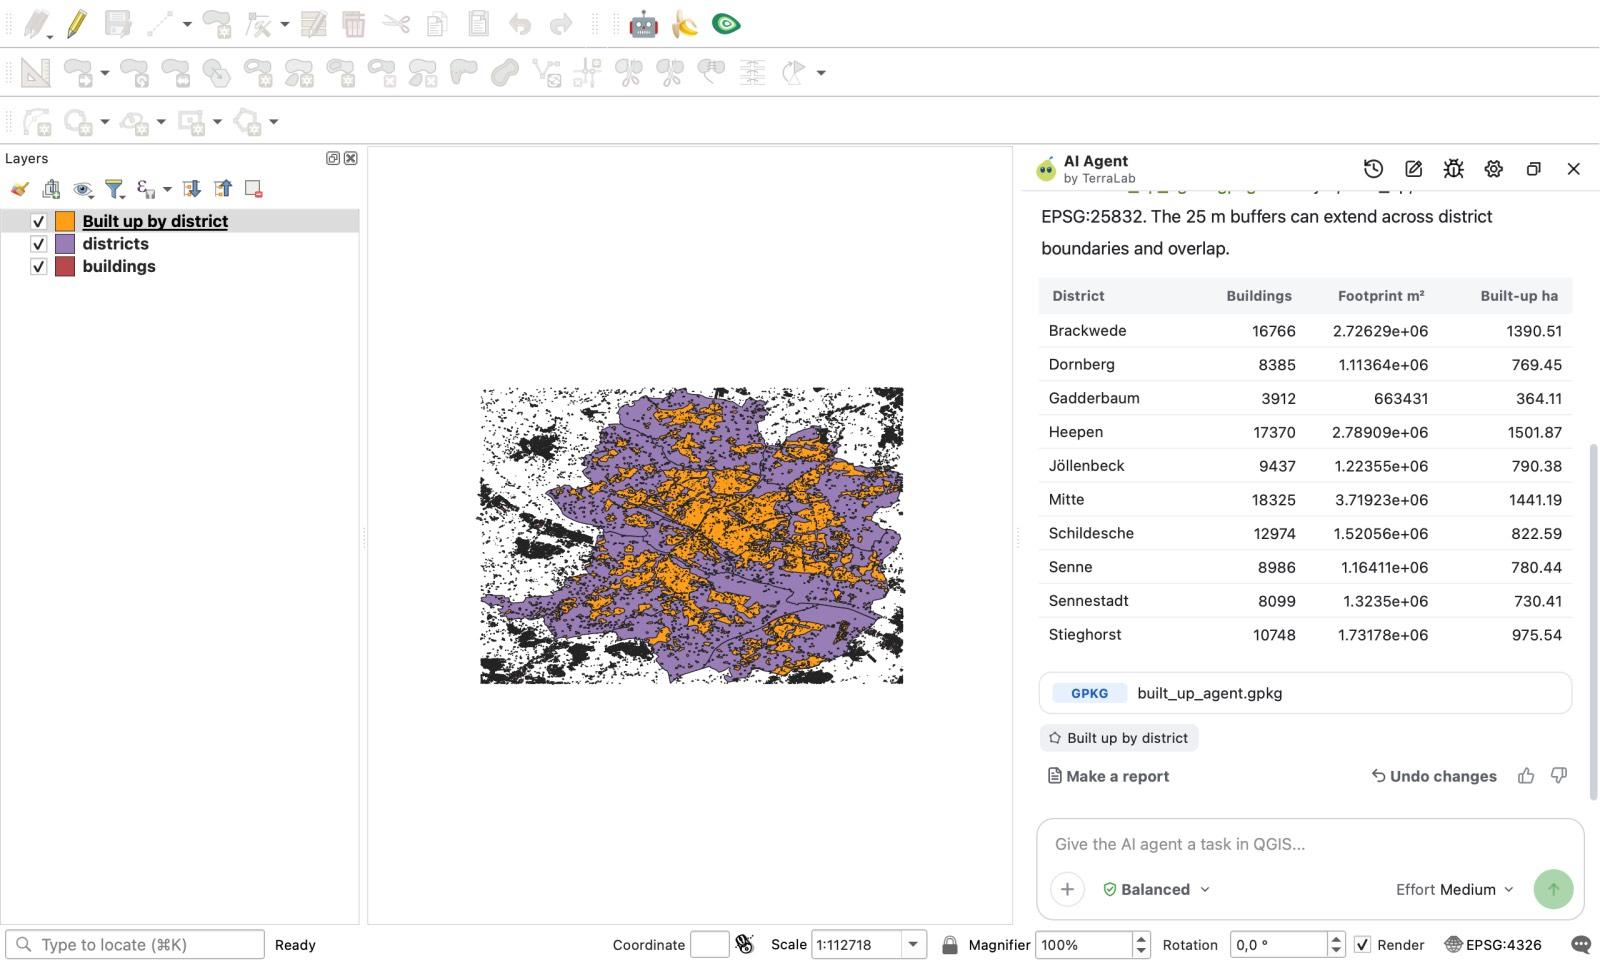
次に muenster_buildings と muenster_districts をプロジェクトにドラッグし、同じチャットに 46 語の追加メッセージを入力しました。
Now do the same for Münster. I added two layers: "muenster_buildings" and "muenster_districts" (6 districts, the name is in the field "name"). Same fields and same 25 m buffer, in a new GeoPackage at [output folder]/built_up_agent_muenster.gpkg with the layer named built_up. Then show me the result table.
同じチャットに最初のテストが残っていたので、エージェントは 15 回のツール呼び出し(11 run_processing、1 export_layer、1 get_features、1 zoom_to_layer、1 execute_code)を使い、エラーなしでミュンスターを 60 秒 で終えました。
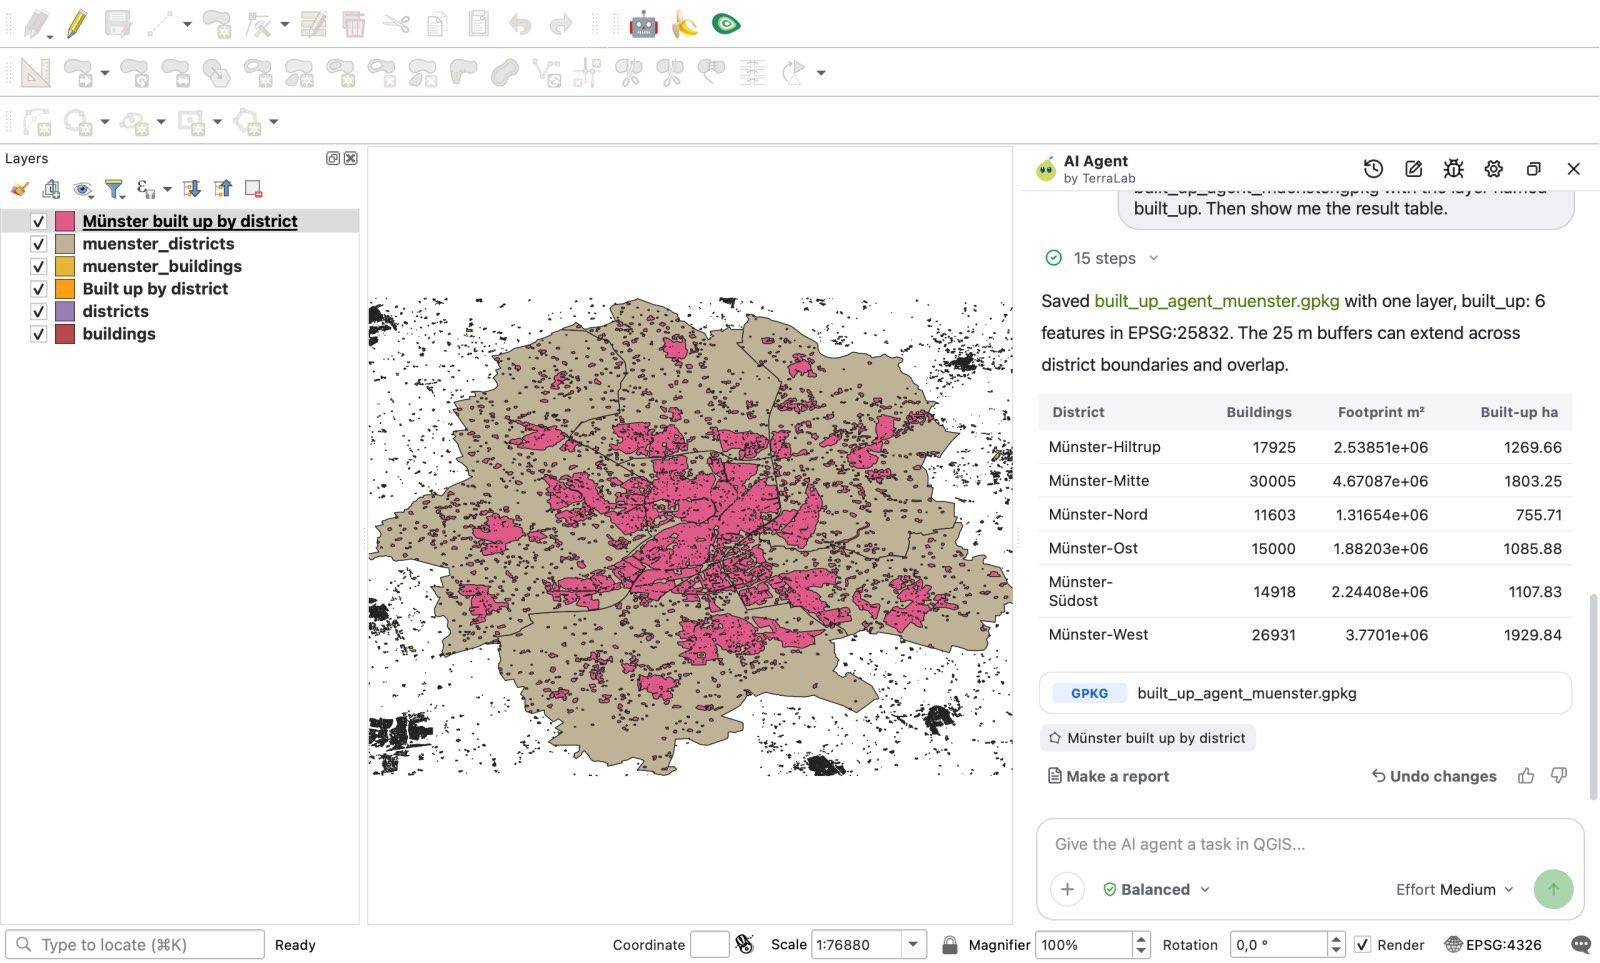
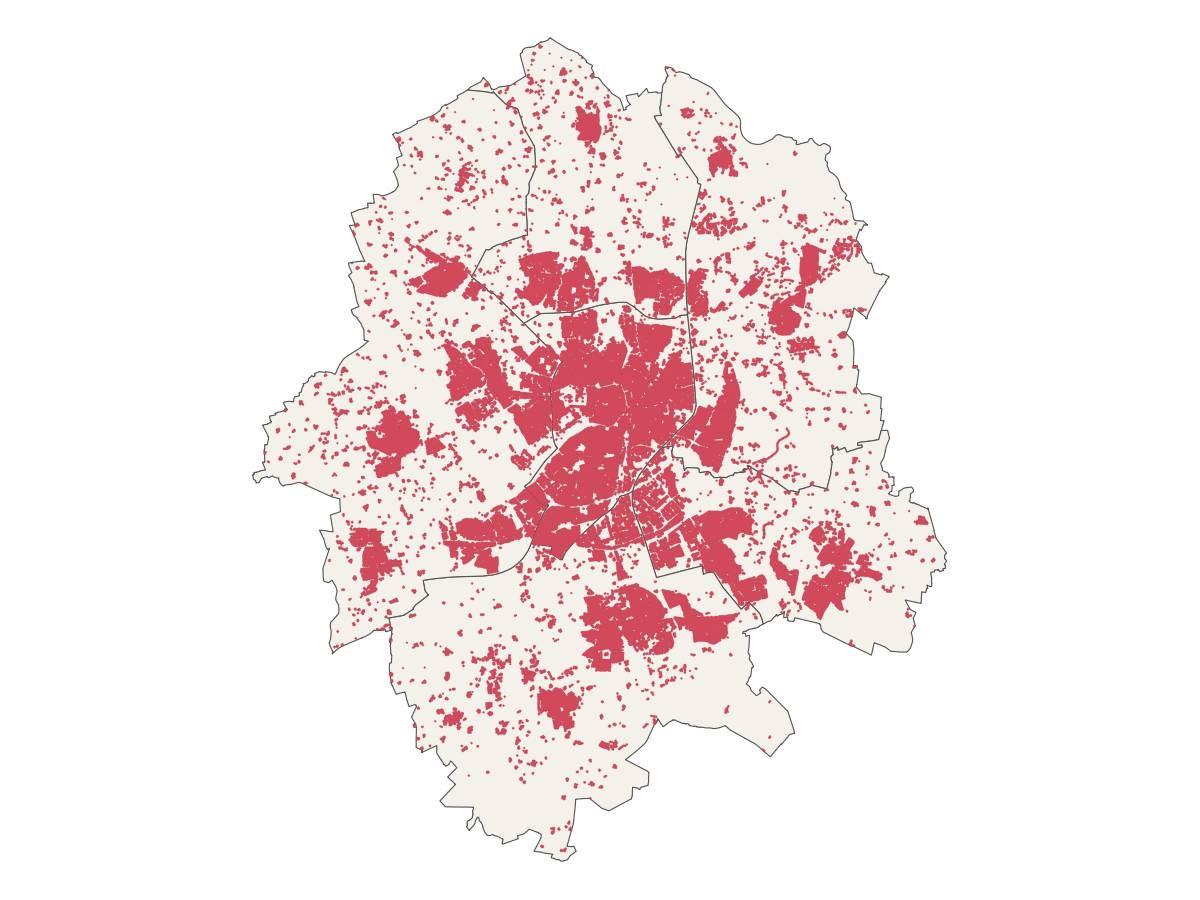
両都市とも、建物数と建物面積はすべて参照と 0.00% の差で一致しました。
限界はどこにあるでしょうか。第一に、エージェントの built_up_ha の値は平面上の参照より 0.07% から 0.21% 高く出ました(たとえば Brackwede は参照の 1,388.31 ha に対して 1,390.51 ha でした。この小さな差をどの内部手順が生んだかは計測していません)。第二に、書き出された GeoPackage に余分な _export_fid 列が残りました。第三に、自動化にとって一番重要な点ですが、エージェントはメッセージのたびに手順を新しく組み立て(ビーレフェルトで 27 回、ミュンスターで 15 回のツール呼び出し)、開いている QGIS セッションの中で動くため、cron で無人実行をスケジュールできる .model3 や .py のファイルは残りません。
どの QGIS 自動化の方法を選ぶべきか?
1つのツールを勝者と決めるのではなく、その作業をどれくらいの頻度で繰り返すかに方法を合わせましょう。
- まったく同じ1つのツールを 10 から 100 ファイルに実行する場合: バッチ処理 を使います。すべての Processing ダイアログに組み込まれていて、費用はかからず、コードも一切いりません。ワークフローが3つ、4つの異なるツールをつなぐようになったら、使うのをやめましょう。
- 自分やチームが多段階の連鎖を毎月、あるいはサーバーのスケジュールで実行する場合: Graphical Modeler で作ります。Python を書かない同僚とも共有できる
.model3ファイルが1つ手に入り、qgis_processを通じてシェルスクリプトやスケジュールされたタスクからヘッドレスで実行できます。 - 独自のループ、平面計算の厳密な制御、最速の処理速度が必要な場合: PyQGIS スクリプト を書きます。今回の 38 行のスクリプトは、両都市で Modeler より 8 から 9 倍速く動きました。
- 複雑なタスクを今日1回、2回、あるいはいくつかのプロジェクトの違いで行う場合: AI Agent のような QGIS 内の AI エージェントを使います(より広い概要は QGIS AI ハブを参照)。正確なツール名を探す手間が省け、2つ目の都市でも1文で再テストできます。Free プランでは Low effort で月 5 タスクまで使えます。今回のテストは Medium で行いました。Medium は Pro(税抜 49 EUR / 月、300 タスク)に含まれます。
計測方法: すべてのテストは 2026年11月7日、1台の Apple Silicon Mac(macOS 27.0.1、arm64)上の隔離された QGIS 3.44.15-Solothurn セッション(Python 3.12.11)で、AI Agent 1.9.4(Medium effort、Balanced モード)を使って行いました。その日のうちにマシンの負荷が変わったので、時間は CPU ベンチマークとしてではなく桁の目安として比べてください。計測したのはマシンの実時間での処理時間と手順数で、GIS アナリストがモデルを一から組んだりスクリプトを書いたりするのにかかる人の時間ではありません。入力データ、.model3 ファイル、.py スクリプト、参照チェッカー、生の JSON ログはすべて実験アーカイブに保存しています。
よくある質問
QGIS で繰り返しのワークフローを自動化するにはどうすればよいですか?
作業を繰り返す頻度に応じて、主に4つの選択肢があります。多数のファイルに1つのツールをかけるなら、ツールのダイアログ内で Run as Batch Process をクリックします。定期的に実行し直す多段階の連鎖なら、Processing > Graphical Modeler でツールをつなぎ、.model3 ファイルを保存します。ループや最速の性能が必要なら、QGIS Python コンソールで processing.run() を使う Python スクリプトを書きます。ノードをつないだりコードを書いたりしたくない1回きり、または数回の分析なら、AI Agent のようなエージェントプラグインに普通の言葉でワークフローを説明します。
QGIS の Graphical Modeler と Python(PyQGIS)のどちらを使うべきですか?
ワークフローが Processing アルゴリズムの単純な連鎖で、チームのプログラマーでない人も開ける視覚的な .model3 ファイルがほしい場合や、qgis_process でコマンドラインから実行したい場合は Graphical Modeler を使います。地物をループで処理したい、中間レイヤーをメモリに置きたい(ビーレフェルトのテストではスクリプトが 8.1 秒、モデルが 62.7 秒)、エラーをコードで処理したい、出力スキーマを明示的に制御したい場合は PyQGIS を使います。
QGIS のグラフィカルモデルを Python スクリプトに書き出せますか?
はい。Graphical Modeler はモデルを Python の Processing スクリプトとして書き出せます。使うのは Export as Script Algorithm です。書き出したスクリプトを編集して、ループや変数、独自の処理を加えられます。今回の比較では、この書き出しはテストしていません。
QGIS はアプリを開かずに自動ワークフローをスケジュール実行できますか?
はい。QGIS には qgis_process というコマンドラインユーティリティが付属しています。bash スクリプト、Windows タスクスケジューラ、cron ジョブから、QGIS のグラフィカル画面を起動せずに、任意の標準アルゴリズムや保存済みの .model3 ファイルを渡せます(たとえば qgis_process run model3 --BUILDINGS=... --DISTRICTS=... --built_up=...)。ビーレフェルトのテストでは、モデルは qgis_process によるヘッドレス実行で 44.5 秒でした。