QGIS automatiseren: 1 taak, 4 methoden, getimed op 2 steden
Gepubliceerd op
Je kunt een terugkerende QGIS-workflow op vier manieren automatiseren: Batch Processing voor één tool over veel bestanden, de Graphical Modeler (grafische modellering) voor een keten van tools die je opnieuw gaat draaien, een PyQGIS-script voor loops en precieze controle, of een AI-agent in QGIS als je het resultaat wilt uit één bericht in gewone taal.
 -workflow op vier manieren automatiseren: Batch Processing voor één tool over veel bestanden, de Graphical Modeler (grafische modellering) voor een keten van tools die je opnieuw gaat draaien, een
De tutorials die ik las, leren één van die vier los aan op een speelgoedvoorbeeld, en geen ervan test wat er gebeurt als je de workflow een tweede keer draait op een nieuwe stad. Op 7 november 2026 nam ik één taak in meerdere stappen (bebouwd oppervlak per stadsdeel uit 180.602 OpenStreetMap-gebouwen in Bielefeld, Duitsland), voerde die uit met alle vier methoden in QGIS 3.44.15 en herhaalde daarna alle vier op Münster (135.577 gebouwen, 6 stadsdelen). Elke methode slaagde op beide steden, al eindigde één run van de Graphical Modeler eerst met "OK" terwijl hij 1.058 polygonen wegschreef in plaats van 10.
8.1s
PyQGIS-script op Bielefeld (7,4 s op Münster)
62.7s
Graphical Modeler in QGIS (44,5 s headless)
60s
AI Agent herhaalt Münster vanuit 1 zin
1,058rijen
Weggeschreven in plaats van 10 bij een stille modelfout
Wat is QGIS-automatisering?
QGIS automatiseren betekent een processing-tool of een keten van tools over lagen draaien zonder elk dialoogvenster met de hand door te klikken. Onder elke methode zit het Processing-framework van QGIS, dezelfde motor die de Processing Toolbox aandrijft. Omdat de tools identiek zijn, of je ze nu aanroept vanuit een batchtabel, een diagram in de Graphical Modeler, een Python-script of de opdrachtregeltool qgis_process, kies je met een automatiseringsmethode eigenlijk hoe je die tools aan elkaar wilt koppelen en welk bestand je volgende maand op schijf wilt hebben staan.
De taak en de data waarop we testten
Ik koos een klus die steeds terugkomt in stedenbouw en advieswerk: knip voor elk stadsdeel de gebouwen af op de stadsdeelgrens, tel de footprints, tel hun oppervlakte op in vierkante meters, buffer de geknipte gebouwen met 25 m en voeg ze samen (dissolve) tot één bebouwd polygoon, en sla één nette GeoPackage op met één rij per stadsdeel.
Als een gebouw over een stadsdeelgrens loopt, wordt het geknipt en één keer meegeteld in elk stadsdeel dat het raakt. Beide steden gebruiken OpenStreetMap-data uit PBF-extracten van BBBike (ODbL, OpenStreetMap-bijdragers), voor alle metingen geprojecteerd naar EPSG:25832 (ETRS89 / UTM zone 32N).
- Stad 1, Bielefeld: 180.602 gebouwpolygonen verdeeld over 10 stadsdelen (
admin_level=9), goed voor 115.002 geknipte gebouwdelen. Twee ruwe OSM-gebouwen hadden ongeldige geometrieën en werden één keer gerepareerd met Fix geometries, zodat alle vier methoden vanuit dezelfde schone bestanden begonnen. - Stad 2, Münster (de herhaling): 135.577 gebouwpolygonen verdeeld over 6 stadsdelen, goed voor 116.382 geknipte delen.
Voordat ik een van de vier methoden draaide, schreef ik een onafhankelijke referentie met gewone PyQGIS-geometrieaanroepen (QgsSpatialIndex, geometry.intersection(), unaryUnion() en buffer(25, 5), zonder Processing-algoritmen aan te roepen) en bewaarde ik een controlescript. Een methode slaagde alleen als ze één GeoPackage opleverde met een polygoonlaag built_up in EPSG:25832, exacte gebouwaantallen per stadsdeel, footprint-oppervlakte binnen 0,5% van de referentie, bebouwde hectares binnen 1%, en geen handwerk achteraf.
Methode 1: Batch Processing
Elke tool in de Processing Toolbox heeft een knop Run as Batch Process linksonder in het dialoogvenster. Die verandert het venster in een spreadsheet waarin elke rij één run van die ene tool is.
Voor onze taak doet batch processing de Clip per stadsdeel en de Buffer per stadsdeel netjes, omdat die twee stappen precies hetzelfde algoritme herhalen over de 10 stadsdelen. De hele workflow in één keer lukt niet, want Batch Processing draait maar één tool tegelijk en laat je achter met 10 losse uitvoerlagen die je nog moet samenvoegen en weer koppelen.
Projecteer en splits de invoer
Draai Reproject layer (Vector general) op de gebouwen naar EPSG:25832. Draai daarna Split vector layer (Vector general) op de stadsdelenlaag met het veld name, dat één GeoPackage per stadsdeel in een map schrijft.
Draai Clip als batch over alle stadsdelen
Open Clip (Vector overlay), klik op Run as Batch Process en voeg één rij per stadsdeelbestand toe. Zet de geprojecteerde gebouwen als Input layer, gebruik Autofill om de stadsdeel-overlays en de namen van de uitvoertabellen (clip_<district>) in te vullen, en vink Load layers on completion uit. Op Bielefeld waren alle 10 rijen klaar in 13,7 s (1,0 tot 4,2 s per stadsdeel).
Draai Buffer als batch met Dissolve aan
Open Buffer (Vector geometry) in batchmodus: één rij per geknipte laag, Distance 25, Segments 5, en Dissolve result aangevinkt. De 10 buffers van Bielefeld liepen in 27,7 s.
Voeg samen, aggregeer en koppel de tabel weer
Draai Merge vector layers twee keer (één keer op de 10 cliplagen, één keer op de 10 bufferlagen). Draai Aggregate (Vector geometry) op de samengevoegde clips, gegroepeerd op het veld layer, om building_count (count($id)) en building_area_m2 (sum(area($geometry))) te krijgen. Draai Refactor fields (Vector table) op de samengevoegde buffers om built_up_ha te berekenen met de veldberekening-expressie $area / 10000, en daarna Join attributes by field value (Vector general) op district om de ene uitvoerlaag te maken.
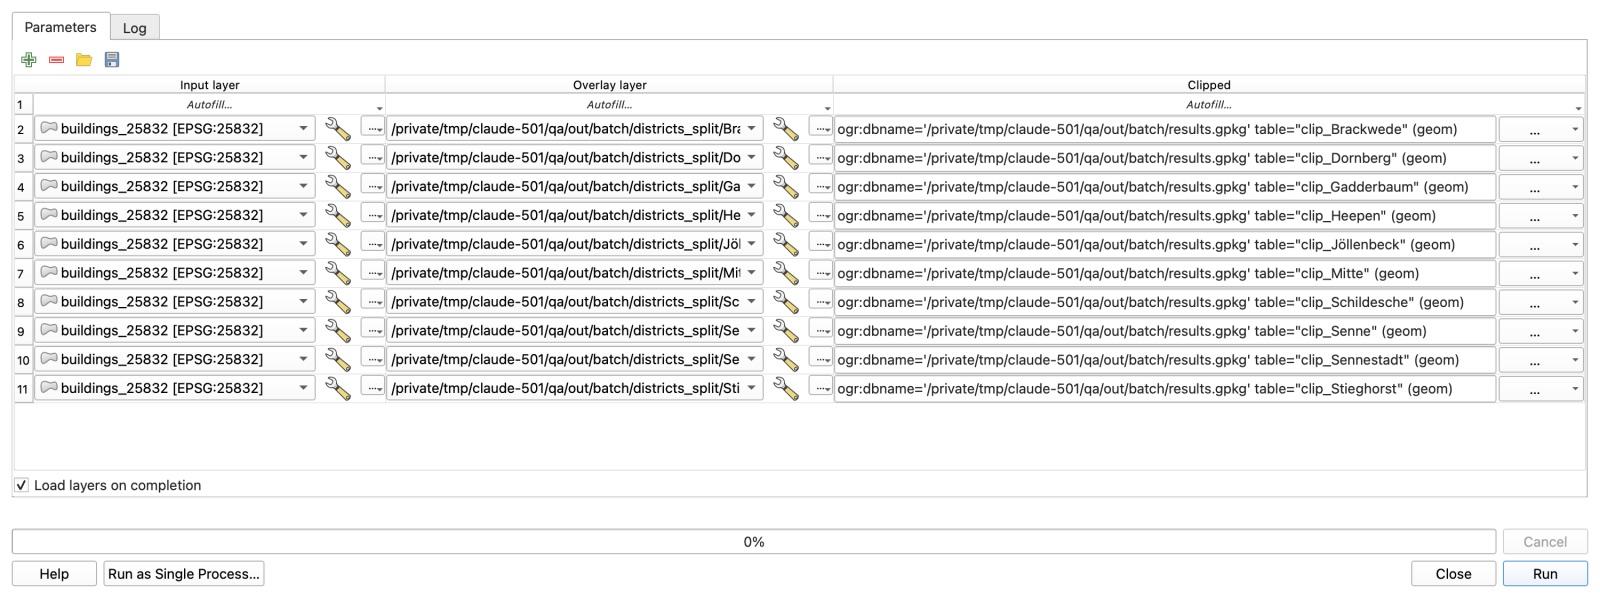
Over de 9 runs (8 verschillende algoritmen) was de totale uitvoeringstijd van de tools op Bielefeld 62,0 seconden, en elk aantal per stadsdeel klopte met de referentie. Op Münster zakte de tooltijd naar 39,8 seconden voor 6 stadsdelen, maar ik moest de batchtabellen van 6 rijen opnieuw opbouwen en alle 9 stappen met de hand opnieuw draaien. Als je workflow een keten van verschillende tools is in plaats van één tool herhaald over 50 bestanden, heeft Batch Processing de verkeerde vorm.
Methode 2: De Graphical Modeler
Met de Graphical Modeler (Processing > Graphical Modeler) koppel je een keten van Processing-tools in één diagram en sla je die op als .model3-bestand. Eenmaal gebouwd staat het model in je Processing Toolbox zoals elke ingebouwde tool.
Je zou verwachten dat je in de Modeler een loop over de stadsdelen nodig hebt, maar dat is niet zo. Door eerst Intersection te draaien tussen de gebouwen en de stadsdelen, erft elk gebouwdeel het attribuut name van zijn stadsdeel, zodat Aggregate en Dissolve, gegroepeerd op name, in één doorgang één rij per stadsdeel opleveren. (Je kunt ook een spatial join gebruiken als de gebouwen niet strikt op de stadsdeelgrens gesplitst hoeven te worden.)
Voeg de drie modelinvoeren toe
Voeg in een nieuw model twee Vector Layer-invoeren toe (Polygons) met de namen Buildings en Districts, en één Number-invoer met de naam Buffer distance (m) en standaardwaarde 25.
Projecteer beide invoeren en laat ze snijden
Voeg twee Reproject layer-nodes toe met doel EPSG:25832. Verbind beide met een Intersection-node (Buildings als Input, Districts als Overlay). Beperk in Input fields to keep van Intersection de gebouwvelden tot alleen osm_id, en houd in Overlay fields to keep het veld name.
Splits naar Aggregate voor de aantallen en Dissolve + Buffer voor de geometrie
Verbind vanuit Intersection één tak met Aggregate, gegroepeerd op name, om count($id) en sum(area($geometry)) te berekenen. Verbind een tweede tak vanuit Intersection met Dissolve (veld name), gevolgd door Buffer (gekoppeld aan je invoer Buffer distance (m), 5 segmenten).
Koppel de takken en maak de uitvoertabel op
Voeg Join attributes by field value toe om de Aggregate-tabel op name aan de gebufferde polygonen te koppelen, en daarna Refactor fields om name te hernoemen naar district en built_up_ha te berekenen als $area / 10000. Markeer de uitvoer als built_up en sla het model op als built_up_by_district.model3.
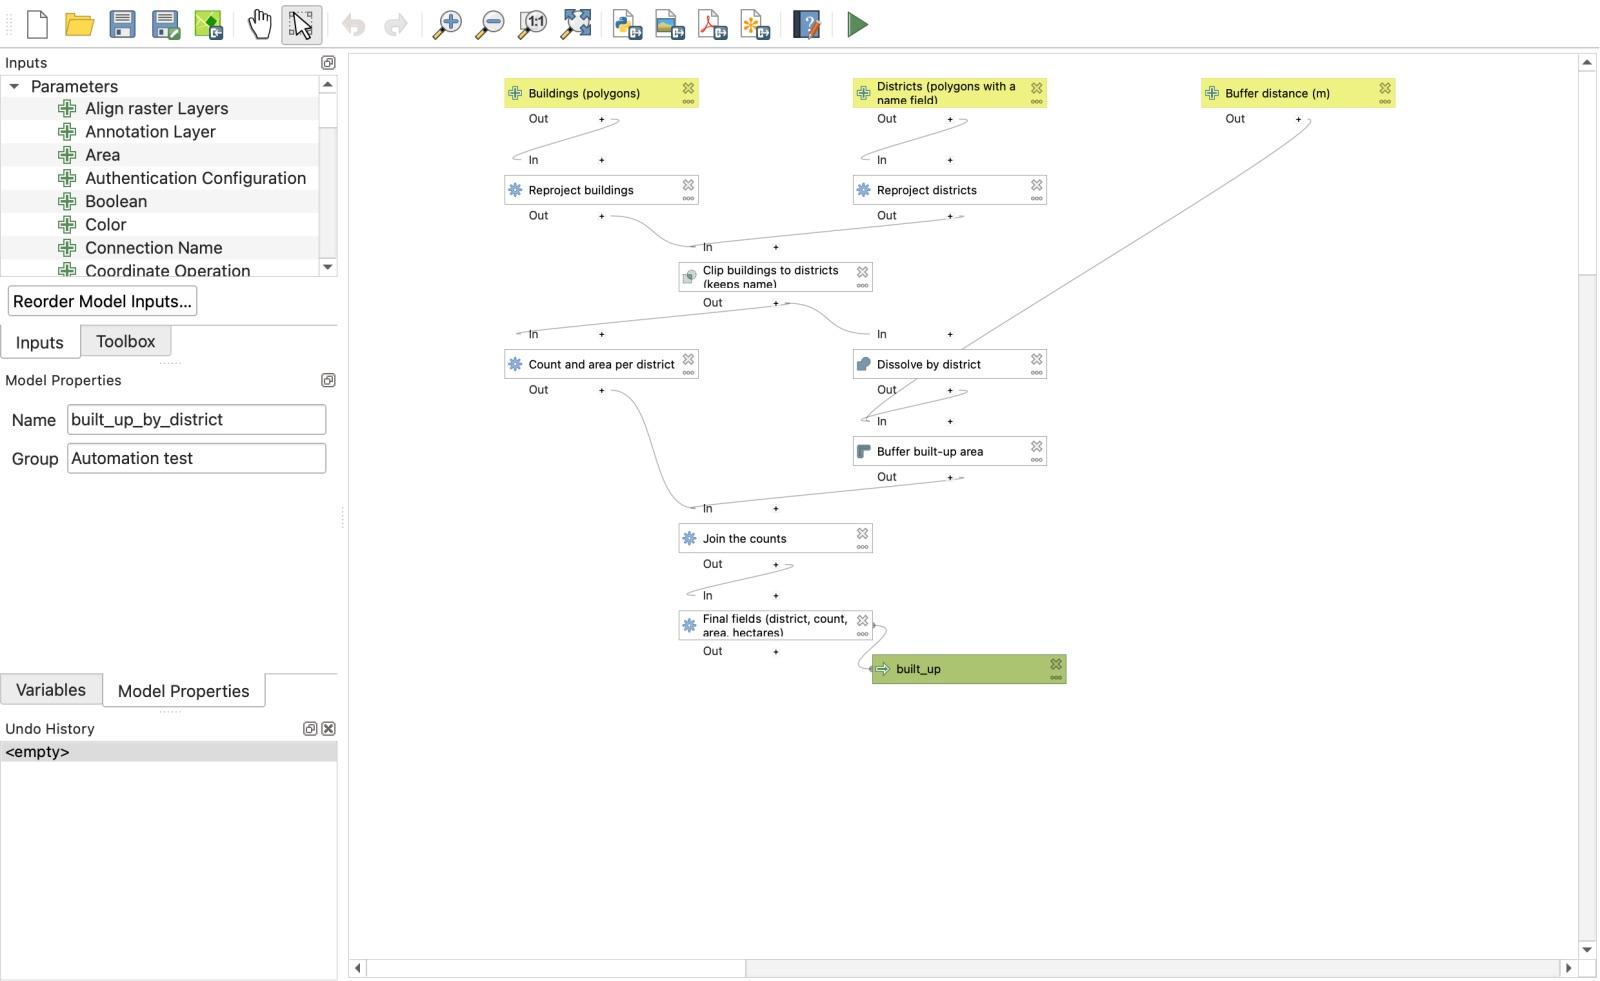
Het model draaien vanuit zijn dialoogvenster op Bielefeld duurde 62,7 seconden en doorstond elke controle. Beter nog: precies hetzelfde .model3-bestand draaide vanuit de macOS-terminal zonder QGIS-venster via qgis_process in 44,5 seconden.
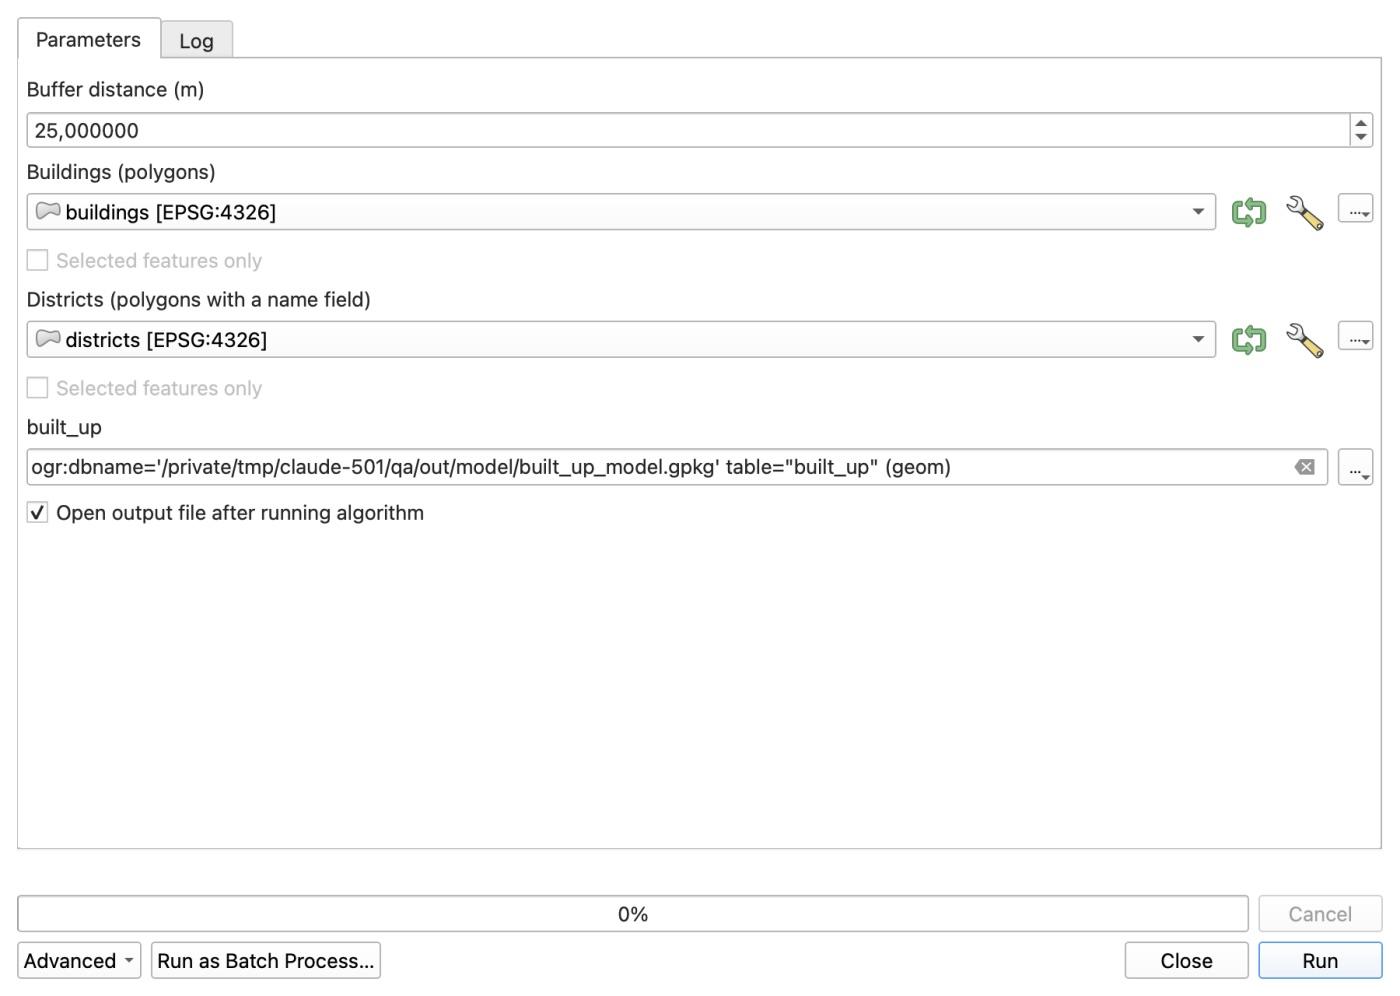
De echte winst kwam bij de herhaling op Münster. Ik opende hetzelfde modeldialoogvenster, koos muenster_buildings en muenster_districts in de twee keuzelijsten en klikte op Run. Het was klaar in 67,2 seconden, zonder één wijziging aan het model.
Methode 3: Een PyQGIS-script in de Python Console
Als je vertrouwd bent met Python, geeft een script in Plugins > Python Console > Show Editor je een echte for-loop, de invoer als variabelen bovenaan het bestand, en geen samenvoegstappen.
Dit is het script van 38 regels (built_up_by_district.py) dat ik in QGIS 3.44.15 draaide, met ingekorte bestandspaden:
# Built-up area by district. Run in the QGIS Python console (Plugins > Python Console > Show Editor > Run).
# Change the first five lines for a new city.
BUILDINGS = "data/bielefeld_buildings.gpkg"
DISTRICTS = "data/bielefeld_districts.gpkg"
NAME_FIELD = "name"
BUFFER_M = 25
OUT = "out/script/built_up_script.gpkg"

import processing
from qgis.core import (QgsVectorLayer, QgsCoordinateReferenceSystem, QgsFeature, QgsField, QgsFields, QgsGeometry)
from qgis.PyQt.QtCore import QVariant

crs = QgsCoordinateReferenceSystem("EPSG:25832")   # metric, Germany
def run(alg, **p):
    return processing.run(alg, p)["OUTPUT"]

buildings = run("native:reprojectlayer", INPUT=BUILDINGS, TARGET_CRS=crs, OUTPUT="memory:")
districts = run("native:reprojectlayer", INPUT=DISTRICTS, TARGET_CRS=crs, OUTPUT="memory:")

result = QgsVectorLayer("MultiPolygon?crs=EPSG:25832", "built_up", "memory")
result.dataProvider().addAttributes([QgsField("district", QVariant.String), QgsField("building_count", QVariant.Int),
                                     QgsField("building_area_m2", QVariant.Double), QgsField("built_up_ha", QVariant.Double)])
result.updateFields()

for d in districts.getFeatures():
    one = run("native:extractbyexpression", INPUT=districts, EXPRESSION=f"$id = {d.id()}", OUTPUT="memory:")
    clipped = run("native:clip", INPUT=buildings, OVERLAY=one, OUTPUT="memory:")
    area = sum(f.geometry().area() for f in clipped.getFeatures())
    built_up = run("native:buffer", INPUT=clipped, DISTANCE=BUFFER_M, SEGMENTS=5, DISSOLVE=True, OUTPUT="memory:")
    geom = next(built_up.getFeatures()).geometry()
    f = QgsFeature(result.fields())
    f.setGeometry(geom)
    f.setAttributes([d[NAME_FIELD], clipped.featureCount(), area, geom.area() / 10000])
    result.dataProvider().addFeature(f)
    print(d[NAME_FIELD], clipped.featureCount(), round(area), round(geom.area() / 10000, 1))

processing.run("native:savefeatures", {"INPUT": result, "OUTPUT": OUT, "LAYER_NAME": "built_up"})
print("saved", OUT)
Het script houdt elke tussenlaag in het geheugen en loopt over de stadsdelen, en het was veruit de snelste methode (we hebben niet geprofileerd waarom). Het had Bielefeld af in 8,1 seconden en kwam op elk stadsdeel tot op 0.00% overeen met de onafhankelijke referentie.
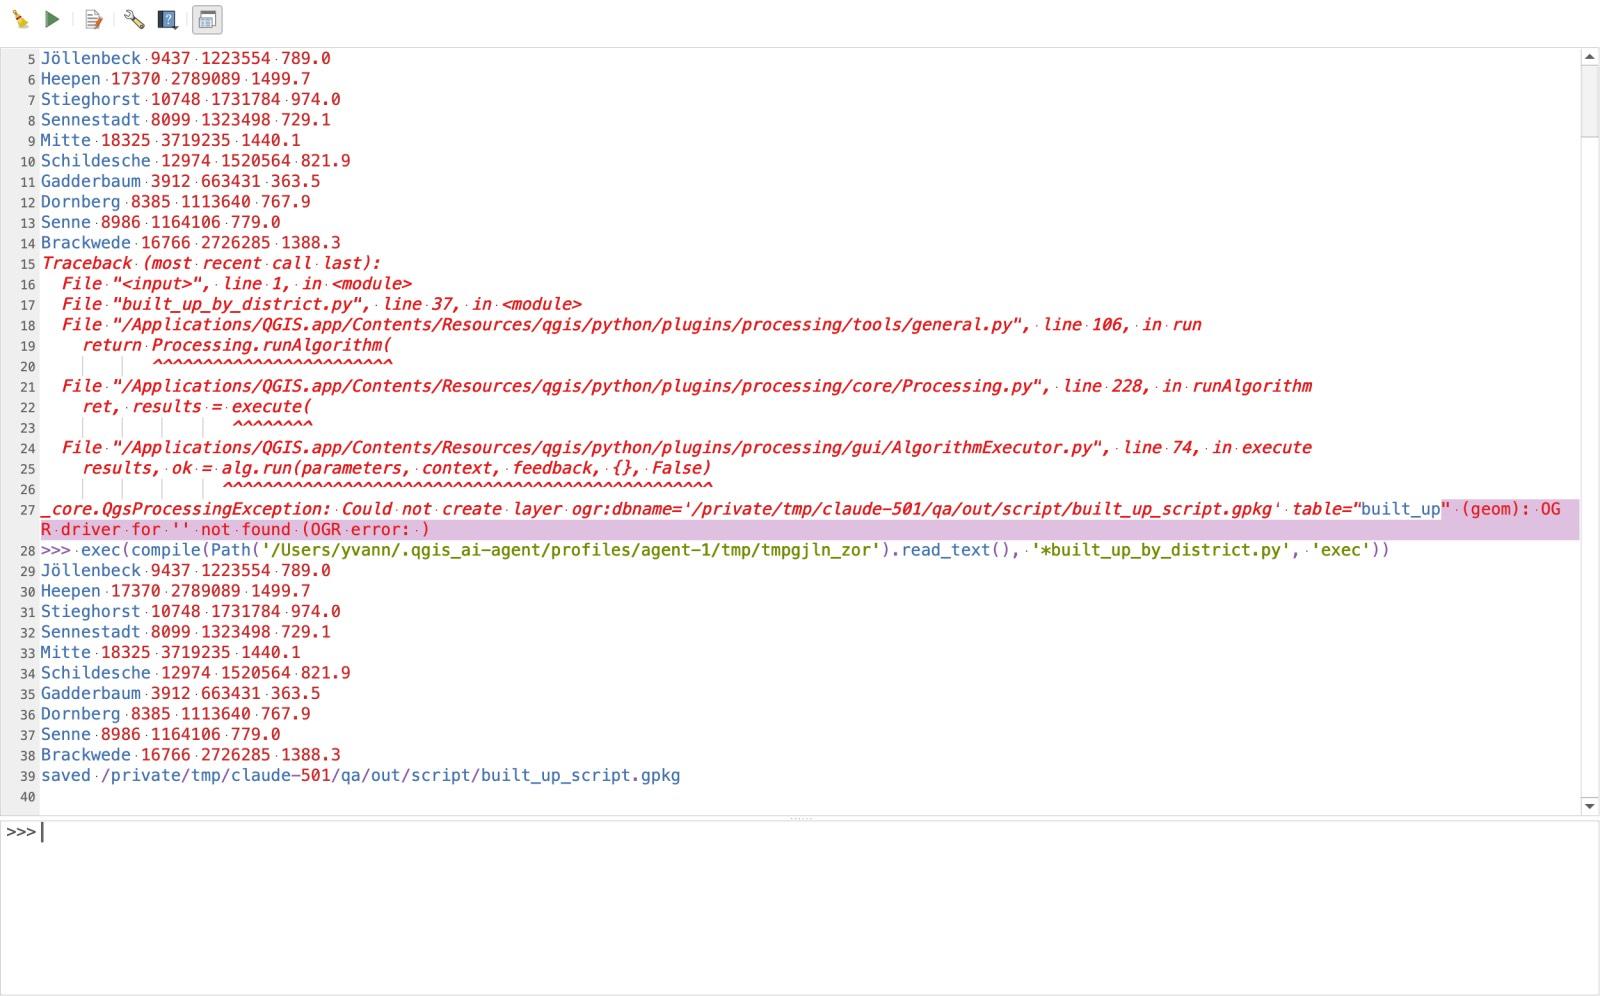
Om het op Münster opnieuw te draaien, veranderde ik drie regels bovenaan (BUILDINGS, DISTRICTS en OUT) en klikte ik op de groene afspeelknop Run Script. Het was klaar in 7,4 seconden. Wil je in detail leren hoe processing.run werkt, lees dan onze PyQGIS-gids.
Hoe de vier methoden zich op beide steden verhielden
Dit hebben we op 7 november 2026 gemeten over alle vier methoden:
| Batch Processing | Graphical Modeler | PyQGIS-script | AI Agent (Medium, Balanced) | |
|---|---|---|---|---|
| Opzet / structuur | 9 runs over 8 algoritmen (2 batchtabellen van 10 rijen) | 3 invoeren + 8 algoritme-nodes + 1 uitvoer | 38 regels Python, 5 algoritmen | 1 bericht in gewone taal (27 tool calls door de agent) |
| Looptijd Bielefeld (10 stadsdelen) | 62,0 s tooltijd (één voor één gestart) | 62,7 s in het dialoogvenster (44,5 s via qgis_process) | 8,1 s (na het herstellen van 1 mislukte save-aanroep) | 110 s van Send tot de antwoordtabel |
| Herhaling Münster (6 stadsdelen) | 39,8 s tooltijd (batchrijen opnieuw opbouwen en alle 9 runs) | 67,2 s (2 nieuwe lagen kiezen, op Run klikken) | 7,4 s (3 regels met bestandspaden wijzigen, op Run klikken) | 60 s (1 vervolgbericht van 46 woorden, 15 tool calls) |
Grootste afwijking t.o.v. referentie (built_up_ha) | +0,08% | +0,08% | 0,00% | +0,21% |
| Wat je daarna overhoudt | ~20 tussenlagen | Eén .model3-bestand (draait in de interface of headless) | Eén .py-scriptbestand | De chatgeschiedenis en de tekst van je prompt |
Elke methode kwam tot op 0.00% overeen met de referentie voor de gebouwaantallen en de footprint-oppervlaktes (building_area_m2). Het verschil van +0.08% op built_up_ha bij Batch Processing en de Graphical Modeler komt doordat $area in Refactor fields meet op de ellipsoïde van het project, terwijl het script en de referentie de vlakke geometry().area() in EPSG:25832 gebruikten.
Wat er onderweg misging (inclusief een stil fout antwoord)
Tutorials laten zelden de runs zien die mislukken, dus ik heb die dag elke fout bijgehouden. De engste fout was geen crash of rode foutbalk: het was een run van de Graphical Modeler die succes meldde en de verkeerde uitvoer gaf.
Toen ik het model voor het eerst headless draaide, voordat ik de velden op de Intersection-node had beperkt, schreef de log:
Model processed OK. Executed 8 algorithm(s) total in 84.548 s.
Geen fout, geen waarschuwing. Toen ik de uitvoer-GeoPackage controleerde, had built_up 1.058 polygonen in plaats van 10.
Dit is waarom: OpenStreetMap-gebouwen hebben hun eigen kolom name (de naam van een winkel, school of kerk), en de stadsdelenlaag heeft ook een kolom name. Toen Intersection alle velden van beide lagen combineerde, bleef de name van de gebouwen name en werd de name van het stadsdeel stilletjes hernoemd naar name_2. Verderop groepeerden Aggregate en Dissolve op name, dus groepeerden ze op gebouwnamen in plaats van stadsdelen! Door Input fields to keep van Intersection te beperken tot osm_id verdween de botsing en zakte de uitvoer terug naar de 10 stadsdelen.
Drie andere dingen gingen mis en zijn het weten waard voordat je je eigen data automatiseert:
- Ongeldige OSM-geometrieën stoppen Processing standaard. Twee van de 180.602 gebouwen in Bielefeld hadden zichzelf snijdende ringen. Met de standaardinstelling van QGIS stopt Clip meteen met
Feature (18818404) from 'b' has invalid geometry. Draai Fix geometries als eerste stap zodra je invoer uit ruwe OpenStreetMap-data komt. savefeaturesin PyQGIS houdt niet van GDAL-verbindingsstrings. Bij mijn eerste scriptrun (10,0 s) gaf het doorgeven vanogr:dbname='...' table="built_up"aannative:savefeaturesde foutOGR driver for '' not found. Geef het gewone.gpkg-pad door inOUTPUTen zetLAYER_NAME: "built_up"als aparte parameter.- Veel tussenlagen laden liet onze sessie crashen. QGIS crashte drie keer (
SIGSEGV) terwijl Processing-uitvoer in de lagenboom laadde met Load layers on completion aangevinkt. Dat uitvinken voor de tussenliggende batchrijen maakte een eind aan de crashes.
Methode 4: Het vragen aan een AI-agent in QGIS
Wij bouwen AI Agent, dus deze sectie gaat over onze eigen plugin. Die opent een chatpaneel in QGIS, bekijkt de lagen en velden die al in je project staan, roept zelf QGIS Processing-tools en PyQGIS aan, en controleert de uitvoer voordat hij antwoordt.
Voor een eenmalige klus of een project met twee steden is een Graphical Model met 8 nodes bouwen of een script van 38 regels debuggen vaak meer opzet dan de taak verdient. Ik opende een project met de lagen buildings en districts van Bielefeld, zette het paneel op Medium effort en Balanced permissions, en stuurde één bericht:
The project has two layers: "buildings" (OSM buildings of Bielefeld, Germany) and "districts" (its 10 city districts, the district name is in the field "name"). For each district: clip the buildings to the district, count the buildings, sum their footprint area in square meters, and build a 25 m buffer around the clipped buildings, dissolved into one built-up polygon, with its area in hectares. Measure in a metric CRS (EPSG:25832). Write one GeoPackage at [output folder]/built_up_agent.gpkg with a single polygon layer named built_up, one feature per district, fields district, building_count, building_area_m2, built_up_ha, in EPSG:25832. Then show me the result table.
(Uitvoerpaden ingekort in beide prompts. Ter transparantie: bij de allereerste poging crashte QGIS 9 seconden nadat ik op Send had geklikt, met een segfault in een Qt-slot, nog voordat er een antwoord kwam. Ik opende het project opnieuw, stuurde precies dezelfde prompt één keer en stuurde hem daarna niet opnieuw.)
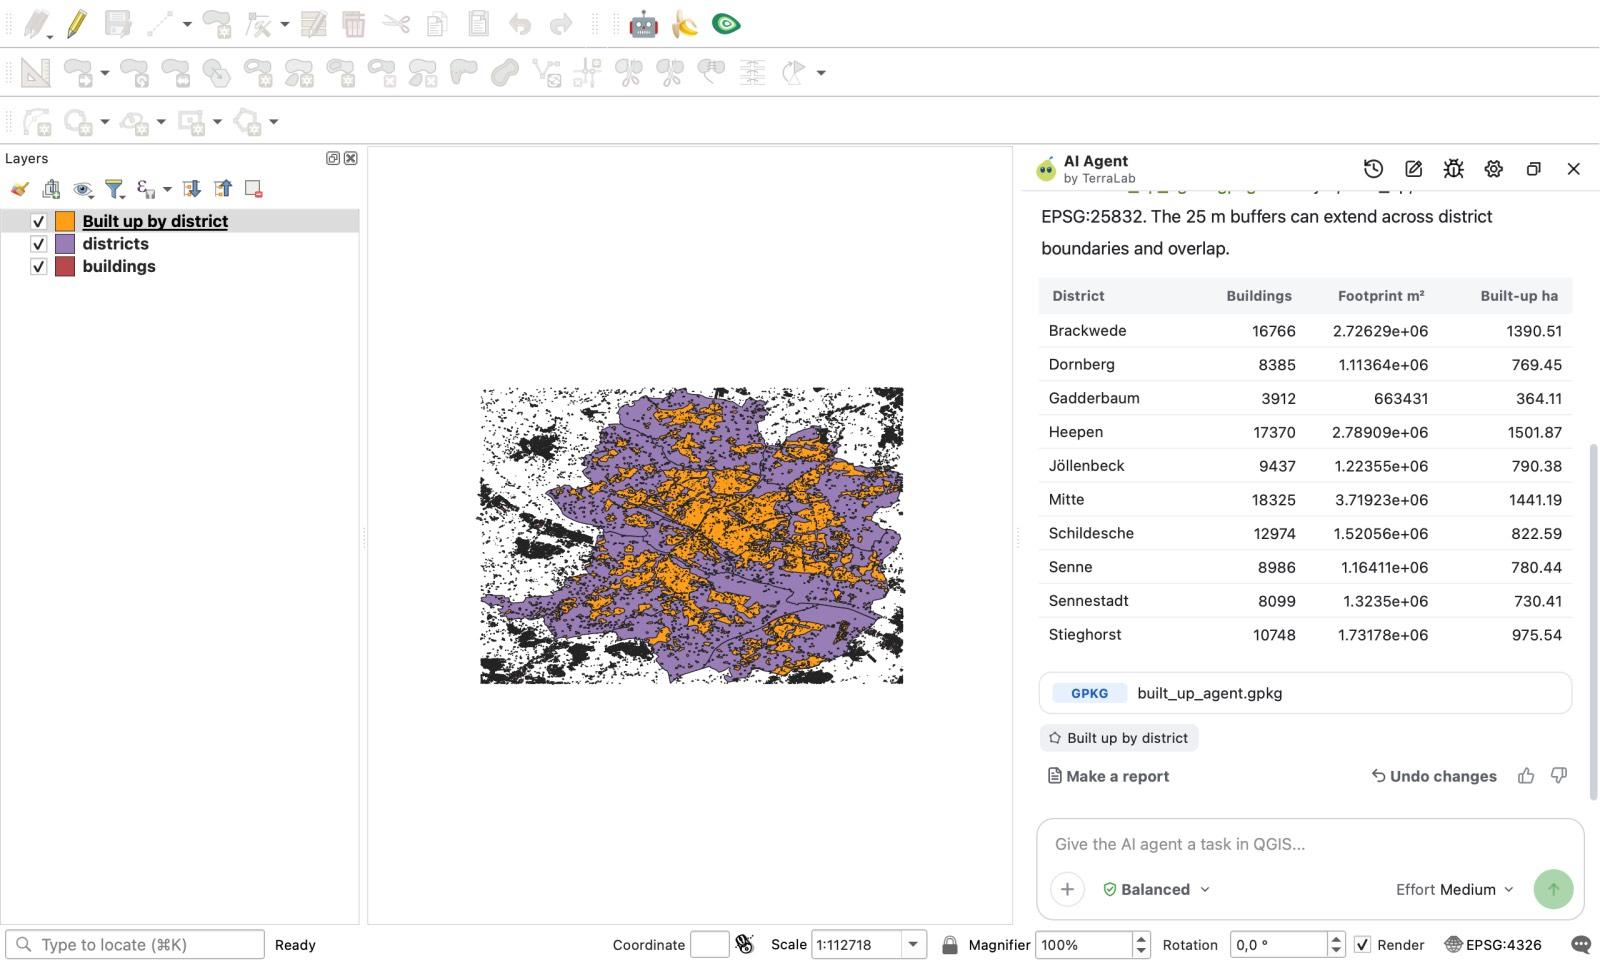
In 110 seconden voerde de agent 27 tool calls uit (12 run_processing, 7 get_algorithm_help, 4 execute_code, 2 get_layer_info, 1 export_layer, 1 get_features), herstelde hij zelf van één interne Processing-fout zonder een toestemmingskaart te tonen, schreef hij de GeoPackage weg en zette hij de tabel met de 10 stadsdelen in de chat. Zonder dat erom gevraagd was, merkte hij in zijn antwoord ook op: "De buffers van 25 m kunnen over stadsdeelgrenzen heen lopen en overlappen."
Daarna sleepte ik muenster_buildings en muenster_districts het project in en typte ik in dezelfde chat een vervolgbericht van 46 woorden:
Now do the same for Münster. I added two layers: "muenster_buildings" and "muenster_districts" (6 districts, the name is in the field "name"). Same fields and same 25 m buffer, in a new GeoPackage at [output folder]/built_up_agent_muenster.gpkg with the layer named built_up. Then show me the result table.
Met de eerste test in dezelfde chat had de agent Münster af in 60 seconden, met 15 tool calls (11 run_processing, 1 export_layer, 1 get_features, 1 zoom_to_layer, 1 execute_code) en zonder fouten.
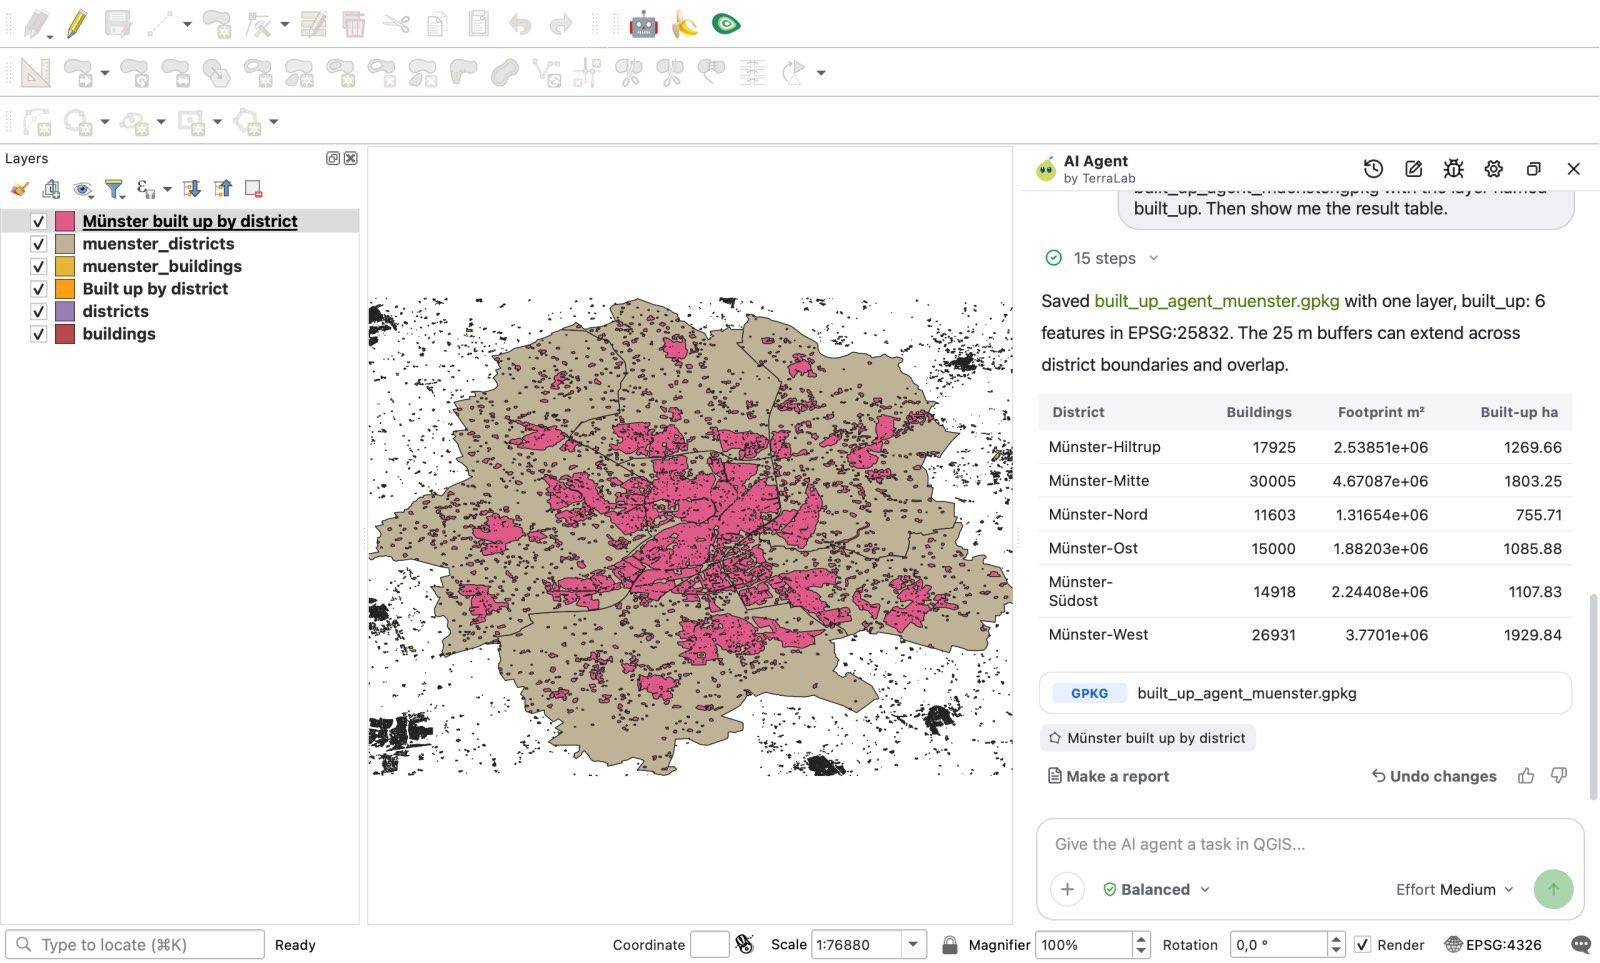
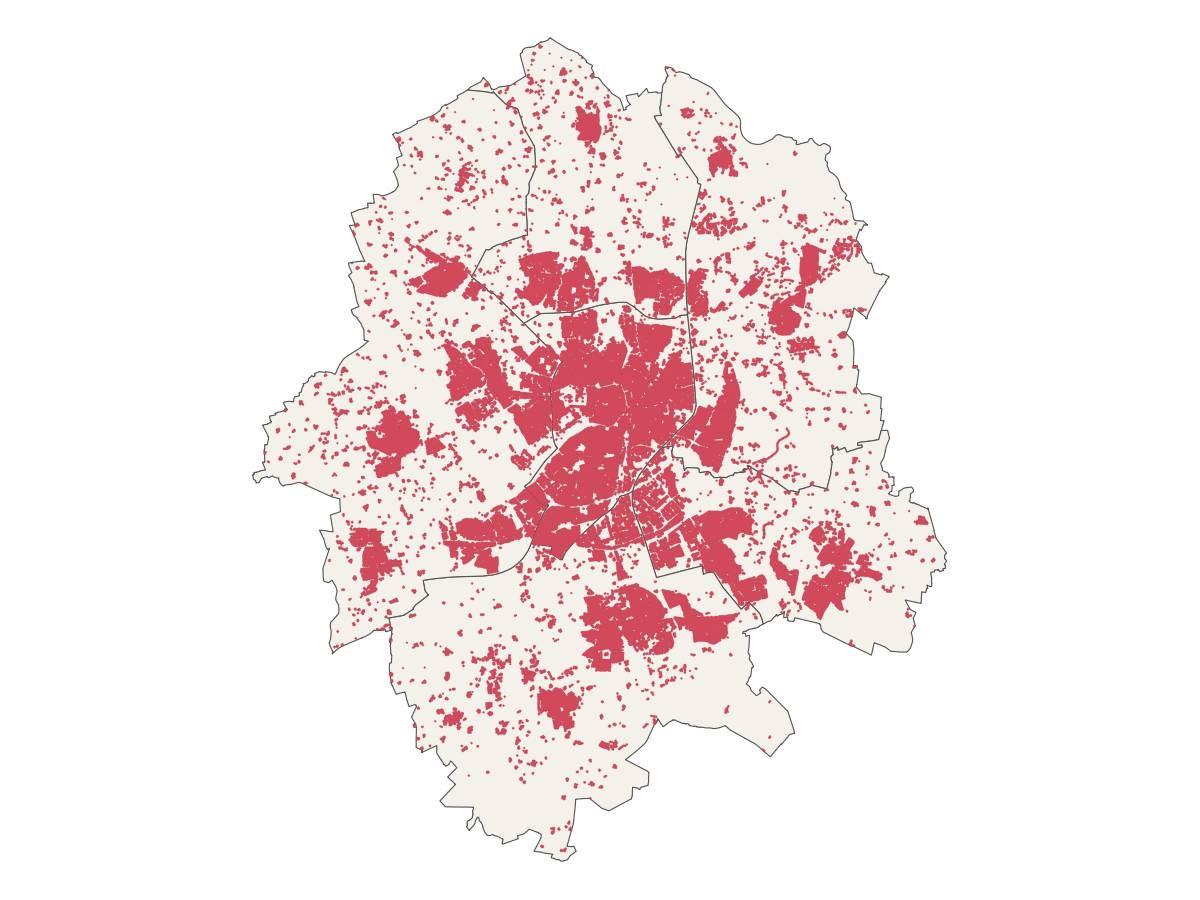
Elk gebouwaantal en elke footprint-oppervlakte kwam op beide steden tot op 0.00% overeen met de referentie.
Waar liggen de grenzen? Ten eerste lagen de built_up_ha-waarden van de agent 0.07% tot 0.21% boven de vlakke referentie (Brackwede kwam bijvoorbeeld uit op 1,390.51 ha tegenover 1,388.31 ha in de referentie; we hebben niet gemeten welke interne stap dat kleine verschil veroorzaakte). Ten tweede hield de geëxporteerde GeoPackage een extra kolom _export_fid. Ten derde, en het belangrijkst voor automatisering: de agent plant zijn stappen bij elk bericht opnieuw (27 tool calls op Bielefeld, 15 op Münster) en draait binnen een open QGIS-sessie, dus hij laat je geen .model3- of .py-bestand na dat je onbeheerd kunt inplannen met cron.
Welke methode voor QGIS-automatisering kies je?
In plaats van één tool tot winnaar uit te roepen, stem je de methode af op hoe vaak je de klus herhaalt:
- Je draait precies dezelfde enkele tool over 10 tot 100 bestanden: gebruik Batch Processing. Het zit in elk Processing-dialoogvenster, kost niets en vraagt geen code. Stop ermee zodra je workflow drie of vier verschillende tools aan elkaar koppelt.
- Jij of je team draait elke maand een keten van meerdere stappen, of volgens een planning op een server: bouw die in de Graphical Modeler. Je krijgt één
.model3-bestand dat je kunt delen met collega's die geen Python schrijven, en dat je headless kunt uitvoeren vanuit een shellscript of geplande taak viaqgis_process. - Je hebt eigen loops nodig, exacte vlakke controle of de hoogste snelheid: schrijf een PyQGIS-script. Ons script van 38 regels was op beide steden 8 tot 9 keer sneller dan de Modeler.
- Je hebt een complexe taak die je vandaag één of twee keer draait, of over een paar projectvarianten: gebruik een AI-agent in QGIS zoals AI Agent (of bekijk ons bredere overzicht op de QGIS AI-hub). Je hoeft niet naar exacte toolnamen te zoeken en herhaalt het op een tweede stad met één zin. Het Free-abonnement geeft 5 taken per maand op Low effort; deze tests liepen op Medium, dat bij Pro hoort (49 EUR / maand excl. btw, 300 taken).
Hoe we dit hebben gemeten. Alle tests liepen op 7 november 2026 op één Apple Silicon Mac (macOS 27.0.1, arm64) in een geïsoleerde sessie van QGIS 3.44.15-Solothurn (Python 3.12.11) met AI Agent 1.9.4 (Medium effort, modus Balanced). De belasting van de machine wisselde gedurende de dag, dus vergelijk de tijden als ordes van grootte, niet als CPU-benchmarks. We maten de uitvoeringstijd op de klok van de machine en het aantal stappen, niet de minuten die een GIS-analist nodig heeft om vanaf nul een model in elkaar te klikken of een script te schrijven. Alle invoer, het .model3-bestand, de .py-scripts, het controlescript en de ruwe JSON-logs staan in ons experimentarchief.
Veelgestelde vragen
Hoe automatiseer ik een terugkerende workflow in QGIS?
Je hebt vier hoofdopties, afhankelijk van hoe vaak de klus terugkomt. Voor één tool over veel bestanden klik je op Run as Batch Process in het dialoogvenster van de tool. Voor een keten van meerdere stappen die je regelmatig opnieuw draait, koppel je de tools in Processing > Graphical Modeler en sla je een .model3-bestand op. Voor loops en de snelste prestaties schrijf je een Python-script met processing.run() in de QGIS Python Console. Voor eenmalige of incidentele analyses waarbij je geen nodes wilt koppelen of code wilt schrijven, beschrijf je de workflow in gewone woorden in een agent-plugin zoals AI Agent.
Gebruik ik de QGIS Graphical Modeler of Python (PyQGIS)?
Gebruik de Graphical Modeler als je workflow een rechte keten van Processing-algoritmen is en je een visueel .model3-bestand wilt dat niet-programmeurs in je team kunnen openen, of dat je vanaf de opdrachtregel kunt draaien met qgis_process. Gebruik PyQGIS als je over features moet loopen, tussenlagen in het geheugen wilt houden (het script draaide in 8,1 s tegenover 62,7 s voor het model in onze test op Bielefeld), fouten in code wilt afhandelen of de uitvoerschema's expliciet wilt bepalen.
Kan ik een QGIS Graphical Model exporteren naar een Python-script?
Ja. De Graphical Modeler kan een model exporteren als Python Processing-script (Export as Script Algorithm), dat je daarna kunt aanpassen om loops, variabelen of eigen logica toe te voegen. We hebben de export in deze vergelijking niet getest.
Kan QGIS geautomatiseerde workflows volgens een planning draaien zonder de app te openen?
Ja. QGIS wordt geleverd met een opdrachtregelhulpmiddel genaamd qgis_process. Je kunt het elk ingebouwd algoritme of elk opgeslagen .model3-bestand meegeven (bijvoorbeeld qgis_process run model3 --BUILDINGS=... --DISTRICTS=... --built_up=...) vanuit een bashscript, Windows Taakplanner of een cron-job, zonder de grafische interface van QGIS te starten. In onze test op Bielefeld draaide het model headless via qgis_process in 44,5 seconden.
Verder lezenWat is PyQGIS? QGIS automatiseren met of zonder code
Doe het in QGIS door erom te vragen
AI Agent voert de taak uit die je beschrijft, in je eigen QGIS-project. Gratis, geen kaart nodig.