Como automatizar o QGIS: 4 métodos testados em 2 cidades
Publicado em
Dá para automatizar um fluxo repetitivo no QGIS de quatro jeitos: o processamento em lote (Batch Processing) para uma ferramenta em muitos arquivos, o Graphical Modeler (modelador gráfico) para uma cadeia de ferramentas que você vai rodar de novo, um script PyQGIS para loops e controle exato, ou um agente de IA dentro do QGIS quando você quer o resultado a partir de uma única mensagem em linguagem simples.
 de quatro jeitos: o processamento em lote (Batch Processing) para uma ferramenta em muitos arquivos, o Graphical Modeler (modelador gráfico) para uma cadeia de ferramentas que você vai rodar de novo, um script
Os tutoriais que li ensinam um desses quatro de forma isolada, num exemplo de brinquedo, e nenhum testa o que acontece quando você roda o fluxo uma segunda vez numa cidade nova. Em 7 de novembro de 2026, peguei uma tarefa de várias etapas (área construída por distrito a partir de 180.602 edificações do OpenStreetMap em Bielefeld, Alemanha), executei com os quatro métodos no QGIS 3.44.15 e depois refiz os quatro em Münster (135.577 edificações, 6 distritos). Todos os métodos passaram nas duas cidades, embora uma execução do Graphical Modeler tenha terminado primeiro com "OK" enquanto gravava 1.058 polígonos em vez de 10.
8.1s
Script PyQGIS em Bielefeld (7,4 s em Münster)
62.7s
Graphical Modeler no QGIS (44,5 s sem interface)
60s
AI Agent refazendo Münster a partir de 1 frase
1,058linhas
Gravadas em vez de 10 por um erro silencioso no modelo
O que é automação no QGIS?
Automatizar o QGIS significa rodar uma ferramenta de processamento, ou uma cadeia de ferramentas, sobre várias camadas sem clicar em cada janela à mão. Por baixo de todos os métodos está o framework Processing do QGIS, o mesmo motor da Processing Toolbox (caixa de ferramentas de processamento). Como as ferramentas são idênticas, seja numa tabela de lote, num diagrama do Graphical Modeler, num script Python ou na ferramenta de linha de comando qgis_process, escolher um método de automação é, na prática, escolher como ligar essas ferramentas entre si e qual arquivo você quer deixar no disco para o mês que vem.
A tarefa e os dados do teste
Escolhi um trabalho que aparece o tempo todo em planejamento urbano e consultoria: para cada distrito da cidade, recortar as edificações pelo limite do distrito, contar as edificações, somar a área delas em metros quadrados, aplicar um buffer de 25 m nas edificações recortadas e dissolvê-las num único polígono de área construída, e salvar um GeoPackage limpo com uma linha por distrito.
Se uma edificação cruza o limite entre distritos, ela é recortada e contada uma vez em cada distrito que toca. As duas cidades usam dados do OpenStreetMap de extrações PBF do BBBike (ODbL, colaboradores do OpenStreetMap), reprojetados para EPSG:25832 (ETRS89 / UTM zona 32N) em todas as medições.
- Cidade 1, Bielefeld: 180.602 polígonos de edificações em 10 distritos (
admin_level=9), gerando 115.002 pedaços de edificação recortados. Duas edificações brutas do OSM tinham geometrias inválidas e foram corrigidas uma vez com Fix geometries, para que os quatro métodos partissem dos mesmos arquivos limpos. - Cidade 2, Münster (a nova execução): 135.577 polígonos de edificações em 6 distritos, gerando 116.382 pedaços recortados.
Antes de rodar qualquer um dos quatro métodos, escrevi uma referência independente com chamadas simples de geometria em PyQGIS (QgsSpatialIndex, geometry.intersection(), unaryUnion() e buffer(25, 5), sem chamar algoritmos do Processing) e salvei um script verificador. Um método só passava se gerasse um GeoPackage com uma camada de polígonos built_up em EPSG:25832, contagens exatas de edificações por distrito, área das edificações a até 0,5% da referência, hectares construídos a até 1% e nenhuma edição manual depois.
Método 1: processamento em lote (Batch Processing)
Toda ferramenta da Processing Toolbox tem um botão Run as Batch Process (Executar como processo em lote) no canto inferior esquerdo da janela. Ele transforma a janela numa planilha em que cada linha é uma execução daquela ferramenta.
Na nossa tarefa, o processamento em lote resolve bem o Clip por distrito e o Buffer por distrito, porque essas duas etapas repetem exatamente o mesmo algoritmo nos 10 distritos. Mas ele não faz o fluxo inteiro de uma vez, porque o Batch Processing roda uma ferramenta por vez e deixa você com 10 camadas de saída separadas que ainda precisam ser mescladas e unidas de novo.
Reprojetar e dividir as entradas
Rode Reproject layer (Vector general) nas edificações para EPSG:25832. Depois rode Split vector layer (Vector general) na camada de distritos usando o campo name, que grava um GeoPackage por distrito numa pasta.
Rodar o Clip em lote em todos os distritos
Abra Clip (Vector overlay), clique em Run as Batch Process e adicione uma linha por arquivo de distrito. Defina as edificações reprojetadas como Input layer, use o Autofill para preencher as camadas de sobreposição dos distritos e os nomes das tabelas de saída (clip_<district>) e desmarque Load layers on completion. Em Bielefeld, as 10 linhas terminaram em 13,7 s (de 1,0 a 4,2 s por distrito).
Rodar o Buffer em lote com o Dissolve ativado
Abra Buffer (Vector geometry) em modo lote: uma linha por camada recortada, Distance 25, Segments 5 e Dissolve result marcado. Os 10 buffers de Bielefeld rodaram em 27,7 s.
Mesclar, agregar e juntar a tabela de novo
Rode Merge vector layers duas vezes (uma nas 10 camadas de clip, outra nas 10 camadas de buffer). Rode Aggregate (Vector geometry) nos clips mesclados, agrupando pelo campo layer, para obter building_count (count($id)) e building_area_m2 (sum(area($geometry))). Rode Refactor fields (Vector table) nos buffers mesclados para calcular built_up_ha com a expressão da calculadora de campo $area / 10000 e, por fim, Join attributes by field value (Vector general) em district para gerar a camada de saída única.
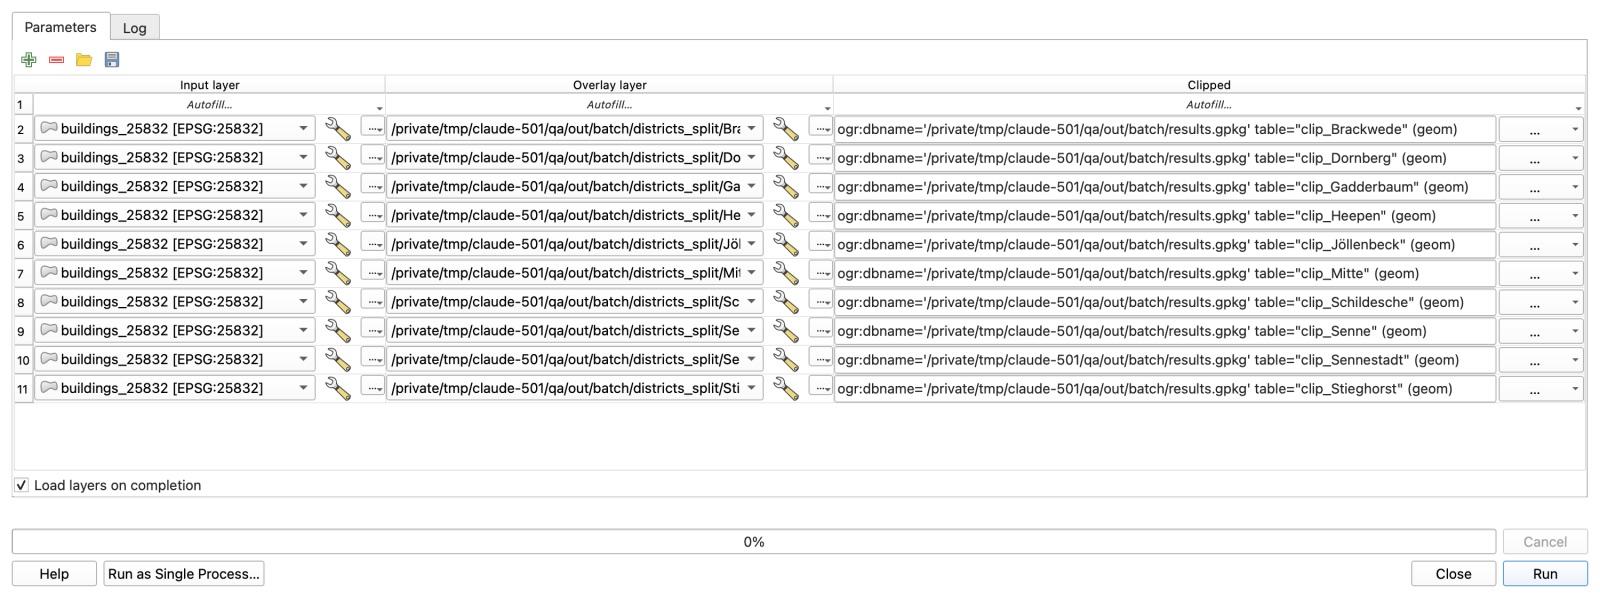
Nas 9 execuções (8 algoritmos diferentes), o tempo total das ferramentas em Bielefeld foi de 62,0 segundos, e todas as contagens por distrito bateram com a referência. Em Münster, o tempo das ferramentas caiu para 39,8 segundos para 6 distritos, mas tive de refazer as tabelas de lote de 6 linhas e rodar de novo as 9 etapas à mão. Quando o seu fluxo é uma cadeia de ferramentas diferentes, e não uma ferramenta repetida em 50 arquivos, o Batch Processing não é o formato certo.
Método 2: o Graphical Modeler
O Graphical Modeler (Processing > Graphical Modeler) permite ligar uma cadeia de ferramentas do Processing num único diagrama e salvá-lo como um arquivo .model3. Depois de pronto, o modelo aparece na sua Processing Toolbox como qualquer ferramenta nativa.
Você talvez espere precisar de um loop sobre os distritos dentro do Modeler, mas não precisa. Rodando primeiro uma Intersection entre edificações e distritos, cada pedaço de edificação herda o atributo name do seu distrito, e assim Aggregate e Dissolve agrupados por name geram uma linha por distrito numa única passada. (Você também poderia usar uma junção espacial se não precisasse dividir as edificações exatamente na linha do distrito.)
Adicionar as três entradas do modelo
Num modelo novo, adicione duas entradas Vector Layer (Polygons) chamadas Buildings e Districts, e uma entrada Number chamada Buffer distance (m) com valor padrão 25.
Reprojetar as duas entradas e fazer a interseção
Adicione dois nós Reproject layer com destino EPSG:25832. Ligue os dois a um nó Intersection (Buildings como Input, Districts como Overlay). Em Input fields to keep da Intersection, limite os campos das edificações a osm_id, e em Overlay fields to keep, mantenha name.
Separar em Aggregate para as contagens e Dissolve + Buffer para a geometria
A partir da Intersection, ligue um ramo a Aggregate agrupado por name para calcular count($id) e sum(area($geometry)). Ligue um segundo ramo da Intersection a Dissolve (campo name) seguido de Buffer (vinculado à entrada Buffer distance (m), 5 segmentos).
Juntar os ramos e formatar a tabela de saída
Adicione Join attributes by field value para anexar a tabela do Aggregate aos polígonos com buffer por name e depois Refactor fields para renomear name para district e calcular built_up_ha como $area / 10000. Marque a saída como built_up e salve o modelo como built_up_by_district.model3.
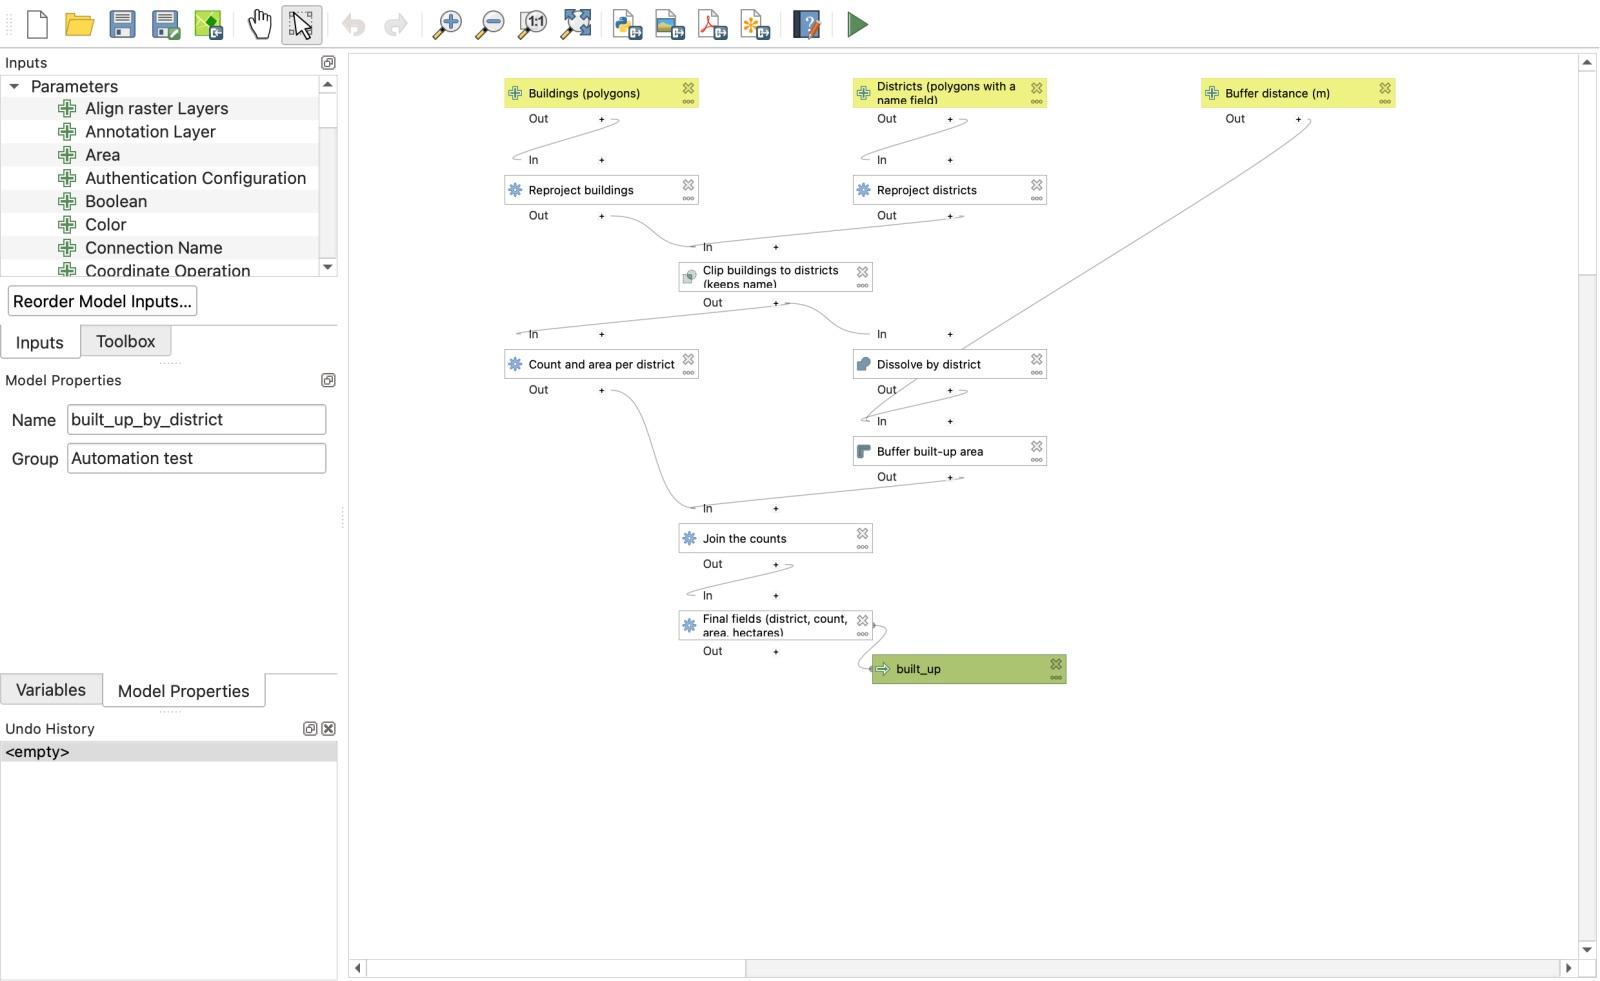
Rodar o modelo pela janela dele em Bielefeld levou 62,7 segundos e passou em todas as verificações. Melhor ainda, o mesmo arquivo .model3 rodou pelo terminal do macOS, sem abrir nenhuma janela do QGIS, via qgis_process em 44,5 segundos.
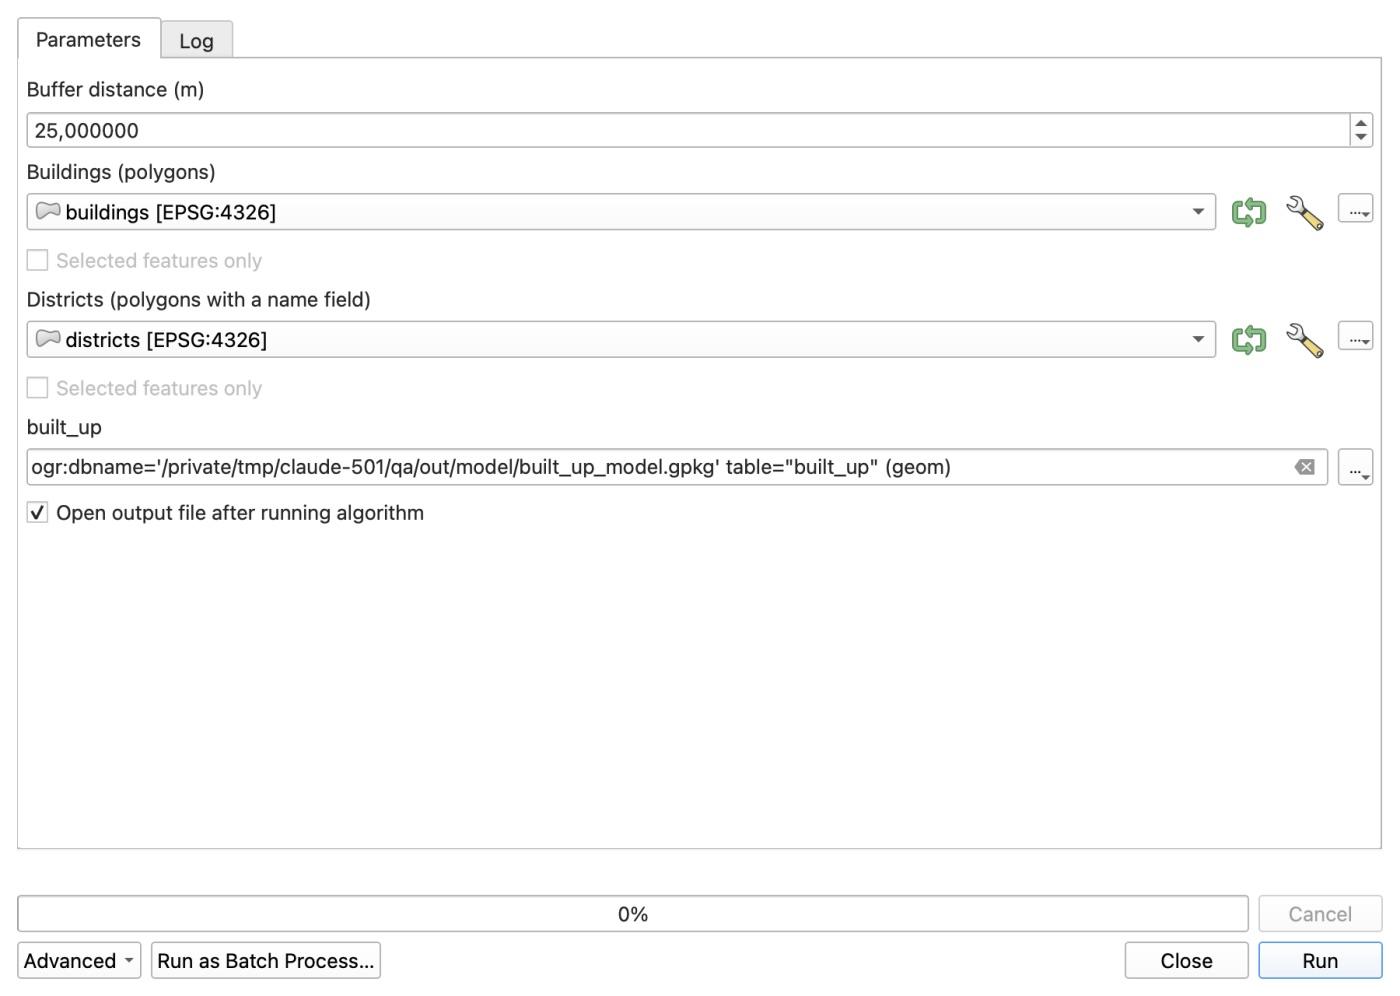
O ganho real apareceu na nova execução em Münster. Abri a mesma janela do modelo, selecionei muenster_buildings e muenster_districts nas duas listas suspensas e cliquei em Run. Terminou em 67,2 segundos, sem nenhuma edição no modelo.
Método 3: um script PyQGIS no Python Console
Se você se sente à vontade com Python, um script em Plugins > Python Console > Show Editor oferece um loop for de verdade, as entradas como variáveis no topo do arquivo e nenhuma etapa de mesclagem.
Este é o script de 38 linhas (built_up_by_district.py) que rodei no QGIS 3.44.15, com os caminhos de arquivo encurtados:
# Built-up area by district. Run in the QGIS Python console (Plugins > Python Console > Show Editor > Run).
# Change the first five lines for a new city.
BUILDINGS = "data/bielefeld_buildings.gpkg"
DISTRICTS = "data/bielefeld_districts.gpkg"
NAME_FIELD = "name"
BUFFER_M = 25
OUT = "out/script/built_up_script.gpkg"

import processing
from qgis.core import (QgsVectorLayer, QgsCoordinateReferenceSystem, QgsFeature, QgsField, QgsFields, QgsGeometry)
from qgis.PyQt.QtCore import QVariant

crs = QgsCoordinateReferenceSystem("EPSG:25832")   # metric, Germany
def run(alg, **p):
    return processing.run(alg, p)["OUTPUT"]

buildings = run("native:reprojectlayer", INPUT=BUILDINGS, TARGET_CRS=crs, OUTPUT="memory:")
districts = run("native:reprojectlayer", INPUT=DISTRICTS, TARGET_CRS=crs, OUTPUT="memory:")

result = QgsVectorLayer("MultiPolygon?crs=EPSG:25832", "built_up", "memory")
result.dataProvider().addAttributes([QgsField("district", QVariant.String), QgsField("building_count", QVariant.Int),
                                     QgsField("building_area_m2", QVariant.Double), QgsField("built_up_ha", QVariant.Double)])
result.updateFields()

for d in districts.getFeatures():
    one = run("native:extractbyexpression", INPUT=districts, EXPRESSION=f"$id = {d.id()}", OUTPUT="memory:")
    clipped = run("native:clip", INPUT=buildings, OVERLAY=one, OUTPUT="memory:")
    area = sum(f.geometry().area() for f in clipped.getFeatures())
    built_up = run("native:buffer", INPUT=clipped, DISTANCE=BUFFER_M, SEGMENTS=5, DISSOLVE=True, OUTPUT="memory:")
    geom = next(built_up.getFeatures()).geometry()
    f = QgsFeature(result.fields())
    f.setGeometry(geom)
    f.setAttributes([d[NAME_FIELD], clipped.featureCount(), area, geom.area() / 10000])
    result.dataProvider().addFeature(f)
    print(d[NAME_FIELD], clipped.featureCount(), round(area), round(geom.area() / 10000, 1))

processing.run("native:savefeatures", {"INPUT": result, "OUTPUT": OUT, "LAYER_NAME": "built_up"})
print("saved", OUT)
O script mantém todas as camadas intermediárias na memória e faz um loop pelos distritos, e foi de longe o método mais rápido (não investigamos o porquê). Terminou Bielefeld em 8,1 segundos e bateu com a referência independente em 0.00% em todos os distritos.
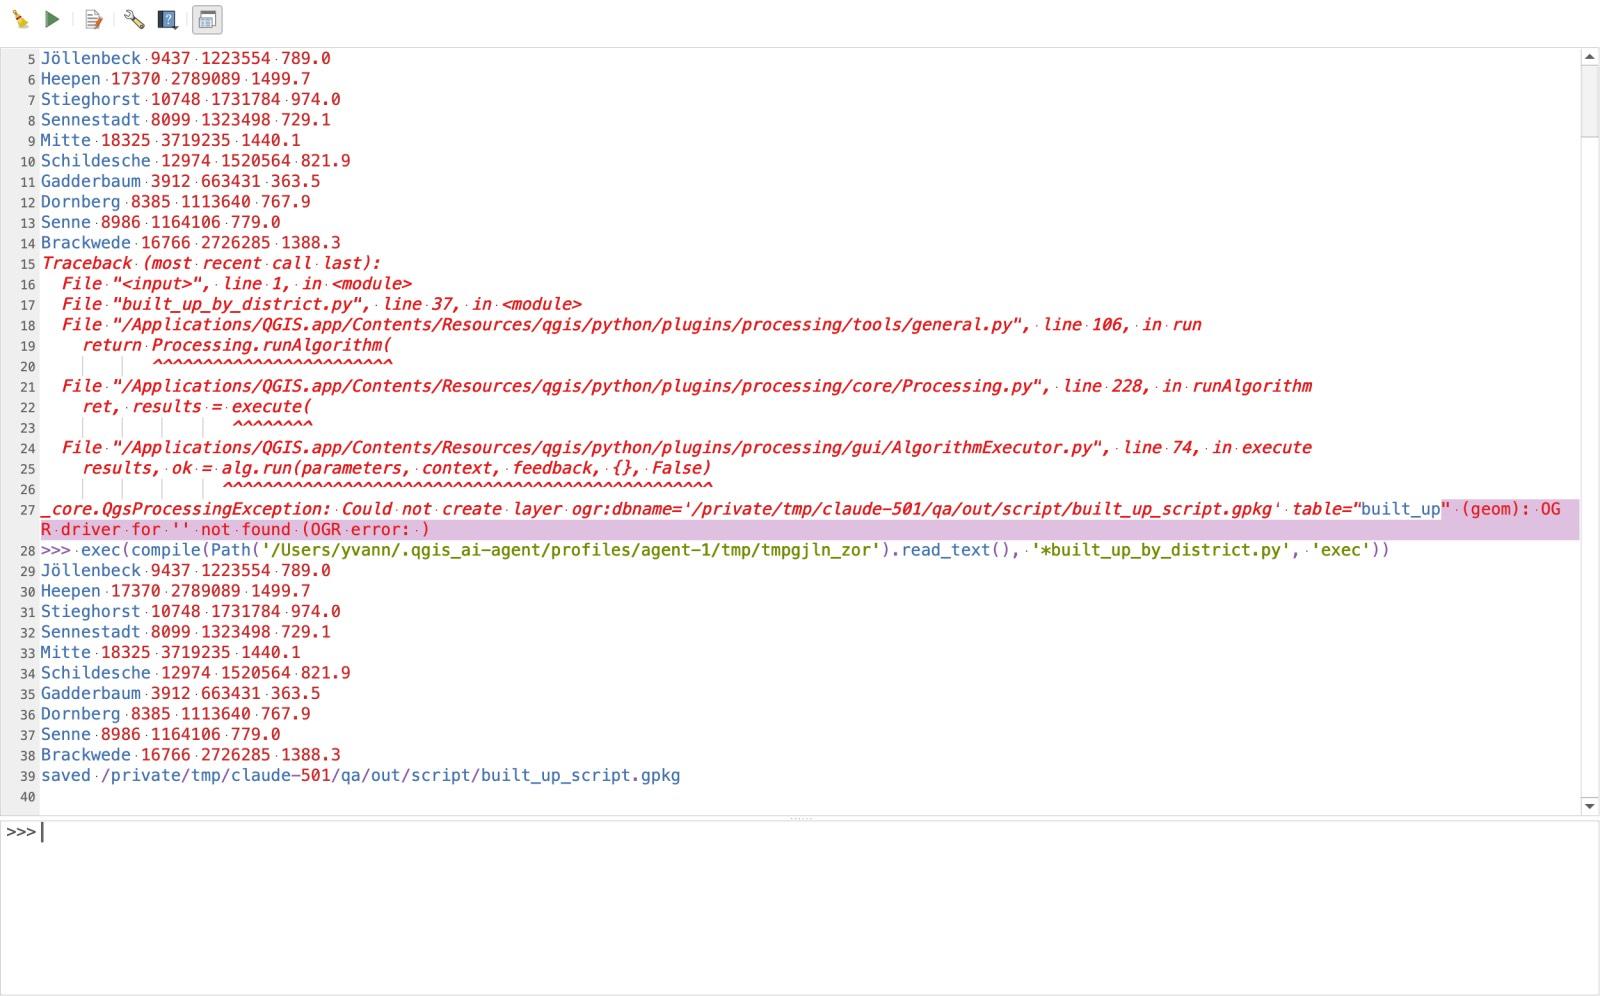
Para rodar de novo em Münster, mudei três linhas no topo (BUILDINGS, DISTRICTS e OUT) e cliquei no botão verde Run Script. Terminou em 7,4 segundos. Se quiser entender em detalhe como funciona o processing.run, veja nosso guia de PyQGIS.
Como os quatro métodos se compararam nas duas cidades
Isto é o que medimos nos quatro métodos em 7 de novembro de 2026:
| Batch Processing | Graphical Modeler | Script PyQGIS | AI Agent (Medium, Balanced) | |
|---|---|---|---|---|
| Montagem / estrutura | 9 execuções em 8 algoritmos (2 tabelas de lote de 10 linhas) | 3 entradas + 8 nós de algoritmo + 1 saída | 38 linhas de Python, 5 algoritmos | 1 mensagem em linguagem simples (27 chamadas de ferramenta do agente) |
| Tempo em Bielefeld (10 distritos) | 62,0 s de tempo de ferramenta (iniciadas uma a uma) | 62,7 s na janela (44,5 s via qgis_process) | 8,1 s (depois de corrigir 1 chamada de salvamento com falha) | 110 s do envio até a tabela de resposta |
| Nova execução em Münster (6 distritos) | 39,8 s de tempo de ferramenta (refazer as linhas de lote e as 9 execuções) | 67,2 s (escolher 2 camadas novas, clicar em Run) | 7,4 s (mudar 3 linhas de caminho, clicar em Run) | 60 s (1 mensagem de acompanhamento de 46 palavras, 15 chamadas de ferramenta) |
Maior diferença vs referência (built_up_ha) | +0,08% | +0,08% | 0,00% | +0,21% |
| O que fica depois | ~20 camadas intermediárias | Um arquivo .model3 (roda na interface ou sem ela) | Um arquivo de script .py | O histórico do chat e o texto do seu prompt |
Todos os métodos bateram com a referência nas contagens de edificações e nas áreas das edificações (building_area_m2) em 0.00%. A diferença de +0.08% em built_up_ha no Batch Processing e no Graphical Modeler vem do $area no Refactor fields, que mede no elipsoide do projeto, enquanto o script e a referência usaram o geometry().area() planar em EPSG:25832.
O que quebrou no caminho (incluindo uma resposta errada silenciosa)
Os tutoriais raramente mostram as execuções que falham, então registrei todos os erros do dia. A falha mais assustadora não foi um travamento nem um aviso de erro vermelho: foi uma execução do Graphical Modeler que informou sucesso e entregou a saída errada.
Quando rodei o modelo sem interface pela primeira vez, antes de limitar os campos no nó Intersection, o log mostrou:
Model processed OK. Executed 8 algorithm(s) total in 84.548 s.
Nenhum erro, nenhum aviso. Quando conferi o GeoPackage de saída, built_up tinha 1.058 polígonos em vez de 10.
O motivo: as edificações do OpenStreetMap têm a própria coluna name (o nome de uma loja, escola ou igreja), e a camada de distritos também tem uma coluna name. Quando a Intersection juntou todos os campos das duas camadas, o name das edificações continuou name e o name do distrito foi renomeado em silêncio para name_2. Mais adiante, Aggregate e Dissolve agruparam por name, ou seja, pelos nomes das edificações em vez dos distritos! Limitar Input fields to keep da Intersection a osm_id evitou a colisão e trouxe a saída de volta aos 10 distritos.
Três outras coisas quebraram e vale conhecê-las antes de automatizar seus próprios dados:
- Geometrias inválidas do OSM param o Processing por padrão. Duas das 180.602 edificações de Bielefeld tinham anéis com autointerseção. Com a configuração padrão do QGIS, o Clip para na hora com
Feature (18818404) from 'b' has invalid geometry. Rode Fix geometries como primeira etapa sempre que a entrada vier do OpenStreetMap bruto. - O
savefeaturesno PyQGIS não se dá bem com strings de conexão do GDAL. Na minha primeira execução do script (10,0 s), passarogr:dbname='...' table="built_up"paranative:savefeaturesgerouOGR driver for '' not found. Passe o caminho.gpkgsimples emOUTPUTe definaLAYER_NAME: "built_up"como parâmetro separado. - Carregar muitas camadas intermediárias derrubou nossa sessão. O QGIS travou (
SIGSEGV) três vezes enquanto as saídas do Processing eram carregadas no painel de camadas com Load layers on completion marcado. Desmarcar essa opção nas linhas intermediárias do lote acabou com os travamentos.
Método 4: pedir a um agente de IA dentro do QGIS
Nós desenvolvemos o AI Agent, então esta seção fala do nosso próprio plugin. Ele abre um painel de chat dentro do QGIS, inspeciona as camadas e os campos que já estão no seu projeto, chama ferramentas do Processing e o PyQGIS por conta própria e confere a saída antes de responder.
Para um trabalho pontual ou um projeto com duas cidades, montar um modelo gráfico de 8 nós ou depurar um script de 38 linhas costuma ser mais preparação do que a tarefa merece. Abri um projeto com as camadas buildings e districts de Bielefeld, configurei o painel com esforço Medium e permissões Balanced e enviei uma mensagem:
The project has two layers: "buildings" (OSM buildings of Bielefeld, Germany) and "districts" (its 10 city districts, the district name is in the field "name"). For each district: clip the buildings to the district, count the buildings, sum their footprint area in square meters, and build a 25 m buffer around the clipped buildings, dissolved into one built-up polygon, with its area in hectares. Measure in a metric CRS (EPSG:25832). Write one GeoPackage at [output folder]/built_up_agent.gpkg with a single polygon layer named built_up, one feature per district, fields district, building_count, building_area_m2, built_up_ha, in EPSG:25832. Then show me the result table.
(Caminhos de saída encurtados nos dois prompts. Nota de transparência: na primeiríssima tentativa, o QGIS travou 9 segundos depois que cliquei em Send, com uma falha de segmentação num slot do Qt, antes de qualquer resposta. Reabri o projeto, enviei exatamente o mesmo prompt uma vez e não reenviei depois disso.)
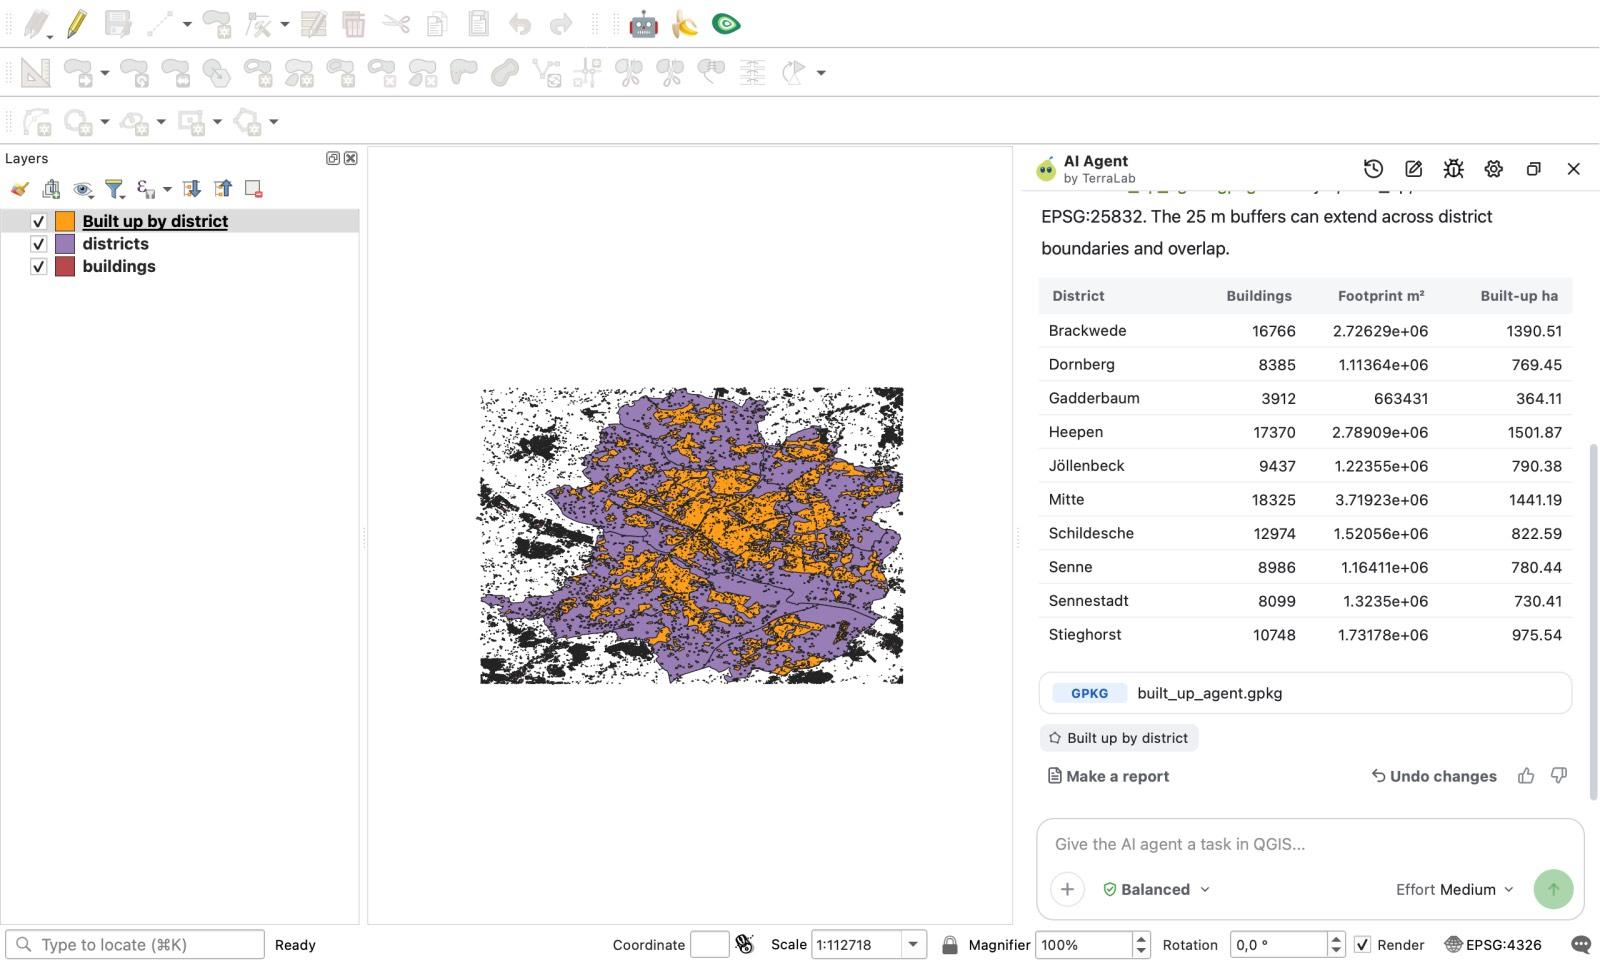
Em 110 segundos, o agente fez 27 chamadas de ferramenta (12 run_processing, 7 get_algorithm_help, 4 execute_code, 2 get_layer_info, 1 export_layer, 1 get_features), se recuperou sozinho de um erro interno do Processing sem mostrar nenhum cartão de permissão, gravou o GeoPackage e exibiu a tabela dos 10 distritos no chat. Sem que eu pedisse, ainda observou na resposta: "Os buffers de 25 m podem ultrapassar os limites dos distritos e se sobrepor."
Depois arrastei muenster_buildings e muenster_districts para o projeto e digitei uma mensagem de acompanhamento de 46 palavras no mesmo chat:
Now do the same for Münster. I added two layers: "muenster_buildings" and "muenster_districts" (6 districts, the name is in the field "name"). Same fields and same 25 m buffer, in a new GeoPackage at [output folder]/built_up_agent_muenster.gpkg with the layer named built_up. Then show me the result table.
Com o primeiro teste no mesmo chat, o agente terminou Münster em 60 segundos com 15 chamadas de ferramenta (11 run_processing, 1 export_layer, 1 get_features, 1 zoom_to_layer, 1 execute_code) e nenhum erro.
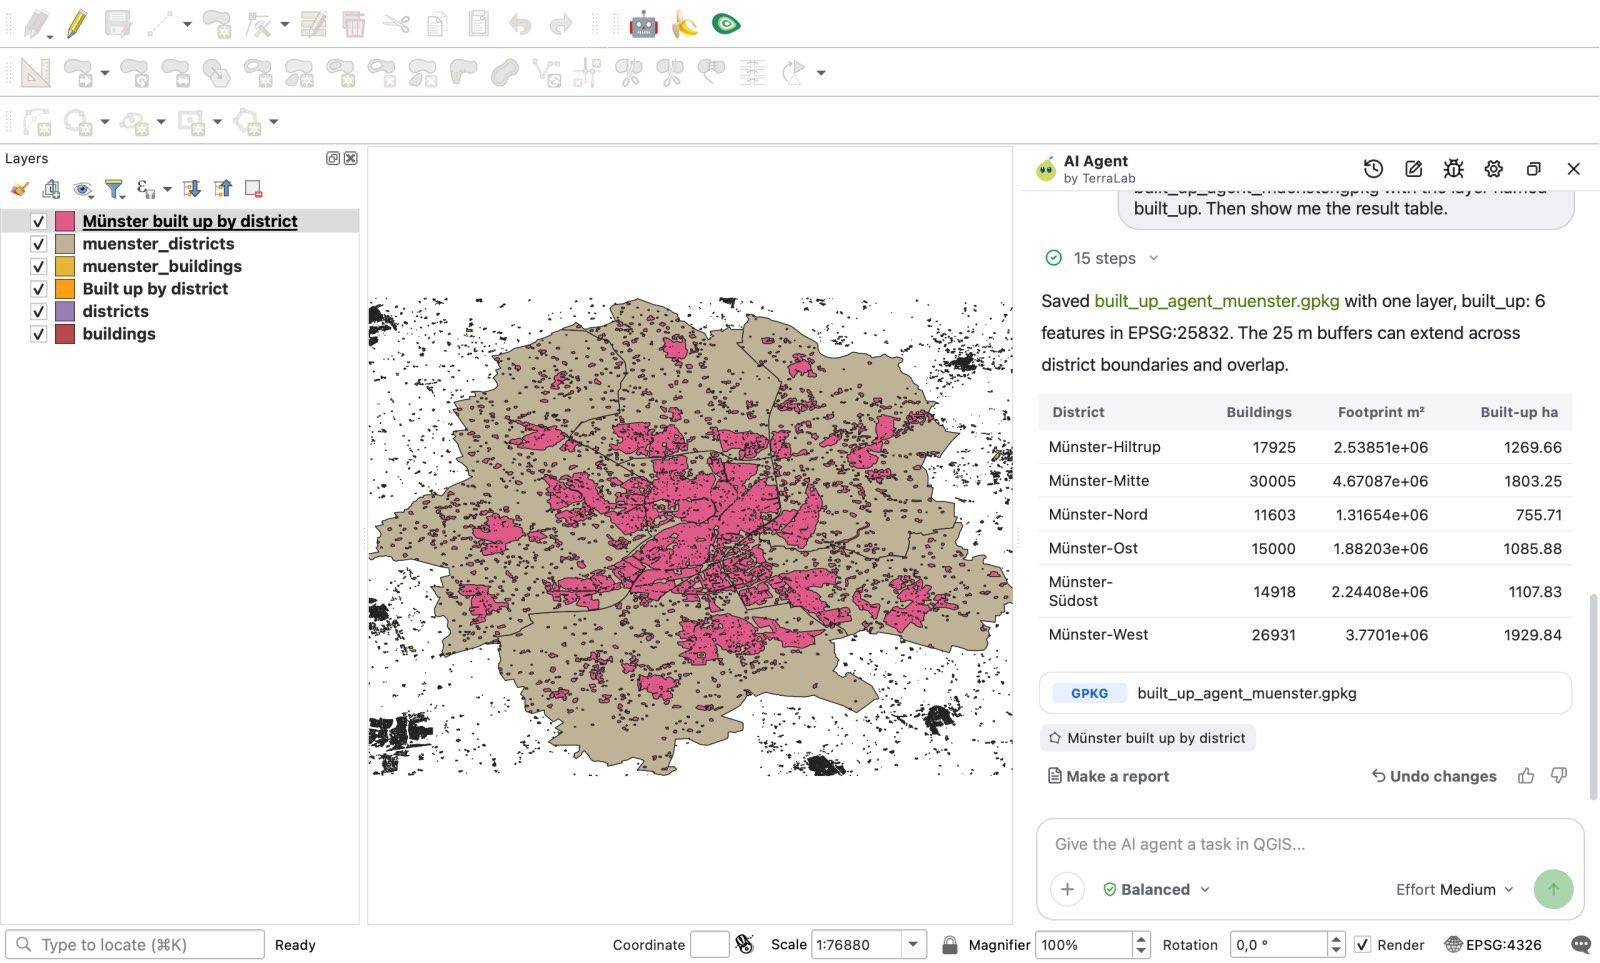
Todas as contagens de edificações e áreas das edificações bateram com a referência em 0.00% nas duas cidades.
E os limites? Primeiro, os valores de built_up_ha do agente ficaram de 0.07% a 0.21% acima da referência planar (por exemplo, Brackwede saiu com 1,390.51 ha contra 1,388.31 ha na referência; não medimos qual etapa interna causou essa pequena diferença). Segundo, o GeoPackage exportado manteve uma coluna extra _export_fid. Terceiro, e o mais importante para automação: o agente planeja as etapas do zero a cada mensagem (27 chamadas de ferramenta em Bielefeld, 15 em Münster) e roda dentro de uma sessão aberta do QGIS, então não deixa um arquivo .model3 ou .py que você possa agendar sem supervisão com cron.
Qual método de automação do QGIS escolher?
Em vez de eleger uma ferramenta vencedora, escolha o método conforme a frequência com que você vai repetir o trabalho:
- Você roda exatamente a mesma ferramenta em 10 a 100 arquivos: use o Batch Processing. Ele já vem em toda janela do Processing, não custa nada e não exige código. Pare de usá-lo assim que o seu fluxo encadear três ou quatro ferramentas diferentes.
- Você ou sua equipe vão rodar uma cadeia de várias etapas todo mês, ou num agendamento em servidor: monte no Graphical Modeler. Você ganha um único arquivo
.model3que pode compartilhar com colegas que não escrevem Python e pode executá-lo sem interface a partir de um script de shell ou de uma tarefa agendada viaqgis_process. - Você precisa de loops personalizados, controle planar exato ou a execução mais rápida: escreva um script PyQGIS. Nosso script de 38 linhas rodou de 8 a 9 vezes mais rápido que o Modeler nas duas cidades.
- Você tem uma tarefa complexa para rodar uma ou duas vezes, ou em algumas variações de projeto hoje: use um agente de IA dentro do QGIS como o AI Agent (ou veja nossa visão geral mais ampla no hub de IA para QGIS). Você não precisa caçar o nome exato das ferramentas e refaz o trabalho numa segunda cidade com uma frase. O plano Free dá 5 tarefas por mês em esforço Low; estes testes rodaram em Medium, que vem com o Pro (49 EUR / mês sem impostos, 300 tarefas).
Como medimos. Todos os testes rodaram em 7 de novembro de 2026 num Mac com Apple Silicon (macOS 27.0.1, arm64), numa sessão isolada do QGIS 3.44.15-Solothurn (Python 3.12.11) com o AI Agent 1.9.4 (esforço Medium, modo Balanced). A carga da máquina variou ao longo do dia, então compare os tempos como ordens de grandeza, não como benchmarks de CPU. Medimos o tempo real de execução na máquina e o número de etapas, não os minutos que um analista de SIG leva para montar um modelo ou escrever um script do zero. Todas as entradas, o arquivo .model3, os scripts .py, o verificador de referência e os logs JSON brutos estão guardados no nosso arquivo do experimento.
Perguntas frequentes
Como automatizar um fluxo de trabalho repetitivo no QGIS?
Você tem quatro opções principais, conforme a frequência com que o trabalho se repete. Para uma única ferramenta em muitos arquivos, clique em Run as Batch Process na janela da ferramenta. Para uma cadeia de várias etapas que você vai rodar com frequência, ligue as ferramentas em Processing > Graphical Modeler e salve um arquivo .model3. Para loops e o melhor desempenho, escreva um script Python com processing.run() no Python Console do QGIS. Para análises pontuais ou de poucas vezes, em que você não quer ligar nós nem escrever código, descreva o fluxo em palavras simples num plugin de agente como o AI Agent.
Devo usar o Graphical Modeler do QGIS ou Python (PyQGIS)?
Use o Graphical Modeler quando o seu fluxo for uma cadeia direta de algoritmos do Processing e você quiser um arquivo .model3 visual que colegas que não programam possam abrir, ou que você possa rodar pela linha de comando com qgis_process. Use o PyQGIS quando precisar fazer loops sobre feições, manter camadas intermediárias na memória (o script rodou em 8,1 s contra 62,7 s do modelo no nosso teste em Bielefeld), tratar erros no código ou controlar explicitamente o esquema da saída.
Dá para exportar um modelo gráfico do QGIS para um script Python?
Sim. O Graphical Modeler pode exportar um modelo como script Python do Processing (Export as Script Algorithm), que você pode editar depois para adicionar loops, variáveis ou lógica própria. Não testamos a exportação nesta comparação.
O QGIS consegue rodar fluxos automatizados num agendamento sem abrir o programa?
Sim. O QGIS vem com um utilitário de linha de comando chamado qgis_process. Você pode passar a ele qualquer algoritmo nativo ou qualquer arquivo .model3 salvo (por exemplo, qgis_process run model3 --BUILDINGS=... --DISTRICTS=... --built_up=...) a partir de um script bash, do Agendador de Tarefas do Windows ou de um job cron, sem abrir a interface gráfica do QGIS. No nosso teste em Bielefeld, o modelo rodou sem interface pelo qgis_process em 44,5 segundos.
Leia a seguirPyQGIS: o que é e como automatizar o QGIS com Python
Faça no QGIS só pedindo
O AI Agent executa a tarefa que você descreve, no seu próprio projeto QGIS. Grátis, sem cartão.