AI Agent QGIS-plugin: de krachtigste AI-agent voor QGIS
Gepubliceerd op
AI Agent van TerraLab is een gratis QGIS-plugin die geospatiale vragen beantwoordt in QGIS zelf. Op GeoKTools en GeoExpertQueries, de twee geospatiale benchmarks die Google Research in oktober 2026 publiceerde, scoorde hij 43,8 van de 100 op 41 achtergehouden vragen, tegen 24,9 voor Claude Sonnet 5.5 met een QGIS MCP-server, 22,1 voor GPT-6 Luna met een QGIS MCP-server en 21,0 voor GPT-6 Luna alleen. Dat is de hoogste score van alle AI-agents die we in QGIS hebben getest, in runs van 16 tot 20 oktober 2026, beoordeeld met de eigen scoringscode van Google.
Je stelt een vraag in gewone woorden, over overstromingsrisico, reistijden of waterstress. De plugin zoekt de gegevens, voert de analyse uit met QGIS en voegt het resultaat als lagen aan je project toe, met vermelding van de bronnen.
- AI Agent QGIS-plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Nauwkeurigheid van 0 tot 100 op GeoKTools en GeoExpertQueries, de benchmarks van Google Research voor geospatiale agents (arXiv:2610.15750): de 41 achtergehouden vragen zonder verband met onze afstemming, beoordeeld met de eigen scoringscode van Google, gemiddelde van 3 runs. De plugin op effort Low, de instelling van het gratis abonnement.
Wat scoorde AI Agent op de geospatiale benchmarks van Google?
| AI Agent QGIS-plugin | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna alleen | |
|---|---|---|---|---|
GeoKTools 30 vragen Deterministische offline scorer van Google Deterministische scorer | 53.5Effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 vragen Rapportprotocol van Google: exacte match, anders Gemini 3.8 Flash als beoordelaar Rapportprotocol van Google | 36.9Effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 vragen Toolonafhankelijke autorater, Gemini 3.8 Flash, 3 beoordelingsruns Autorater, 3 beoordelingsruns | 62.6Effort Low | 29.3 | 8.6 | 0.0 |
Alle 41 vragen 41 vragen Beide benchmarks, rapportprotocol van Google Rapportprotocol van Google | 43.8Effort Low | 24.9 | 22.1 | 21.0 |
Scores van 0 tot 100, gemiddelde van 3 runs per systeem, elke scorer van Google zelf en ongewijzigd: de deterministische scorer, het rapportprotocol en de GeoExpertQueries-autorater. AI Agent draaide op effort Low op 20 oktober 2026, Claude Sonnet 5.5 met een QGIS MCP-server op 18 oktober, GPT-6 Luna met een QGIS MCP-server op 16 en 17 oktober, en GPT-6 Luna alleen op 19 oktober. Vet markeert de beste score in elke rij.
De voorsprong houdt stand per vraag. Van de 41 vragen scoorde AI Agent hoger dan Claude Sonnet 5.5 met een QGIS MCP-server op 26 en lager op 5, en hoger dan GPT-6 Luna met een QGIS MCP-server op 24 en lager op 7. Zijn gemiddelde voorsprong op Claude is 19 punten, tussen 10 en 29 met 95% betrouwbaarheid.
- Hoger
- Gelijk
- Lager
Per vraag het gemiddelde van de plugin over 3 runs, vergeleken met dat van Claude. Alles op effort Low.
Wat zijn GeoKTools en GeoExpertQueries?
Het zijn de twee benchmarks die Google Research publiceerde bij zijn paper over de Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 oktober 2026). De vragen zijn openbaar in de google-research/geospatial-reasoning-benchmarks-repository, onder CC BY 4.0; Google houdt zijn officiële testvragen privé.
- GeoKTools stelt feitelijke vragen waarvan het antwoord één tot vier soorten geospatiale gegevens nodig heeft: een grens, een statistiek, een weerrecord, een aantal plaatsen. De deterministische scorer van Google geeft deelpunten met 10% tolerantie op getallen; zijn rapportprotocol vereist een exacte match of de goedkeuring van een beoordelaar.
- GeoExpertQueries stelt open vraagstukken die een analist zou krijgen, op terreinen als locatiekeuze, natuurgevaren en volksgezondheid. De autorater van Google beoordeelt elk antwoord aan de hand van workflows die door experts zijn geschreven.
Wat kan een AI-agent in QGIS?
Hij beantwoordt vragen over plaatsen door met echte gegevens in QGIS te werken: hij vindt datasets, voert ruimtelijke analyse uit zoals reistijden, overlays of statistieken per gebied, en geeft een kaart terug met de bronnen. Drie voorbeelden, elk gefilmd vanuit een leeg QGIS-project op effort Low, de instelling van het gratis abonnement. Het eerste komt uit het paper van Google. De andere twee hebben we in dezelfde stijl geschreven, en geen ervan hoort bij de gescoorde vragen.
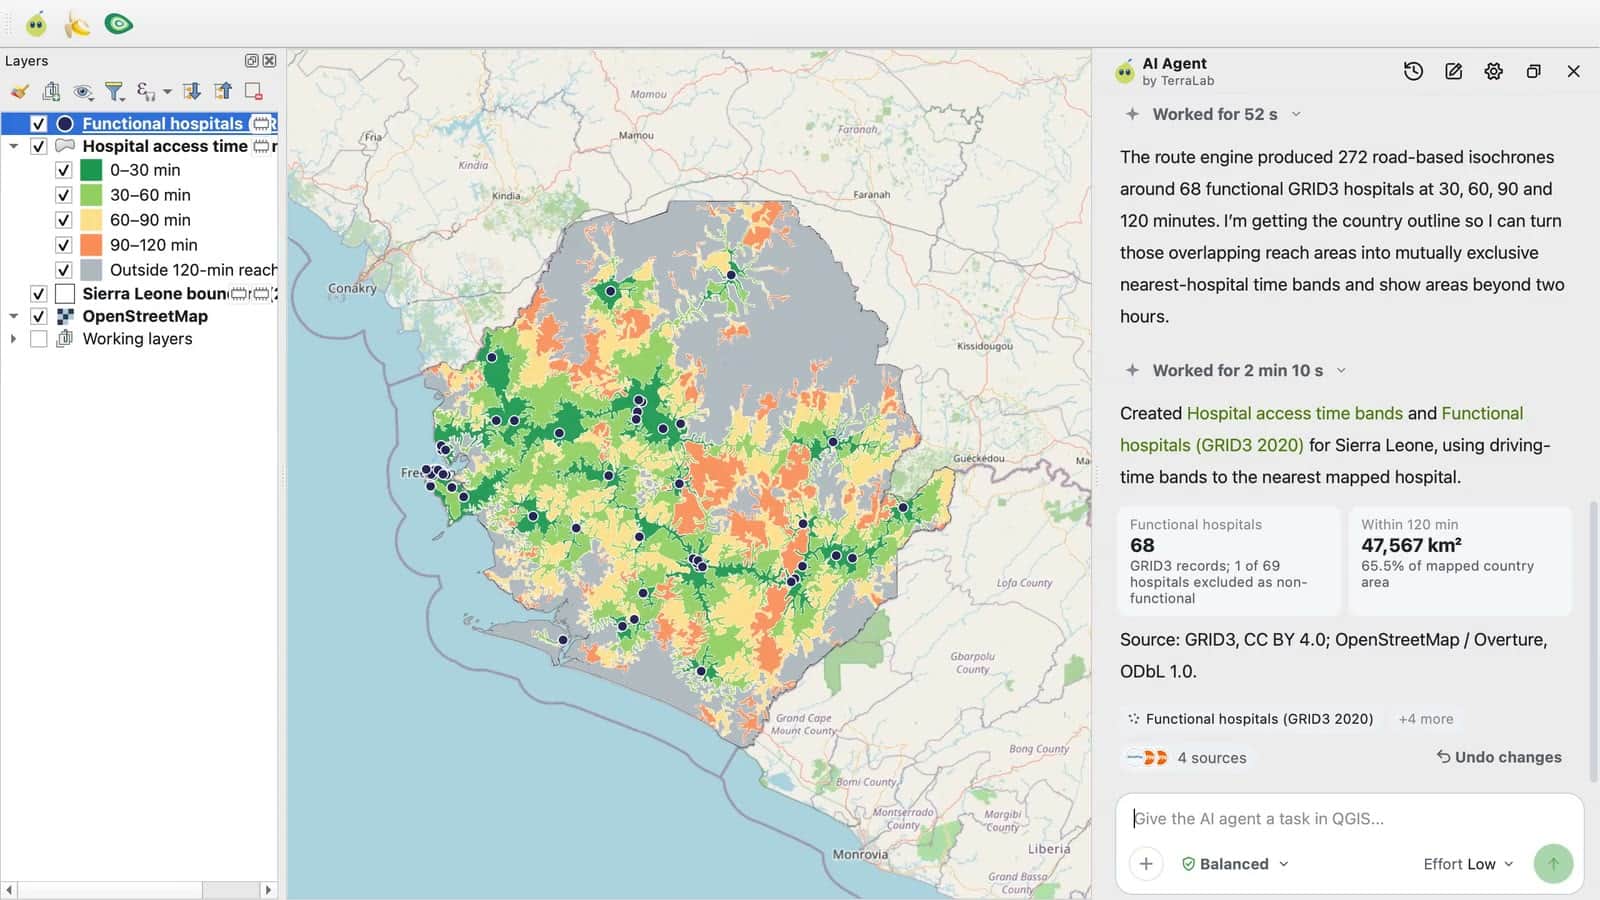
- Vraag
- Breng de reistijd in kaart voor een zwangere vrouw om het dichtstbijzijnde ziekenhuis te bereiken voor een spoedbevalling, vanaf elke plek in Sierra Leone. Gebruik reistijd, geen hemelsbrede afstand.
- Antwoord
- De plugin vroeg eerst hoe mensen reizen en welke voorzieningen moeten meetellen. Met de auto als vervoer en elk gekarteerd ziekenhuis als vervanger bracht hij de tijd tot het dichtstbijzijnde van 68 ziekenhuizen in kaart in banden van 30 minuten: 65,5% van het gekarteerde land ligt binnen twee uur. Ongeveer 5 minuten.
- Waarom het moeilijk is
- Het vraagt wegreistijd voor een heel land, geen hemelsbrede afstand, en een keuze over welke voorzieningen meetellen die geen model uit zijn hoofd kan maken.
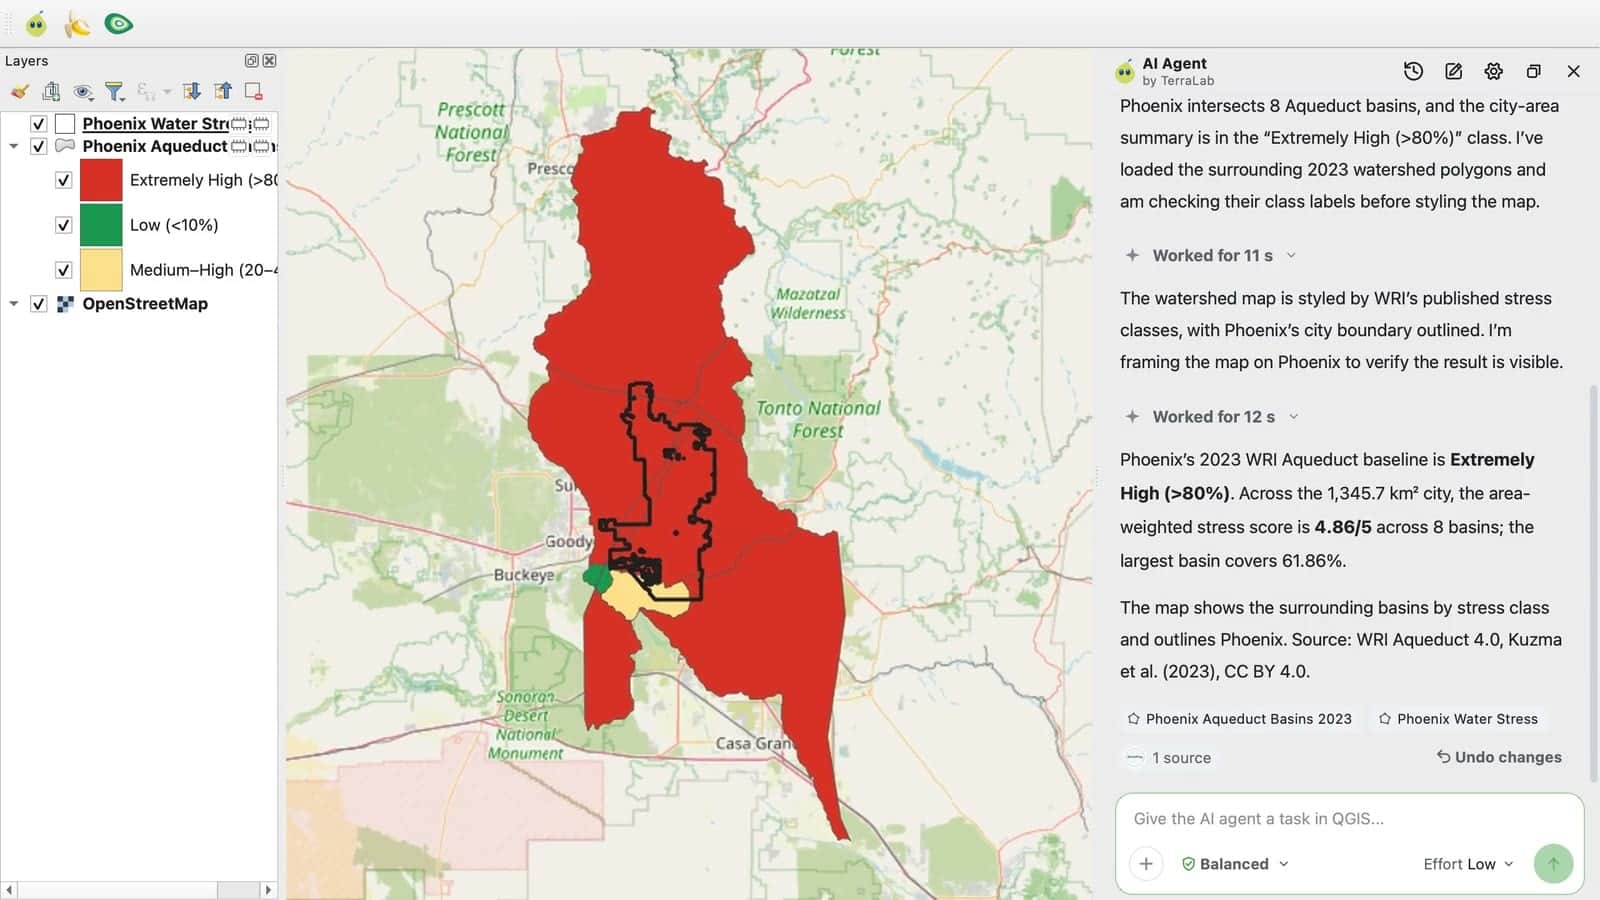
- Vraag
- Hoe groot is de waterstress in het gebied rond Phoenix, Arizona? Geef de WRI Aqueduct-basiswaterstress daar en toon die op de kaart.
- Antwoord
- Extremely High, boven 80%. De 8 WRI Aqueduct-stroomgebieden die de stad doorsnijden geven een oppervlaktegewogen score van 4,86 van de 5, met de bron en de licentie erbij genoemd. Ongeveer een minuut.
- Waarom het moeilijk is
- Het antwoord moet uit één benoemde dataset komen, gecombineerd over elk stroomgebied dat de stad overlapt, niet uit wat een model uit zijn hoofd over Phoenix weet.
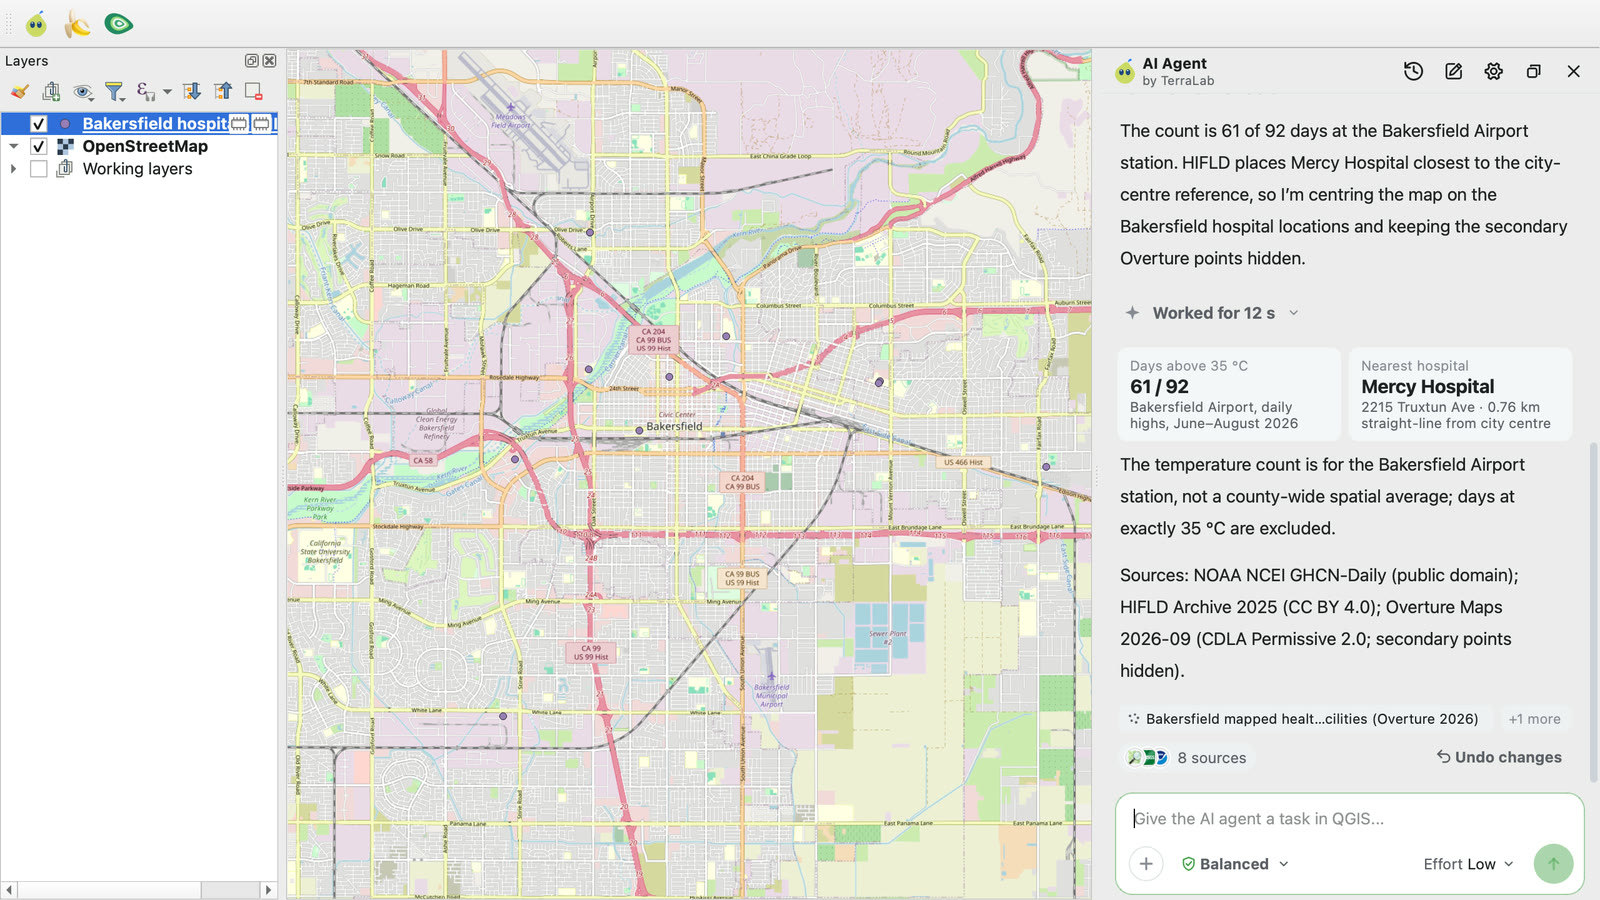
- Vraag
- Hoeveel dagen kwam de temperatuur boven 35 °C in Kern County, Californië, afgelopen zomer (juni tot en met augustus 2026)? En welk ziekenhuis ligt het dichtst bij Bakersfield, de hoofdplaats van het county?
- Antwoord
- 61 van 92 dagen boven 35 °C bij het weerstation op het vliegveld van Bakersfield, met de opmerking dat dit één station is en geen gemiddelde voor het hele county. Het dichtstbijzijnde ziekenhuis is Mercy Hospital, 0,76 km van het stadscentrum. Ongeveer 2 minuten.
- Waarom het moeilijk is
- Het koppelt drie bronnen, dagelijkse weerrecords, een ziekenhuisregister en een kaart van plaatsen, voor een zomer die te recent is om uit het hoofd te beantwoorden.
Is een AI-plugin voor QGIS beter dan Claude of ChatGPT met een QGIS MCP-server?
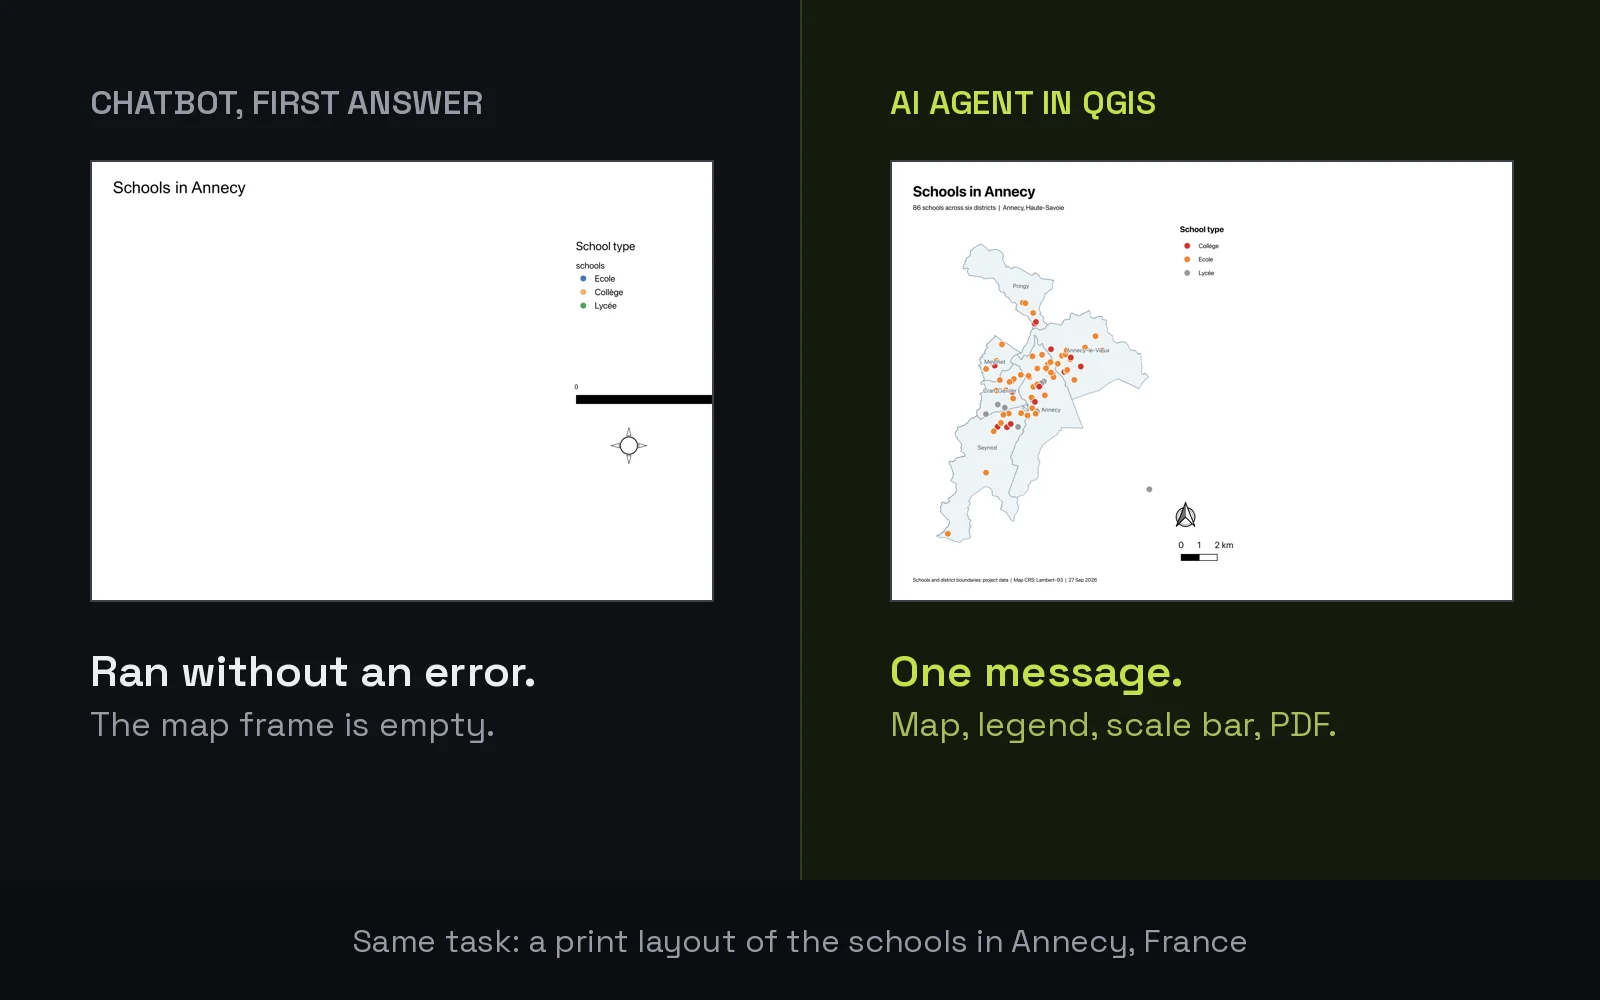
Op deze benchmarks wel. Een QGIS MCP-server verbindt een chatmodel zoals Claude of ChatGPT met QGIS via het Model Context Protocol, zodat het model QGIS-functies kan aanroepen. Het model kan dan QGIS bedienen, maar moet nog steeds zelf de data vinden, elke stap kiezen en zijn eigen werk controleren. Een taalmodel zonder verbinding antwoordt uit zijn geheugen.
De AI Agent QGIS-plugin geeft het model wat het nodig heeft voor geospatiaal werk: tools die voor GIS zijn gemaakt, gelicentieerde data die het mag gebruiken en een controle van elk resultaat voordat het antwoordt. Hij werkt direct in QGIS, dus het model werkt op echte lagen met echte QGIS-tools, en je kunt elk resultaat in je project openen.
De duidelijkste vergelijking is één model, op drie manieren. Op zichzelf herinnert GPT-6 Luna zich een deel van de GeoKTools-antwoorden en scoort het 0 op elke GeoExpertQueries-taak. Verbonden met QGIS via een algemene MCP-server scoort het ongeveer hetzelfde. In de plugin op effort Low scoort hetzelfde model 53,5 op GeoKTools en 62,6 op GeoExpertQueries.
- GPT-6 Luna alleen
- GPT-6 Luna + QGIS MCP
- AI Agent QGIS-plugin
GeoKTools met de deterministische scorer van Google, GeoExpertQueries met zijn autorater. De QGIS MCP-run gebruikte een andere server en client dan de Claude-run (zie Hoe hebben we getest?). De effort Low van de plugin draait GPT-6 Luna.
De plugin loopt voor op elk moeilijkheidsniveau. Elke GeoKTools-vraag heeft meerdere soorten data nodig. Bij twee soorten scoort hij ruim voor op elk ander systeem. Bij vier hebben alle systemen het moeilijk, en blijft de plugin voorop.
- AI Agent QGIS-plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna alleen
- AI Agent, live data
Beoordeeld met het rapportprotocol van Google, op de 30 achtergehouden GeoKTools-vragen zonder verband met onze afstemming: 20 hebben twee datatypes nodig, 5 drie en 5 vier. Elke vraag met één type kwam uit een sjabloon dat we voor de splitsing hadden bestudeerd, dus die groep is weggelaten.
- AI Agent QGIS-plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Deterministische scorer van Google. Elk type heeft 3 tot 5 vragen, dus één vraag verschuift de score sterk. De plugin loopt voor op Claude bij elk type behalve verwacht overstroomd gebied, dat geen enkel systeem beantwoordt. GPT-6 Luna met een QGIS MCP staat één punt voor bij plaatsen in een ring. De twee typen die we voor de splitsing hebben bestudeerd, waterstress rond een punt en uiterste punt van een gebied, zijn weggelaten.
- AI Agent QGIS-plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
De toolonafhankelijke autorater van Google. Volksgezondheid heeft maar 2 vragen, dus één vraag verschuift de score sterk; de plugin en Claude delen daar de eerste plaats, en GPT-6 Luna alleen scoorde in elk domein 0.
Hoe scoort AI Agent op andere GIS-benchmarks?
We hebben AI Agent ook laten draaien op twee openbare benchmarks van buiten Google, zonder dat er in AI Agent iets voor een van beide is afgestemd. Onze eigen code beoordeelde elk antwoord aan de hand van de referentieantwoorden van elke benchmark. Geen andere agent draaide onder dezelfde omstandigheden, dus er is hier geen onderlinge vergelijking.
GeoBenchX: 62,8% van 160 taken
GeoBenchX (arXiv:2503.18129) vraagt om GIS-werk in meerdere stappen op open data: tabellen samenvoegen, lagen verwerken en landen, steden en regio's in kaart brengen. Sommige taken vragen iets wat de data niet kan geven, en het juiste antwoord is dat te zeggen. AI Agent slaagde voor gemiddeld 62,8% van 160 taken over twee runs.
- AI Agent QGIS-plugin
Beoordeeld door code aan de hand van de opnieuw afgespeelde referentieoplossingen van de benchmark, zonder AI-beoordelaar. De totaalscore is het gemiddelde van twee runs, 65,0% en 60,6%; de andere twee rijen komen uit de eerste run. De eigen resultaten van GeoBenchX en de tabel van Axis Spatial beoordelen met een AI-beoordelaar op een andere set taken, dus we zetten onze score er niet naast.
GS-QA2: 61,1 van de 100 op 245 vragen
GS-QA2, van Shang et al. van UC Riverside, stelt ruimtelijke vragen over plaatsen in de Verenigde Staten: het dichtstbijzijnde object, een richting of een afstand, de helling, expositie of hoogte van het terrein. Elk referentieantwoord komt uit een vaste OpenStreetMap-snapshot en een vast hoogtemodel. Met diezelfde data scoort AI Agent 61,1 van de 100. Met de live data van vandaag scoort hij 22,0, omdat plaatsen die sinds de snapshot zijn toegevoegd, hernoemd of opnieuw getekend niet meer overeenkomen met het referentieantwoord. GPT-6 Luna alleen, het model waarop AI Agent draait op effort Low, scoort 15,1.
- AI Agent QGIS-plugin
- AI Agent, live data
- GPT-6 Luna alleen
Score van 0 tot 100, gemiddelde over de 49 vraagsjablonen van de benchmark, 3 runs. Beoordeeld door code met de toleranties uit het paper, zonder AI-beoordelaar. Axis Spatial publiceert GS-QA2-scores in dezelfde datasetting, maar op een andere trekking vragen en met een privé checker, dus ze zijn niet één op één vergelijkbaar.
Andere openbare benchmarks voor GIS-agents zijn onder meer GISAgentBench en GeoNatureAgent. We hebben AI Agent er niet op laten draaien, dus deze pagina meldt er geen score voor.
Hoe hebben we getest?
- Google Research publiceerde GeoKTools en GeoExpertQueries met hun paper (arXiv:2610.15750), samen met oefenvragen; het houdt zijn officiële testvragen privé. Dit is onze eigen run op de openbare vragen, geen leaderboard van Google.
- We hebben de agent verbeterd op de helft van de openbare vragen en gemeten op de andere 50, gesplitst per vraagsjabloon. Vóór die splitsing, tijdens het verkennen van de benchmark, hadden we twee sjablonen met hun antwoorden bestudeerd. Negen van de 50 vragen komen daaruit, dus die hebben we weggelaten: elke score hier is op de andere 41, de achtergehouden vragen zonder verband met onze afstemming.
- Elk systeem kreeg dezelfde vragen, dezelfde instructies en limieten, een leeg QGIS-project en 3 pogingen. De eigen scoringscode van Google beoordeelde elk antwoord.
- We draaiden de plugin op effort Low (GPT-6 Luna, in het gratis abonnement) en op effort High (een ander model dat dieper plant, in Pro). Low scoorde hoger op beide benchmarks, dus elke getoonde score is Low.
- Claude Sonnet 5.5 draaide in Claude Code met de QGIS MCP-plugin van nkarasiak, versie 0.15.1, met zijn eigen shell-, web- en bestandstools uit, op 18 oktober. GPT-6 Luna + QGIS MCP draaide in de Codex CLI van OpenAI met de qgis_mcp-server van jjsantos01, op 16 en 17 oktober. GPT-6 Luna alleen antwoordde zonder tools.
Technische details
Benchmarks: GeoKTools en GeoExpertQueries uit google-research/geospatial-reasoning-benchmarks, commit c21a6d95, data onder CC BY 4.0. De openbare dev-split (85 GeoKTools- en 25 GeoExpertQueries-vragen) is per vraagsjabloon in tweeën gesneden; de achtergehouden helft heeft 39 GeoKTools- en 11 GeoExpertQueries-vragen. Vóór de splitsing hadden we de referentieantwoorden van twee GeoKTools-sjablonen gecontroleerd, uiterste punt van een gebied en waterstress rond een punt; hun 9 vragen vielen in de achtergehouden helft en zijn in elke score weggelaten, waardoor 30 GeoKTools- en 11 GeoExpertQueries-vragen overblijven. Elk systeem kreeg het promptvoorvoegsel van Google, maximaal 100 modelaanroepen en 30 minuten per vraag, en 3 volledige runs; een mislukte run of een run die de tijdslimiet overschrijdt scoort 0. Scorers, ongewijzigd: de deterministische GeoKTools-scorer (10% tolerantie op getallen, deelpunten, ROUGE-L op tekst); het GeoKTools-rapportprotocol (exacte match, anders een beoordelaar met Gemini 3.8 Flash); de toolonafhankelijke GeoExpertQueries-autorater (Gemini 3.8 Flash, 3 beoordelingsruns per antwoord). Het 95%-interval is een gepaarde bootstrap over vragen. Runs: de plugin op effort Low en High op 20 oktober 2026; Claude + QGIS MCP op 18 oktober; GPT-6 Luna alleen op 19 oktober. Van elke poging zijn de toolaanroepen gecontroleerd op het lezen van de benchmarkrepository, het vragenbestand of het paper, en een treffer scoort 0: de plugin had er geen, de runs van GPT-6 Luna + QGIS MCP hadden er 2. Mislukte, geweigerde of door de tijdslimiet afgebroken pogingen scoren 0 en blijven in de gemiddelden (7 van 150 voor GPT-6 Luna + QGIS MCP, geen van de 150 van de plugin op effort Low).
GeoBenchX: Solirinai/GeoBenchX op commit 0edf6109, MIT-licentie, 202 taken, beschreven in arXiv:2503.18129. We hebben 23 taken weggelaten die een gepubliceerde audit uitsloot, 3 controlevragen en 16 waarvan de referentieoplossing niet reproduceert of om een cijfer vraagt dat de referentie niet berekent, waardoor er 160 overblijven. AI Agent draaide elke taak in twee aparte runs op effort Low op 20 oktober 2026, in QGIS, met de data van de taak in een map naast een leeg project: 65,0% (95%-interval 56,9 tot 72,5) en 60,6%. In de eerste run loste hij 46 van de 92 taken met een antwoord op, weigerde hij 55 van de 62 die niet op te lossen zijn en slaagde hij voor 3 van de 6 die beide accepteren. Beoordeeld door code, zonder AI-beoordelaar, aan de hand van de opnieuw afgespeelde referentieoplossing: de waarden die de kaart toont, aantallen features, het getal dat het antwoord noemt, of helemaal geen kaart voor taken die niet op te lossen zijn.
GS-QA2: Zoe/GS-QA2 op revisie 0ccf9453, van Shang et al. (UC Riverside), ODbL 1.0, © OpenStreetMap contributors; ASTER GDEM is een product van METI en NASA. 245 vragen, 5 uit elk van 49 sjablonen, getrokken met dezelfde regel als de tabel van Axis Spatial maar niet dezelfde vragen. Drie instellingen, elk 3 runs: AI Agent op effort Low met de OpenStreetMap-tabellen en ASTER-hoogte van de benchmark, uitgesneden voor de gebieden van de vragen, in een map naast een leeg project, waarbij de prompt alleen zegt waar de data staat (61,1, 95%-interval 57,1 tot 65,2); AI Agent op effort Low vanuit een leeg project op live data (22,0, 19,0 tot 25,2); GPT-6 Luna alleen, één aanroep zonder tools (15,1, 12,2 tot 18,1). Het eindantwoord wordt gecontroleerd tegen elke referentierij met de toleranties uit het paper: namen op overlap van tokens, locaties binnen 5 m, richting, expositie en helling binnen 5°, hoogte binnen 10 m, afstanden, oppervlakten en aantallen binnen 5%.
Wat laten deze resultaten niet zien?
- Onze run, op openbare vragen. Google houdt zijn testvragen privé. Deze scores komen van de openbare vragen, door ons gedraaid en beoordeeld met de code van Google.
- 41 vragen, niet 50. Onze aankondigingsposts noemen 52,9, de score van de plugin onder het rapportprotocol op alle 50 achtergehouden vragen. Daarin zitten de 9 uit sjablonen die we hadden bestudeerd, dus elke score op deze pagina laat ze weg.
- Kleine steekproeven. GeoExpertQueries heeft 11 achtergehouden vragen en elk GeoKTools-vraagtype heeft er 3 tot 5, dus één vraag verschuift die scores sterk. De vergelijking over alle 41 vragen is degene om te citeren.
- Alleen de agents die we testten. We vergeleken drie opstellingen: Claude Sonnet 5.5 en GPT-6 Luna, elk via één MCP-server voor QGIS uit de community, en GPT-6 Luna alleen. Andere modellen, andere MCP-servers en de eigen agent van Google uit het paper zitten niet in deze vergelijking.
- Geen onderlinge vergelijking op GeoBenchX of GS-QA2. Gepubliceerde scores op die benchmarks gebruiken andere takensets en andere beoordelaars, dus we zetten AI Agent er niet tegenover.
Hoe installeer je de AI Agent QGIS-plugin?
De AI Agent QGIS-plugin is gratis in de officiële QGIS-pluginrepository, voor QGIS 3.28 en hoger, QGIS 4 inbegrepen. Open in QGIS Plugins, dan Manage and Install Plugins, zoek naar AI Agent van TerraLab, installeer de plugin en log in. Je hebt geen API-sleutel en geen creditcard nodig.
Het gratis abonnement bevat 5 taken per maand op effort Low, de instelling achter elke score hierboven. Effort Medium en High horen bij Pro. De complete handleiding loopt door een eerste taak, en wat een AI-agent in QGIS is legt het idee uit.
Veelgestelde vragen
Wat is de beste AI-agent voor QGIS?
Van alle AI-agents die we in QGIS testten op de geospatiale benchmarks van Google scoorde de AI Agent QGIS-plugin van TerraLab het hoogst: 43,8 van de 100 op 41 achtergehouden vragen, tegen 24,9 voor Claude Sonnet 5.5 met een QGIS MCP-server en 22,1 voor GPT-6 Luna met een QGIS MCP-server. Het is een gratis plugin in de officiële QGIS-pluginrepository.
Welke AI is het beste voor GIS-analyse?
Voor analyse in QGIS had de AI Agent QGIS-plugin de hoogste score van de agents die we testten op de benchmarks GeoKTools en GeoExpertQueries van Google. Tools voor andere GIS-software, zoals de GeoAI-tools van Esri voor ArcGIS, hebben we niet getest.
Kan ChatGPT in QGIS werken?
ChatGPT alleen antwoordt uit zijn geheugen en kan QGIS niet bedienen. Verbonden via een QGIS MCP-server in Codex van OpenAI scoorde GPT-6 Luna 39,5 op GeoKTools en 8,6 op GeoExpertQueries, ongeveer wat hetzelfde model zonder tools scoort. In de AI Agent QGIS-plugin scoorde hetzelfde model 53,5 en 62,6.
Kan Claude met QGIS werken?
Ja, via een QGIS MCP-server zoals de QGIS MCP-plugin van nkarasiak. In onze test scoorde Claude Sonnet 5.5 met die server 33,3 op GeoKTools en 29,3 op GeoExpertQueries; de AI Agent QGIS-plugin scoorde 53,5 en 62,6, en hoger op 26 van de 41 vragen.
Wat is een QGIS MCP-server?
Een brug waarmee een chatmodel zoals Claude of ChatGPT QGIS-functies kan aanroepen via het Model Context Protocol. Het model kan dan QGIS bedienen, maar moet de data zelf vinden en zijn werk zelf controleren. Onze QGIS MCP-gids vergelijkt de servers.
Wat zijn de geospatiale benchmarks van Google?
GeoKTools en GeoExpertQueries, gepubliceerd door Google Research in oktober 2026 bij zijn paper over de Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). GeoKTools stelt feitelijke vragen die één tot vier soorten geospatiale gegevens nodig hebben; GeoExpertQueries stelt open vraagstukken voor analisten, beoordeeld aan de hand van workflows die door experts zijn geschreven.
Is er een benchmark die AI-agents voor GIS vergelijkt?
Ja, meerdere. De GeoKTools en GeoExpertQueries van Google, GeoBenchX, GS-QA2, GISAgentBench en GeoNatureAgent testen allemaal agents op geospatiale taken, elk met eigen vragen en een eigen beoordelaar, dus hun scores zijn niet over benchmarks heen te vergelijken.
Hoe doet AI Agent het op andere geospatiale benchmarks?
Op GeoBenchX, een openbare benchmark met GIS-taken in meerdere stappen, slaagde hij voor 62,8% van 160 taken over twee runs. Op GS-QA2, ruimtelijke vragen over Amerikaanse plaatsen getoetst aan een vaste kaartsnapshot, scoorde hij 61,1 van de 100 met de eigen data van de benchmark. Geen andere agent draaide onder dezelfde omstandigheden.
Is de AI Agent QGIS-plugin gratis?
Ja. Het gratis abonnement bevat 5 taken per maand op effort Low, de instelling achter elke benchmarkscore hier, zonder API-sleutel en zonder creditcard. Effort Medium en High horen bij Pro.