Plugin AI Agent para QGIS: o agente de IA mais potente para QGIS
Publicado em
O AI Agent da TerraLab é um plugin gratuito do QGIS que responde a perguntas geoespaciais dentro do QGIS. No GeoKTools e no GeoExpertQueries, os dois benchmarks geoespaciais que o Google Research publicou em outubro de 2026, ele fez 43,8 de 100 em 41 perguntas reservadas no esforço Low (GPT-6 Luna), contra 24,9 do Claude Sonnet 5.5 conduzindo o QGIS pelo servidor QGIS MCP do nkarasiak no Claude Code, 22,1 do GPT-6 Luna pelo servidor QGIS MCP do jjsantos01 no Codex da OpenAI e 21,0 do GPT-6 Luna sozinho, sem ferramentas. É a maior pontuação entre todos os agentes de IA que testamos no QGIS, em execuções de 16 a 20 de outubro de 2026 avaliadas pelo código de avaliação do próprio Google.
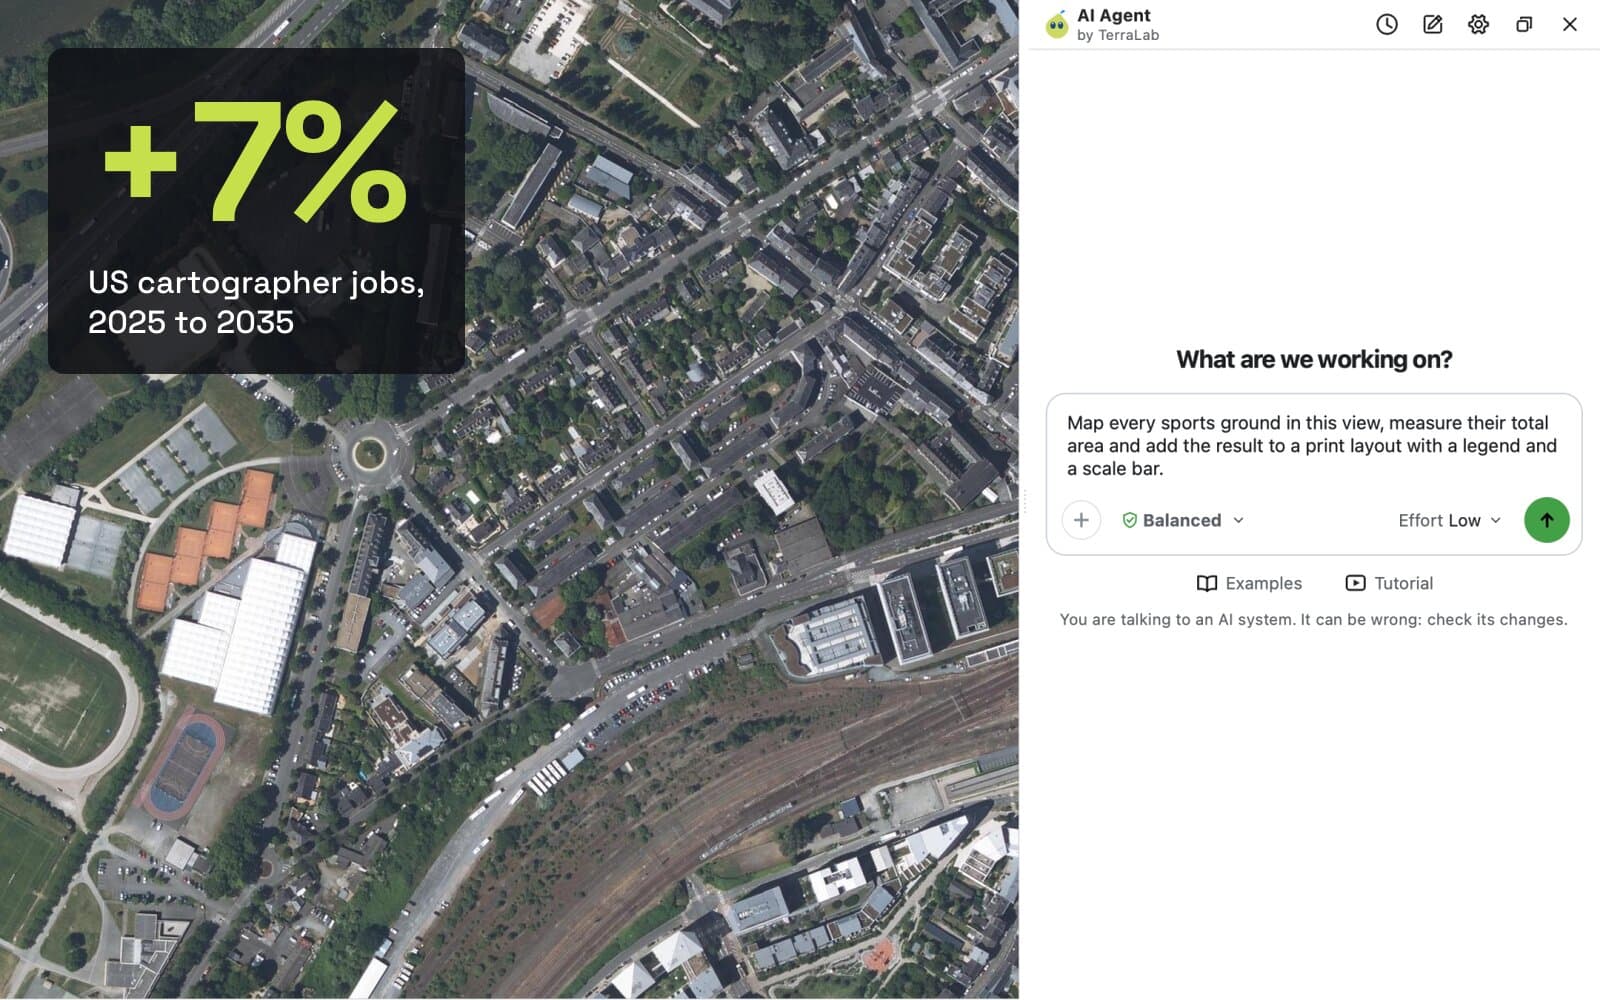
Você faz uma pergunta em palavras simples, sobre risco de inundação, tempos de deslocamento ou estresse hídrico. O plugin encontra os dados, executa a análise com o QGIS e adiciona o resultado ao seu projeto como camadas, com as fontes citadas.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
Precisão de 0 a 100 no GeoKTools e no GeoExpertQueries, os benchmarks do Google Research para agentes geoespaciais (arXiv:2610.15750): as 41 perguntas reservadas, sem ligação com o nosso ajuste, avaliadas pelo código de avaliação do próprio Google, média de 3 execuções. O plugin no esforço Low, o ajuste do plano gratuito.
Qual foi a pontuação do AI Agent nos benchmarks geoespaciais do Google?
| Plugin AI Agent para QGIS(Low: GPT-6 Luna) | Claude Sonnet 5.5 + QGIS MCP(nkarasiak, Claude Code) | GPT-6 Luna + QGIS MCP(jjsantos01, Codex) | GPT-6 Luna sozinho(sem ferramentas) | |
|---|---|---|---|---|
GeoKTools 30 perguntas Avaliador determinístico offline do Google Avaliador determinístico | 53.5Esforço Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 perguntas Protocolo do relatório do Google: correspondência exata, senão juiz Gemini 3.8 Flash Protocolo do relatório do Google | 36.9Esforço Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 perguntas Autorater independente de ferramenta, Gemini 3.8 Flash, 3 execuções do juiz Autorater, 3 execuções do juiz | 62.6Esforço Low | 29.3 | 8.6 | 0.0 |
Todas as 41 perguntas 41 perguntas Os dois benchmarks, protocolo do relatório do Google Protocolo do relatório do Google | 43.8Esforço Low | 24.9 | 22.1 | 21.0 |
Pontuações de 0 a 100, média de 3 execuções por sistema, todos os avaliadores do próprio Google e sem alterações: o avaliador determinístico, o protocolo do relatório e o autorater do GeoExpertQueries. O AI Agent rodou no esforço Low (GPT-6 Luna) em 20 de outubro de 2026; Claude Sonnet 5.5 + QGIS MCP (nkarasiak) no Claude Code em 18 de outubro; GPT-6 Luna + QGIS MCP (jjsantos01) no Codex da OpenAI em 16 e 17 de outubro; GPT-6 Luna sozinho em 19 de outubro. O negrito marca a melhor pontuação de cada linha.
A vantagem se mantém pergunta por pergunta. Das 41 perguntas, o AI Agent no esforço Low pontuou mais que o Claude Sonnet 5.5 + QGIS MCP (nkarasiak) em 26 e menos em 5, e mais que o GPT-6 Luna + QGIS MCP (jjsantos01) em 24 e menos em 7. Sua vantagem média sobre o Claude Sonnet 5.5 + QGIS MCP (nkarasiak) é de 19 pontos, entre 10 e 29 com 95% de confiança.
- Maior
- Empate
- Menor
Para cada pergunta, o AI Agent no esforço Low (GPT-6 Luna) contra o Claude Sonnet 5.5 + QGIS MCP (nkarasiak) no Claude Code, cada um com a média de 3 execuções. Protocolo do relatório do Google no GeoKTools, autorater no GeoExpertQueries.
O que são GeoKTools e GeoExpertQueries?
São os dois benchmarks que o Google Research lançou com o artigo sobre o Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 de outubro de 2026). As perguntas são públicas no repositório google-research/geospatial-reasoning-benchmarks, sob CC BY 4.0; o Google mantém privadas as suas perguntas oficiais de teste.
- GeoKTools faz perguntas factuais cujas respostas exigem de um a quatro tipos de dados geoespaciais: um limite, uma estatística, um registro meteorológico, uma contagem de lugares. O avaliador determinístico do Google dá crédito parcial com tolerância de 10% em números; o protocolo do relatório exige correspondência exata ou a aprovação de um juiz.
- GeoExpertQueries faz problemas abertos como os que um analista receberia, em áreas como escolha de locais, riscos naturais e saúde pública. O autorater do Google avalia cada resposta com base em fluxos de trabalho escritos por especialistas.
O que um agente de IA pode fazer no QGIS?
Ele responde a perguntas sobre lugares trabalhando com dados reais dentro do QGIS: encontra conjuntos de dados, executa análises espaciais como tempos de deslocamento, sobreposições ou estatísticas por área, e devolve um mapa com as suas fontes. Três exemplos, cada um filmado a partir de um projeto vazio do QGIS no esforço Low, o ajuste do plano gratuito. O primeiro vem do artigo do Google. Escrevemos os outros dois no mesmo estilo, e nenhum deles está entre as perguntas avaliadas.
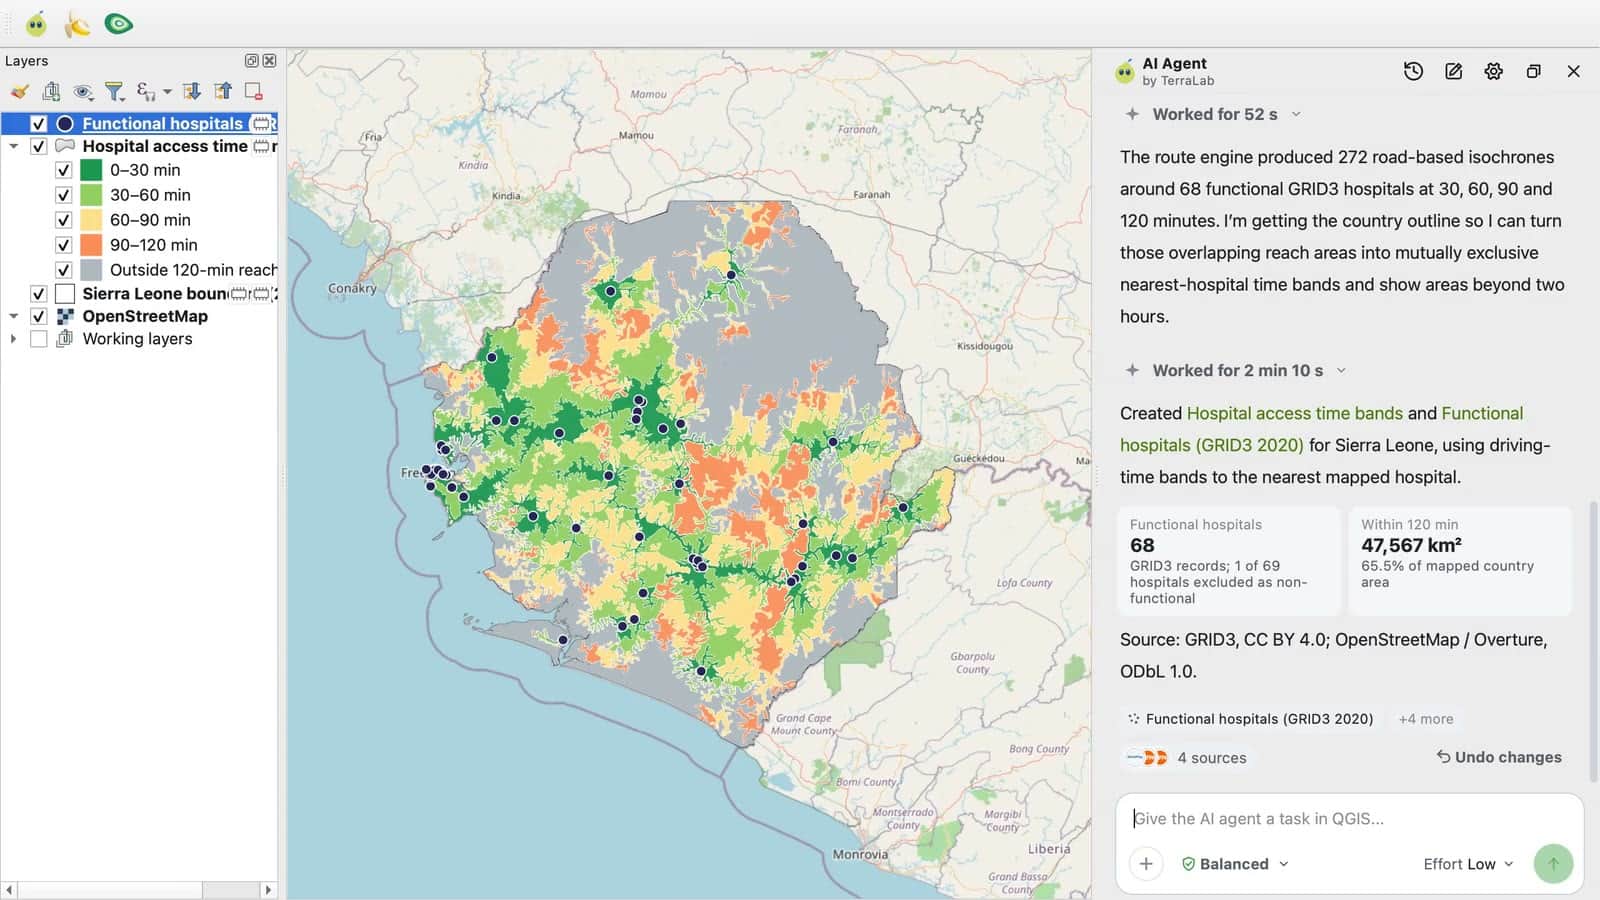
- Pergunta
- Mapeie o tempo de deslocamento de uma gestante até o hospital mais próximo para um parto de emergência, de qualquer ponto de Serra Leoa. Use o tempo de deslocamento, não a distância em linha reta.
- Resposta
- O plugin começou perguntando como as pessoas se deslocam e quais unidades devem contar. Com deslocamento de carro e todos os hospitais mapeados como referência, ele mapeou o tempo até o mais próximo dos 68 hospitais em faixas de 30 minutos: 65,5% do país mapeado fica a até duas horas. Cerca de 5 minutos.
- Por que é difícil
- Exige tempo de deslocamento por estrada em um país inteiro, não distância em linha reta, e uma escolha sobre quais unidades contam que nenhum modelo consegue fazer de memória.
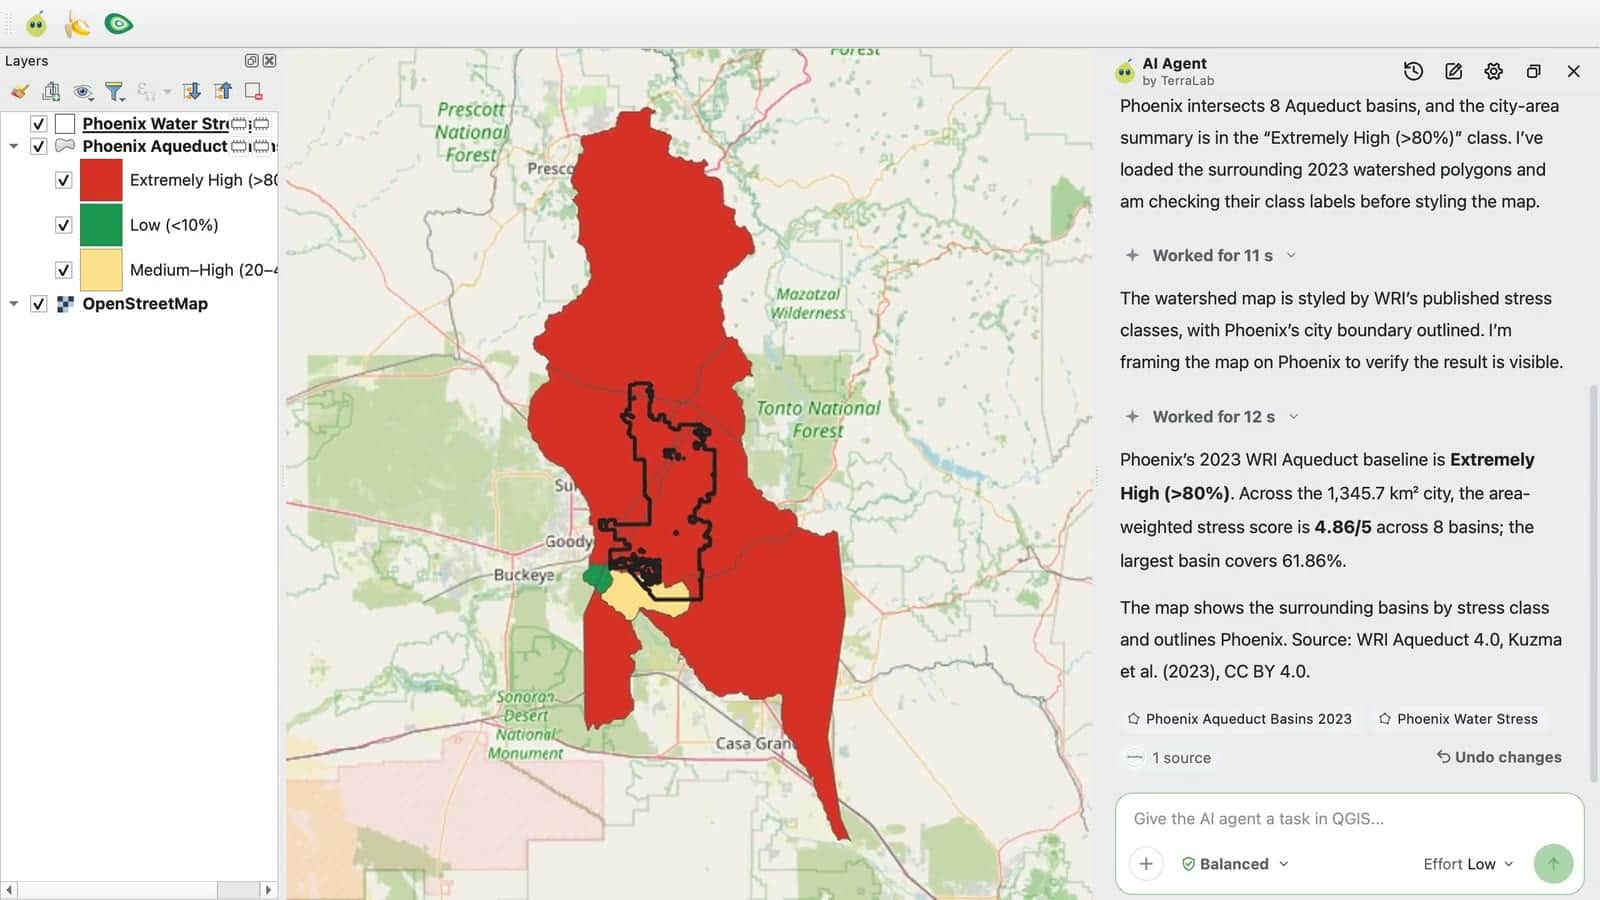
- Pergunta
- Qual é o estresse hídrico na região de Phoenix, no Arizona? Dê o estresse hídrico de referência do WRI Aqueduct ali e mostre no mapa.
- Resposta
- Extremely High, acima de 80%. As 8 bacias do WRI Aqueduct que cruzam a cidade dão uma pontuação ponderada por área de 4,86 de 5, com a fonte e a sua licença citadas. Cerca de um minuto.
- Por que é difícil
- A resposta precisa vir de um único conjunto de dados nomeado, combinado em todas as bacias que a cidade sobrepõe, e não do que um modelo lembra sobre Phoenix.
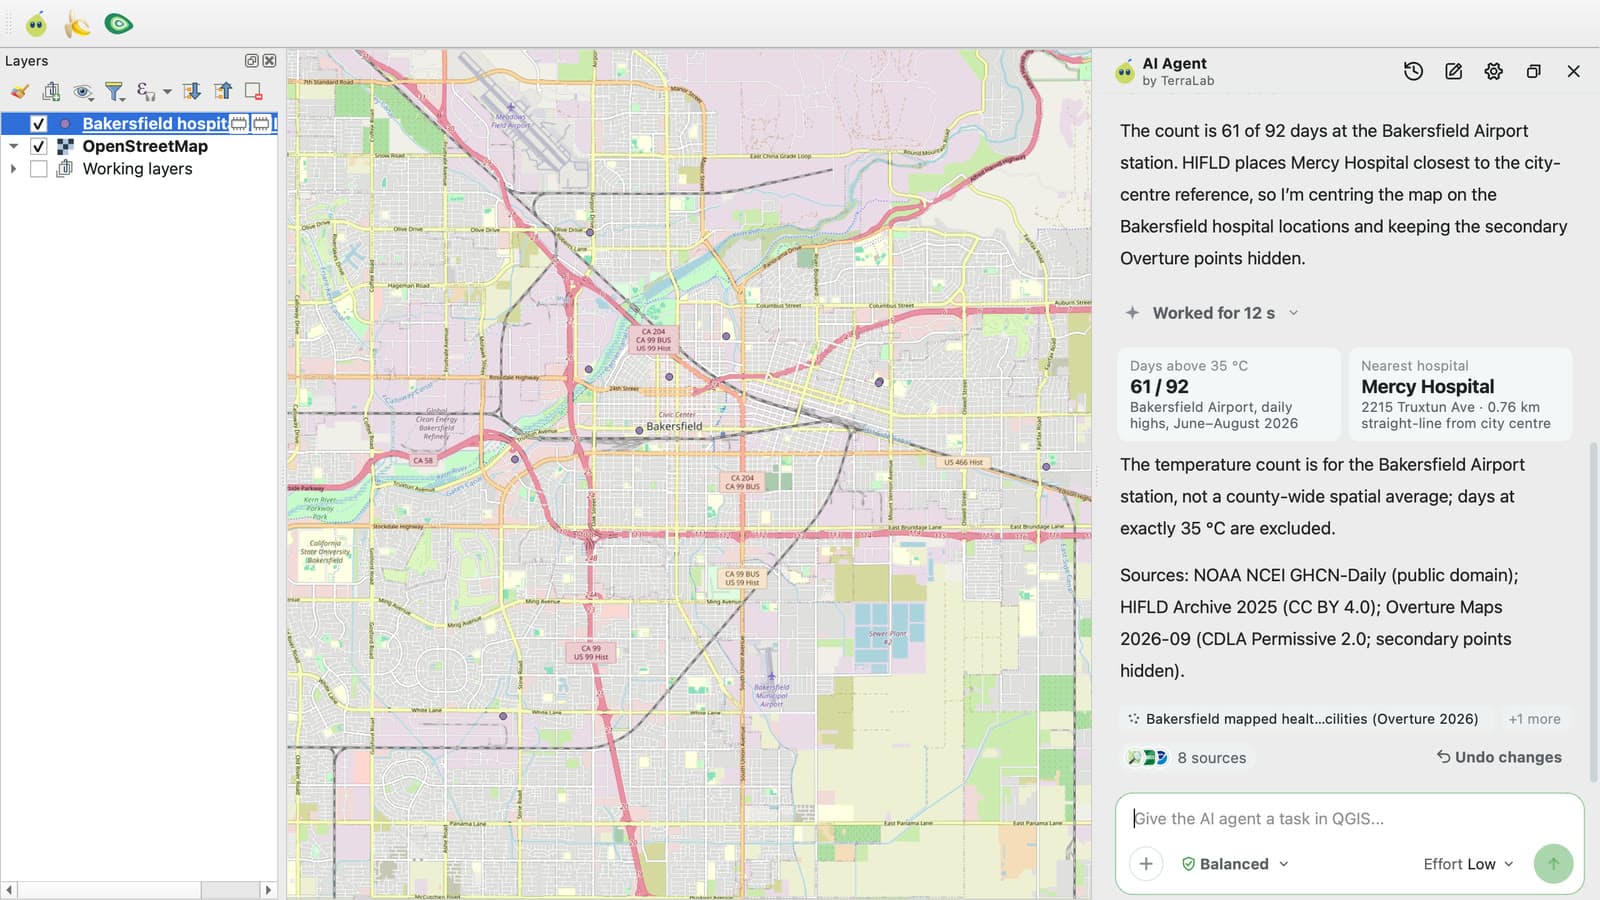
- Pergunta
- Quantos dias passaram de 35 °C no condado de Kern, na Califórnia, no último verão (junho a agosto de 2026)? E qual é o hospital mais próximo de Bakersfield, a sede do condado?
- Resposta
- 61 de 92 dias acima de 35 °C na estação do aeroporto de Bakersfield, com a observação de que é uma estação, não uma média do condado. O hospital mais próximo é o Mercy Hospital, a 0,76 km do centro da cidade. Cerca de 2 minutos.
- Por que é difícil
- Ele une três fontes, registros meteorológicos diários, um cadastro de hospitais e um mapa de lugares, para um verão recente demais para ser respondido de memória.
Um plugin de IA para QGIS é melhor que o Claude ou o ChatGPT com um servidor QGIS MCP?
Nestes benchmarks, sim. Um servidor QGIS MCP conecta um modelo de chat como o Claude ou o ChatGPT ao QGIS pelo Model Context Protocol, para que o modelo possa chamar funções do QGIS. O modelo passa a operar o QGIS, mas ainda precisa encontrar os dados, escolher cada passo e conferir o próprio trabalho. Um modelo de linguagem sem conexão responde de memória.
O plugin AI Agent para QGIS dá ao modelo o que ele precisa para o trabalho geoespacial: ferramentas feitas para GIS, dados licenciados que ele pode usar e uma conferência de cada resultado antes de responder. Ele funciona direto dentro do QGIS, então o modelo age em camadas reais com ferramentas reais do QGIS, e você pode abrir cada resultado no seu projeto.
A comparação mais clara é um modelo de três jeitos. Sozinho, o GPT-6 Luna lembra algumas respostas do GeoKTools e pontua 0 em todas as tarefas do GeoExpertQueries. Conectado ao QGIS pelo servidor QGIS MCP do jjsantos01 no Codex da OpenAI, ele pontua quase o mesmo. Dentro do plugin no esforço Low, o mesmo modelo pontua 53,5 no GeoKTools e 62,6 no GeoExpertQueries.
- GPT-6 Luna sozinho (sem ferramentas)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
GeoKTools com o avaliador determinístico do Google, GeoExpertQueries com o autorater. O GPT-6 Luna + QGIS MCP rodou com o servidor do jjsantos01 no Codex da OpenAI em 16 e 17 de outubro, e não com o servidor do nkarasiak e o Claude Code usados para o Claude Sonnet 5.5. O esforço Low do AI Agent roda o GPT-6 Luna. Os três arranjos do GPT-6 Luna usaram raciocínio alto.
O plugin lidera em todos os níveis de dificuldade. Cada pergunta do GeoKTools exige vários tipos de dados. Com dois tipos, ele pontua bem à frente de todos os outros sistemas. Com quatro, todos os sistemas penam, e o plugin continua na frente.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- GPT-6 Luna sozinho (sem ferramentas)
- AI Agent, dados ao vivo (Low: GPT-6 Luna)
Pontuado com o protocolo do relatório do Google, nas 30 perguntas reservadas do GeoKTools, sem ligação com o nosso ajuste: 20 exigem dois tipos de dados, 5 exigem três e 5 exigem quatro. Toda pergunta que exigia um só tipo vinha de um modelo de pergunta que estudamos antes da divisão, então esse grupo ficou de fora.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
Avaliador determinístico do Google. Cada tipo tem de 3 a 5 perguntas, então uma pergunta muda muito a pontuação. O AI Agent lidera o Claude Sonnet 5.5 + QGIS MCP (nkarasiak) em todos os tipos, exceto previsão de áreas alagadas, que nenhum sistema acerta. O GPT-6 Luna + QGIS MCP (jjsantos01) está 1,3 ponto à frente em lugares em um anel. Os dois tipos que estudamos antes da divisão, estresse hídrico ao redor de um ponto e ponto extremo de uma área, ficaram de fora.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
Autorater do Google, que não depende de ferramenta. Saúde pública tem só 2 perguntas, então uma pergunta muda muito a pontuação; o AI Agent e o Claude Sonnet 5.5 + QGIS MCP (nkarasiak) empatam ali em 25,0, e o GPT-6 Luna sozinho pontuou 0 em todas as áreas.
Como o AI Agent se sai em outros benchmarks de GIS?
Também rodamos o AI Agent em dois benchmarks públicos de fora do Google, sem nada no AI Agent ajustado para nenhum deles. Nosso próprio código avaliou cada resposta contra as respostas de referência de cada benchmark. Nenhum outro agente rodou nas mesmas condições, então aqui não há comparação direta.
GeoBenchX: 62,8% de 160 tarefas
O GeoBenchX (arXiv:2503.18129) pede trabalho de GIS em várias etapas com dados abertos: unir tabelas, processar camadas e mapear países, cidades e regiões. Algumas tarefas pedem algo que os dados não conseguem dar, e a resposta certa é dizer isso. O AI Agent passou em 62,8% de 160 tarefas, em média de duas execuções.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
Avaliado por código contra as soluções de referência reexecutadas do benchmark, sem juiz de IA. A pontuação geral é a média de duas execuções, 65,0% e 60,6%; as outras duas linhas vêm da primeira execução. Os resultados do próprio GeoBenchX e a tabela da Axis Spatial avaliam com um juiz de IA, em outro conjunto de tarefas, então não colocamos a nossa pontuação ao lado delas.
GS-QA2: 61,1 de 100 em 245 perguntas
O GS-QA2, de Shang et al. na UC Riverside, faz perguntas espaciais sobre lugares nos Estados Unidos: o elemento mais próximo, uma direção ou uma distância, a declividade, a orientação ou a elevação do terreno. Cada resposta de referência vem de um instantâneo fixo do OpenStreetMap e de um modelo de elevação. Com esses mesmos dados, o AI Agent faz 61,1 de 100. Com os dados ao vivo de hoje, faz 22,0, porque lugares adicionados, renomeados ou redesenhados desde o instantâneo já não correspondem à referência. O GPT-6 Luna sozinho, o modelo que o AI Agent roda no esforço Low, faz 15,1.
- Plugin AI Agent para QGIS (Low: GPT-6 Luna)
- AI Agent, dados ao vivo (Low: GPT-6 Luna)
- GPT-6 Luna sozinho (sem ferramentas)
Pontuação de 0 a 100, média dos 49 modelos de pergunta do benchmark, 3 execuções. Avaliado por código com as tolerâncias do artigo, sem juiz de IA. A Axis Spatial publica pontuações do GS-QA2 com os mesmos dados, mas em outro sorteio de perguntas e com um verificador privado, então não são comparáveis diretamente.
Outros benchmarks públicos para agentes de GIS incluem o GISAgentBench e o GeoNatureAgent. Não rodamos o AI Agent neles, então esta página não traz pontuação para eles.
Como fizemos o teste?
- O Google Research publicou o GeoKTools e o GeoExpertQueries com o seu artigo (arXiv:2610.15750), junto com perguntas de treino; as perguntas oficiais de teste continuam privadas. Esta é a nossa própria execução nas perguntas públicas, não um ranking do Google.
- Melhoramos o agente em metade das perguntas públicas e o medimos nas outras 50, divididas por modelo de pergunta. Antes dessa divisão, ao explorar o benchmark, tínhamos estudado dois modelos de pergunta com as respostas. Nove das 50 perguntas vêm deles, então as deixamos de fora: toda pontuação aqui é sobre as outras 41, as perguntas reservadas sem ligação com o nosso ajuste.
- Todos os sistemas receberam as mesmas perguntas, as mesmas instruções e limites, um projeto vazio do QGIS e 3 tentativas. O código de avaliação do próprio Google avaliou cada resposta.
- Rodamos o plugin no esforço Low (GPT-6 Luna, no plano gratuito) e no esforço High (um modelo diferente, que planeja mais a fundo, no Pro). O Low pontuou mais nos dois benchmarks, então toda pontuação mostrada é do Low.
- O Claude Sonnet 5.5 rodou no Claude Code com o plugin QGIS MCP do nkarasiak, versão 0.15.1, com as suas próprias ferramentas de shell, web e arquivos desligadas, em 18 de outubro. O GPT-6 Luna + QGIS MCP rodou no Codex CLI da OpenAI com o servidor qgis_mcp do jjsantos01, em 16 e 17 de outubro. O GPT-6 Luna sozinho respondeu sem ferramentas.
Detalhes técnicos
Benchmarks: GeoKTools e GeoExpertQueries de google-research/geospatial-reasoning-benchmarks, commit c21a6d95, dados sob CC BY 4.0. A divisão pública de desenvolvimento (85 perguntas do GeoKTools, 25 do GeoExpertQueries) foi cortada em duas por modelo de pergunta; a metade reservada tem 39 perguntas do GeoKTools e 11 do GeoExpertQueries. Antes da divisão, tínhamos conferido as respostas de referência de dois modelos de pergunta do GeoKTools, ponto extremo de uma área e estresse hídrico ao redor de um ponto; as 9 perguntas deles caíram na metade reservada e ficaram de fora de toda pontuação, o que deixa 30 perguntas do GeoKTools e 11 do GeoExpertQueries. Cada sistema recebeu o prefixo de prompt do Google, no máximo 100 chamadas ao modelo e 30 minutos por pergunta, e 3 execuções completas; uma execução com falha ou que estourou o tempo pontua 0. Avaliadores, sem alterações: avaliador determinístico do GeoKTools (tolerância de 10% em números, crédito parcial, ROUGE-L em texto); protocolo do relatório do GeoKTools (correspondência exata, senão um juiz Gemini 3.8 Flash); autorater do GeoExpertQueries que não depende de ferramenta (Gemini 3.8 Flash, 3 execuções do juiz por resposta). O intervalo de 95% é um bootstrap pareado sobre as perguntas. Execuções: AI Agent no esforço Low (GPT-6 Luna, raciocínio alto) e no esforço High em 20 de outubro de 2026; Claude Sonnet 5.5 + QGIS MCP (nkarasiak) no Claude Code em 18 de outubro; GPT-6 Luna + QGIS MCP (jjsantos01) no Codex da OpenAI, raciocínio alto, em 16 e 17 de outubro; GPT-6 Luna sozinho, raciocínio alto, em 19 de outubro. As chamadas de ferramentas de cada tentativa foram verificadas em busca de leituras do repositório do benchmark, do seu arquivo de perguntas ou do artigo, e uma ocorrência pontua 0: o plugin não teve nenhuma, as execuções do GPT-6 Luna + QGIS MCP tiveram 2. Tentativas com falha, recusadas ou que estouraram o tempo pontuam 0 e ficam nas médias (7 de 150 para o GPT-6 Luna + QGIS MCP (jjsantos01); 3 de 150 para o Claude Sonnet 5.5 + QGIS MCP (nkarasiak), recusas do modelo em uma pergunta do GeoExpertQueries; nenhuma das 150 do AI Agent no Low).
GeoBenchX: Solirinai/GeoBenchX no commit 0edf6109, licença MIT, 202 tarefas, descrito em arXiv:2503.18129. Deixamos de fora 23 tarefas excluídas por uma auditoria publicada, 3 perguntas de controle e 16 cuja solução de referência não se reproduz ou pede um valor que a referência não calcula, sobrando 160. O AI Agent rodou cada tarefa em duas execuções separadas no esforço Low em 20 de outubro de 2026, no QGIS, com os dados da tarefa em uma pasta ao lado de um projeto vazio: 65,0% (intervalo de 95% de 56,9 a 72,5) e 60,6%. Na primeira execução, resolveu 46 das 92 tarefas que têm resposta, recusou 55 das 62 que não podem ser resolvidas e passou em 3 das 6 que aceitam as duas coisas. Avaliado por código, sem juiz de IA, contra a solução de referência reexecutada: os valores que o mapa mostra, contagens de feições, o número que a resposta informa, ou nenhum mapa para as tarefas que não podem ser resolvidas.
GS-QA2: Zoe/GS-QA2 na revisão 0ccf9453, de Shang et al. (UC Riverside), ODbL 1.0, © colaboradores do OpenStreetMap; o ASTER GDEM é um produto do METI e da NASA. 245 perguntas, 5 de cada um dos 49 modelos de pergunta, sorteadas com a mesma regra da tabela da Axis Spatial, mas não as mesmas perguntas. Três configurações, 3 execuções cada: AI Agent no esforço Low com as tabelas do OpenStreetMap e a elevação ASTER do benchmark, recortadas para as áreas das perguntas, em uma pasta ao lado de um projeto vazio, com o prompt dizendo apenas onde estão os dados (61,1, intervalo de 95% de 57,1 a 65,2); AI Agent no esforço Low a partir de um projeto vazio com dados ao vivo (22,0, de 19,0 a 25,2); GPT-6 Luna sozinho, uma chamada sem ferramentas (15,1, de 12,2 a 18,1). A resposta final é conferida contra cada linha de referência com as tolerâncias do artigo: nomes por sobreposição de tokens, localizações a até 5 m, rumo, orientação e declividade a até 5°, elevação a até 10 m, distâncias, áreas e contagens a até 5%.
O que estes resultados não mostram?
- Nossa execução, em perguntas públicas. O Google mantém privadas as suas perguntas de teste. Estas pontuações vêm das perguntas públicas, executadas e avaliadas por nós com o código do Google.
- 41 perguntas, não 50. Nossos posts de anúncio citam 52,9, a pontuação do plugin no protocolo do relatório em todas as 50 perguntas reservadas. Isso inclui as 9 dos modelos de pergunta que tínhamos estudado, então toda pontuação desta página as deixa de fora.
- Amostras pequenas. O GeoExpertQueries tem 11 perguntas reservadas, e cada tipo de pergunta do GeoKTools tem de 3 a 5, então uma pergunta muda muito essas pontuações. A comparação em todas as 41 perguntas é a que vale citar.
- Só os agentes que testamos. Comparamos três arranjos: o Claude Sonnet 5.5 pelo servidor QGIS MCP do nkarasiak no Claude Code, o GPT-6 Luna pelo servidor QGIS MCP do jjsantos01 no Codex da OpenAI e o GPT-6 Luna sozinho. Outros modelos, outros servidores MCP e o próprio agente do Google do artigo não entram nesta comparação.
- Sem comparação direta no GeoBenchX nem no GS-QA2. As pontuações publicadas nesses benchmarks usam outros conjuntos de tarefas e outros avaliadores, então não colocamos o AI Agent em ranking contra elas.
Como instalar o plugin AI Agent para QGIS?
O plugin AI Agent para QGIS é gratuito no repositório oficial de plugins do QGIS, para o QGIS 3.28 e posteriores, incluindo o QGIS 4. No QGIS, abra Plugins, depois Manage and Install Plugins, procure por AI Agent by TerraLab, instale e entre na sua conta. Você não precisa de chave de API nem de cartão.
O plano gratuito inclui 5 tarefas por mês no esforço Low, o ajuste por trás de todas as pontuações acima. Os esforços Medium e High vêm com o Pro. O guia completo percorre uma primeira tarefa, e o que é um agente de IA no QGIS explica a ideia.
Perguntas frequentes
Qual é o melhor agente de IA para QGIS?
Entre todos os agentes de IA que testamos no QGIS nos benchmarks geoespaciais do Google, o plugin AI Agent para QGIS da TerraLab pontuou mais alto: 43,8 de 100 em 41 perguntas reservadas no esforço Low (GPT-6 Luna), contra 24,9 do Claude Sonnet 5.5 com o servidor QGIS MCP do nkarasiak no Claude Code e 22,1 do GPT-6 Luna com o servidor QGIS MCP do jjsantos01 no Codex da OpenAI. É um plugin gratuito no repositório oficial de plugins do QGIS.
Qual IA é a melhor para análise de GIS?
Para análise dentro do QGIS, o plugin AI Agent para QGIS teve a maior pontuação entre os agentes que testamos (43,8 de 100 no esforço Low, contra 24,9 do Claude Sonnet 5.5 com um servidor QGIS MCP no Claude Code) nos benchmarks GeoKTools e GeoExpertQueries do Google. Não testamos ferramentas para outros softwares de GIS, como as ferramentas GeoAI da Esri para o ArcGIS.
O ChatGPT funciona no QGIS?
O ChatGPT sozinho responde de memória e não consegue operar o QGIS. Conectado pelo servidor QGIS MCP do jjsantos01 no Codex da OpenAI, o GPT-6 Luna fez 39,5 no GeoKTools e 8,6 no GeoExpertQueries, mais ou menos o que o mesmo modelo faz sem ferramentas (44,2 e 0). Dentro do plugin AI Agent para QGIS no esforço Low, o mesmo modelo fez 53,5 e 62,6.
O Claude funciona com o QGIS?
Sim, por meio de um servidor QGIS MCP, como o plugin QGIS MCP do nkarasiak. No nosso teste, o Claude Sonnet 5.5 com esse servidor (versão 0.15.1) no Claude Code fez 33,3 no GeoKTools e 29,3 no GeoExpertQueries; o plugin AI Agent para QGIS no esforço Low (GPT-6 Luna) fez 53,5 e 62,6, e pontuou mais em 26 das 41 perguntas.
O que é um servidor QGIS MCP?
Uma ponte que permite a um modelo de chat como o Claude ou o ChatGPT chamar funções do QGIS pelo Model Context Protocol. O modelo passa a operar o QGIS, mas precisa encontrar os dados e conferir o trabalho sozinho. Nosso guia do QGIS MCP compara os servidores.
Quais são os benchmarks de raciocínio geoespacial do Google?
GeoKTools e GeoExpertQueries, publicados pelo Google Research em outubro de 2026 com o seu artigo sobre o Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). O GeoKTools faz perguntas factuais que exigem de um a quatro tipos de dados geoespaciais; o GeoExpertQueries faz problemas abertos de analistas, avaliados contra fluxos de trabalho escritos por especialistas.
Existe um benchmark que compara agentes de IA para GIS?
Sim, vários. GeoKTools e GeoExpertQueries do Google, GeoBenchX, GS-QA2, GISAgentBench e GeoNatureAgent testam agentes em tarefas geoespaciais, cada um com as suas perguntas e o seu avaliador, então as pontuações não se comparam entre benchmarks.
Como o AI Agent se sai em outros benchmarks geoespaciais?
No GeoBenchX, um benchmark público de tarefas de GIS em várias etapas, ele passou em 62,8% de 160 tarefas em duas execuções. No GS-QA2, perguntas espaciais sobre lugares dos EUA conferidas contra um instantâneo fixo de mapa, ele fez 61,1 de 100 com os dados do próprio benchmark. Nenhum outro agente rodou nas mesmas condições.
O plugin AI Agent para QGIS é gratuito?
Sim. O plano gratuito inclui 5 tarefas por mês no esforço Low, o ajuste por trás de todas as pontuações de benchmark daqui, sem chave de API e sem cartão. Os esforços Medium e High vêm com o Pro.