Plugin AI Agent para QGIS: el agente de IA más potente para QGIS
Publicado el
AI Agent de TerraLab es un plugin gratuito de QGIS que responde preguntas geoespaciales dentro de QGIS. En GeoKTools y GeoExpertQueries, los dos benchmarks geoespaciales que Google Research publicó en octubre de 2026, obtuvo 43.8 sobre 100 en 41 preguntas reservadas, frente a 24.9 de Claude Sonnet 5.5 con un servidor QGIS MCP, 22.1 de GPT-6 Luna con un servidor QGIS MCP y 21.0 de GPT-6 Luna solo. Es la puntuación más alta de todos los agentes de IA que probamos en QGIS, en ejecuciones del 16 al 20 de octubre de 2026 evaluadas con el propio código de evaluación de Google.
Haces una pregunta con palabras sencillas, sobre riesgo de inundación, tiempos de viaje o estrés hídrico. El plugin encuentra los datos, ejecuta el análisis con QGIS y añade el resultado a tu proyecto como capas, con sus fuentes indicadas.
- Plugin AI Agent para QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Precisión de 0 a 100 en GeoKTools y GeoExpertQueries, los benchmarks de Google Research para agentes geoespaciales (arXiv:2610.15750): las 41 preguntas reservadas sin relación con nuestro ajuste, evaluadas con el propio código de evaluación de Google, media de 3 ejecuciones. El plugin en effort Low, el ajuste del plan gratuito.
¿Qué puntuación obtuvo AI Agent en los benchmarks geoespaciales de Google?
| Plugin AI Agent para QGIS | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna solo | |
|---|---|---|---|---|
GeoKTools 30 preguntas Evaluador determinista y offline de Google Evaluador determinista | 53.5Effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 preguntas Protocolo del informe de Google: coincidencia exacta o, si no, juez Gemini 3.8 Flash Protocolo del informe de Google | 36.9Effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 preguntas Evaluador automático independiente de las herramientas, Gemini 3.8 Flash, 3 ejecuciones del juez Evaluador automático, 3 ejecuciones | 62.6Effort Low | 29.3 | 8.6 | 0.0 |
Las 41 preguntas 41 preguntas Ambos benchmarks, protocolo del informe de Google Protocolo del informe de Google | 43.8Effort Low | 24.9 | 22.1 | 21.0 |
Puntuaciones de 0 a 100, media de 3 ejecuciones por sistema, con los evaluadores de Google sin cambios: el evaluador determinista, el protocolo del informe y el evaluador automático de GeoExpertQueries. AI Agent se ejecutó en effort Low el 20 de octubre de 2026, Claude Sonnet 5.5 con un servidor QGIS MCP el 18 de octubre, GPT-6 Luna con un servidor QGIS MCP el 16 y el 17 de octubre, y GPT-6 Luna solo el 19 de octubre. La negrita marca la mejor puntuación de cada fila.
La ventaja se mantiene pregunta por pregunta. De las 41 preguntas, AI Agent obtuvo más que Claude Sonnet 5.5 con un servidor QGIS MCP en 26 y menos en 5, y más que GPT-6 Luna con un servidor QGIS MCP en 24 y menos en 7. Su ventaja media sobre Claude es de 19 puntos, entre 10 y 29 con un 95 % de confianza.
- Mayor
- Empate
- Menor
Para cada pregunta, la media del plugin en 3 ejecuciones comparada con la de Claude. Todo en effort Low.
¿Qué son GeoKTools y GeoExpertQueries?
Son los dos benchmarks que Google Research publicó junto con su artículo sobre el Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 de octubre de 2026). Las preguntas son públicas en el repositorio google-research/geospatial-reasoning-benchmarks, con licencia CC BY 4.0; Google mantiene privadas sus preguntas oficiales de prueba.
- GeoKTools plantea preguntas de hechos cuyas respuestas requieren de uno a cuatro tipos de datos geoespaciales: un límite administrativo, una estadística, un registro meteorológico, un recuento de lugares. El evaluador determinista de Google da crédito parcial con una tolerancia del 10 % en los números; su protocolo del informe exige una coincidencia exacta o la aprobación de un juez.
- GeoExpertQueries plantea problemas abiertos como los que recibiría un analista, en ámbitos como la selección de emplazamientos, los riesgos naturales y la salud pública. El evaluador automático de Google califica cada respuesta frente a flujos de trabajo escritos por expertos.
¿Qué puede hacer un agente de IA en QGIS?
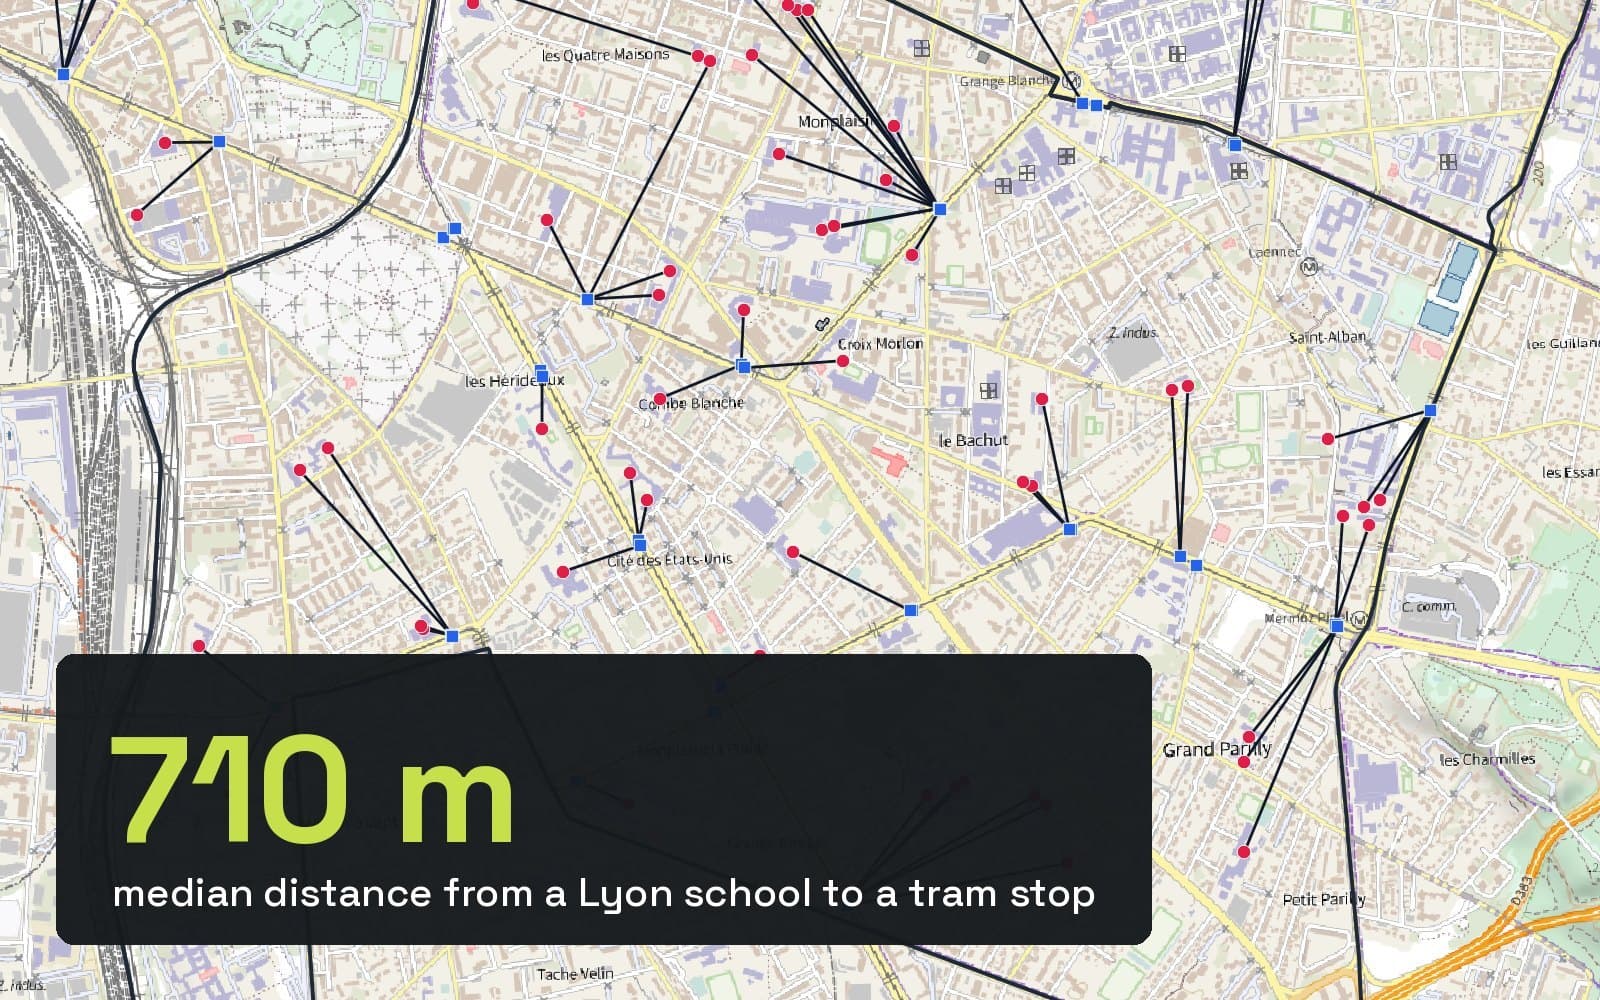
Responde preguntas sobre lugares trabajando con datos reales dentro de QGIS: encuentra conjuntos de datos, ejecuta análisis espaciales como tiempos de viaje, superposiciones o estadísticas por área, y devuelve un mapa con sus fuentes. Tres ejemplos, cada uno grabado desde un proyecto de QGIS vacío en effort Low, el ajuste del plan gratuito. El primero viene del artículo de Google. Escribimos los otros dos con el mismo estilo, y ninguno está entre las preguntas evaluadas.
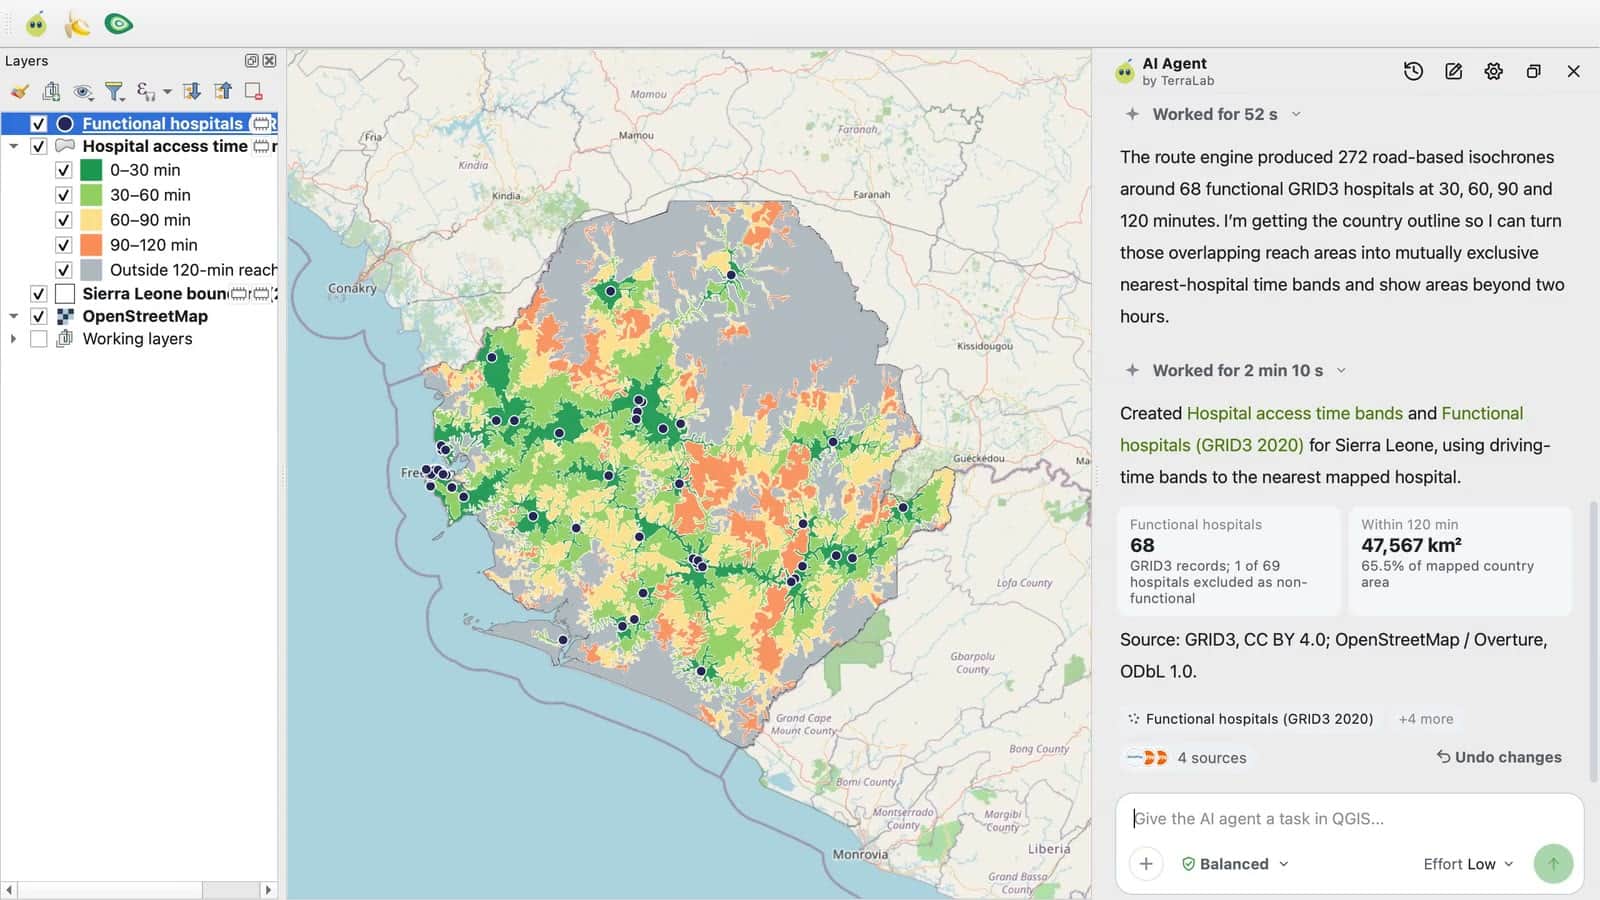
- Pregunta
- Cartografía el tiempo que necesita una mujer embarazada para llegar al hospital más cercano en un parto de urgencia, desde cualquier punto de Sierra Leona. Usa el tiempo de viaje, no la distancia en línea recta.
- Respuesta
- El plugin primero preguntó cómo se desplaza la gente y qué centros deben contar. Con el coche y todos los hospitales cartografiados como aproximación, cartografió el tiempo hasta el más cercano de 68 hospitales en franjas de 30 minutos: el 65.5 % del país cartografiado queda a menos de dos horas. Unos 5 minutos.
- Por qué es difícil
- Necesita el tiempo de viaje por carretera en todo un país, no la distancia en línea recta, y una decisión sobre qué centros cuentan que ningún modelo puede tomar de memoria.
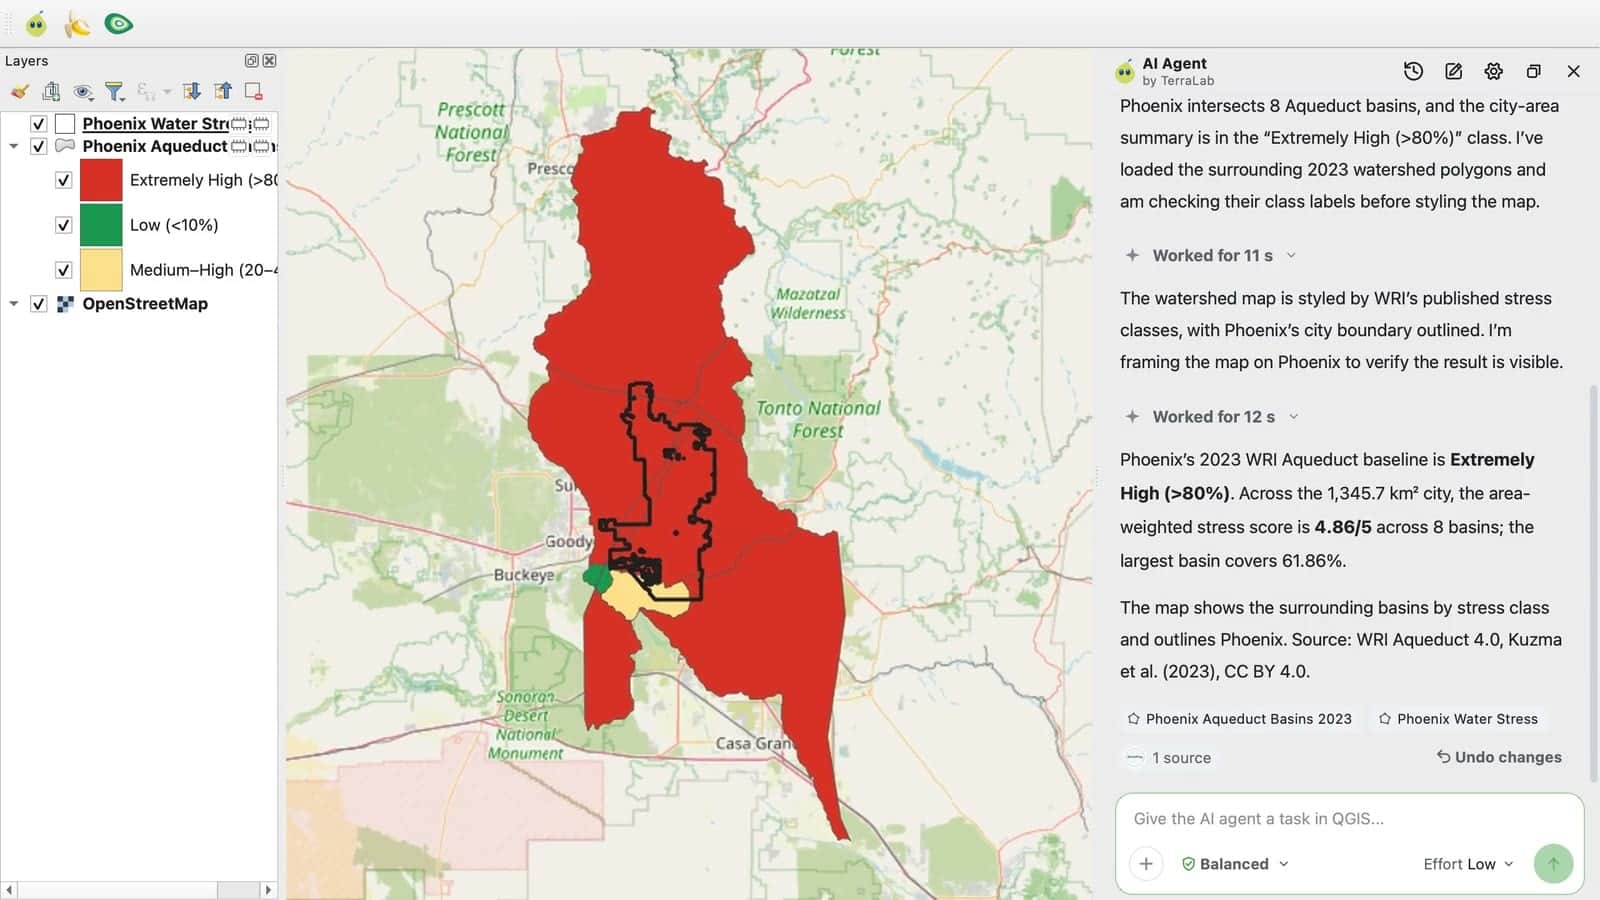
- Pregunta
- ¿Qué nivel de estrés hídrico tiene la zona de Phoenix, Arizona? Indica el estrés hídrico de referencia de WRI Aqueduct allí y muéstralo en el mapa.
- Respuesta
- Extremadamente alto, por encima del 80 %. Las 8 cuencas de WRI Aqueduct que cruzan la ciudad dan una puntuación ponderada por área de 4.86 sobre 5, con la fuente y su licencia indicadas. Aproximadamente un minuto.
- Por qué es difícil
- La respuesta tiene que salir de un único conjunto de datos con nombre, combinado en todas las cuencas que toca la ciudad, no de lo que un modelo recuerda sobre Phoenix.
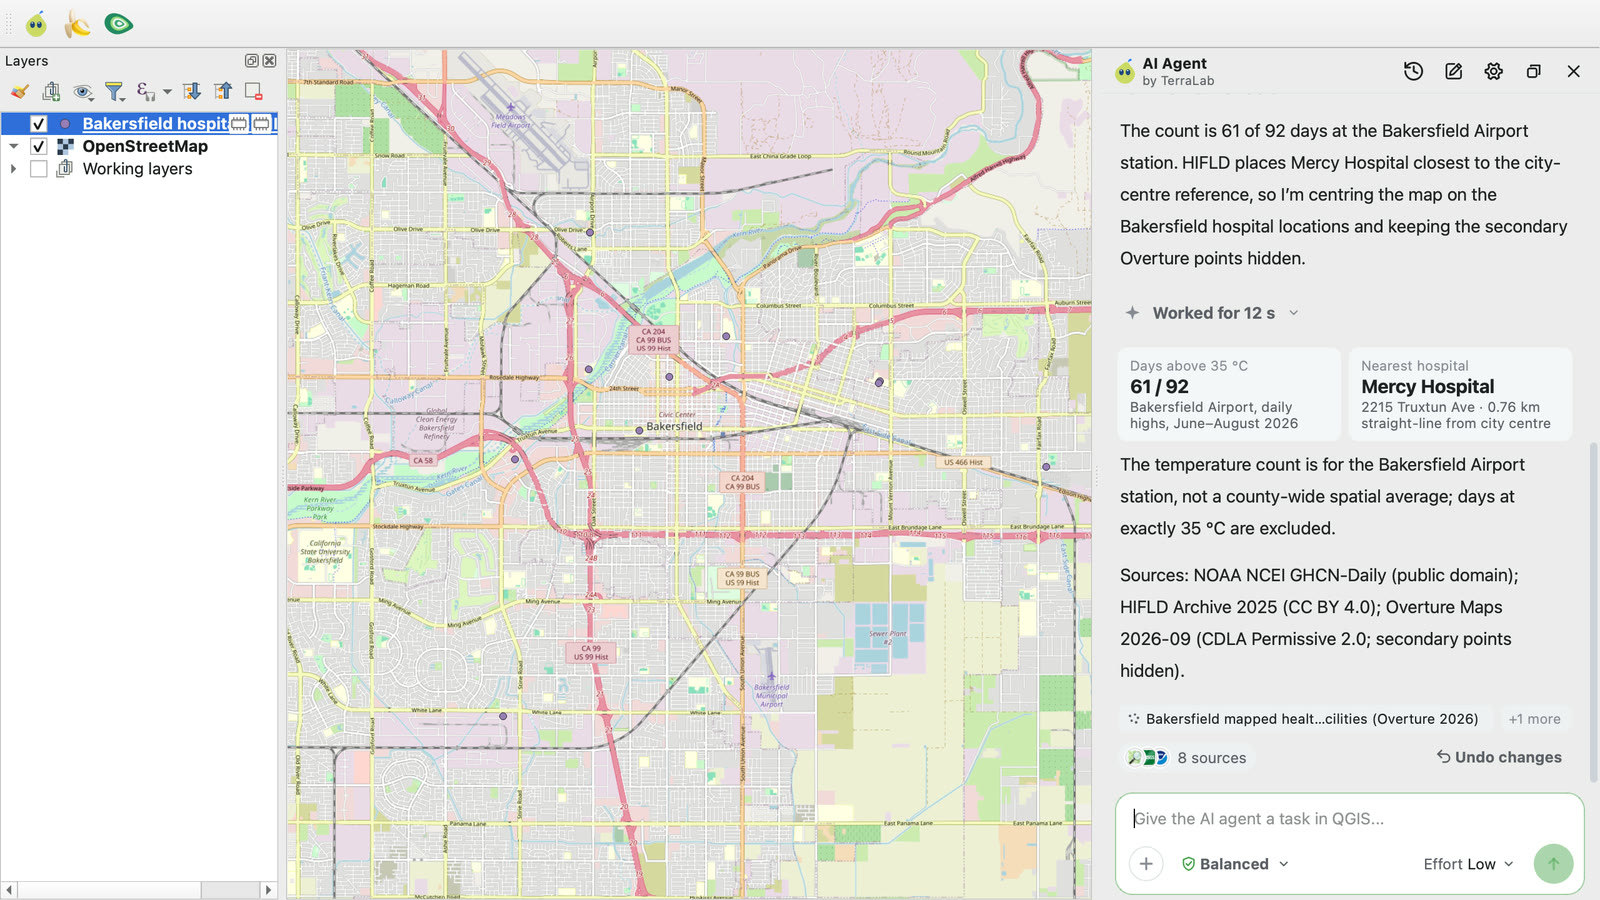
- Pregunta
- ¿Cuántos días superaron los 35 °C en el condado de Kern, California, el verano pasado (de junio a agosto de 2026)? ¿Y cuál es el hospital más cercano a Bakersfield, la sede del condado?
- Respuesta
- 61 de 92 días por encima de 35 °C en la estación del aeropuerto de Bakersfield, con una nota que aclara que es una sola estación, no un promedio del condado. El hospital más cercano es el Mercy Hospital, a 0.76 km del centro de la ciudad. Unos 2 minutos.
- Por qué es difícil
- Combina tres fuentes, registros meteorológicos diarios, un registro de hospitales y un mapa de lugares, para un verano demasiado reciente para responder de memoria.
¿Es mejor un plugin de IA para QGIS que Claude o ChatGPT con un servidor QGIS MCP?
En estos benchmarks, sí. Un servidor QGIS MCP conecta un modelo de chat como Claude o ChatGPT con QGIS mediante el Model Context Protocol, de modo que el modelo puede llamar a funciones de QGIS. Así el modelo puede manejar QGIS, pero sigue teniendo que encontrar los datos, elegir cada paso y comprobar su propio trabajo. Un modelo de lenguaje sin conexión responde de memoria.
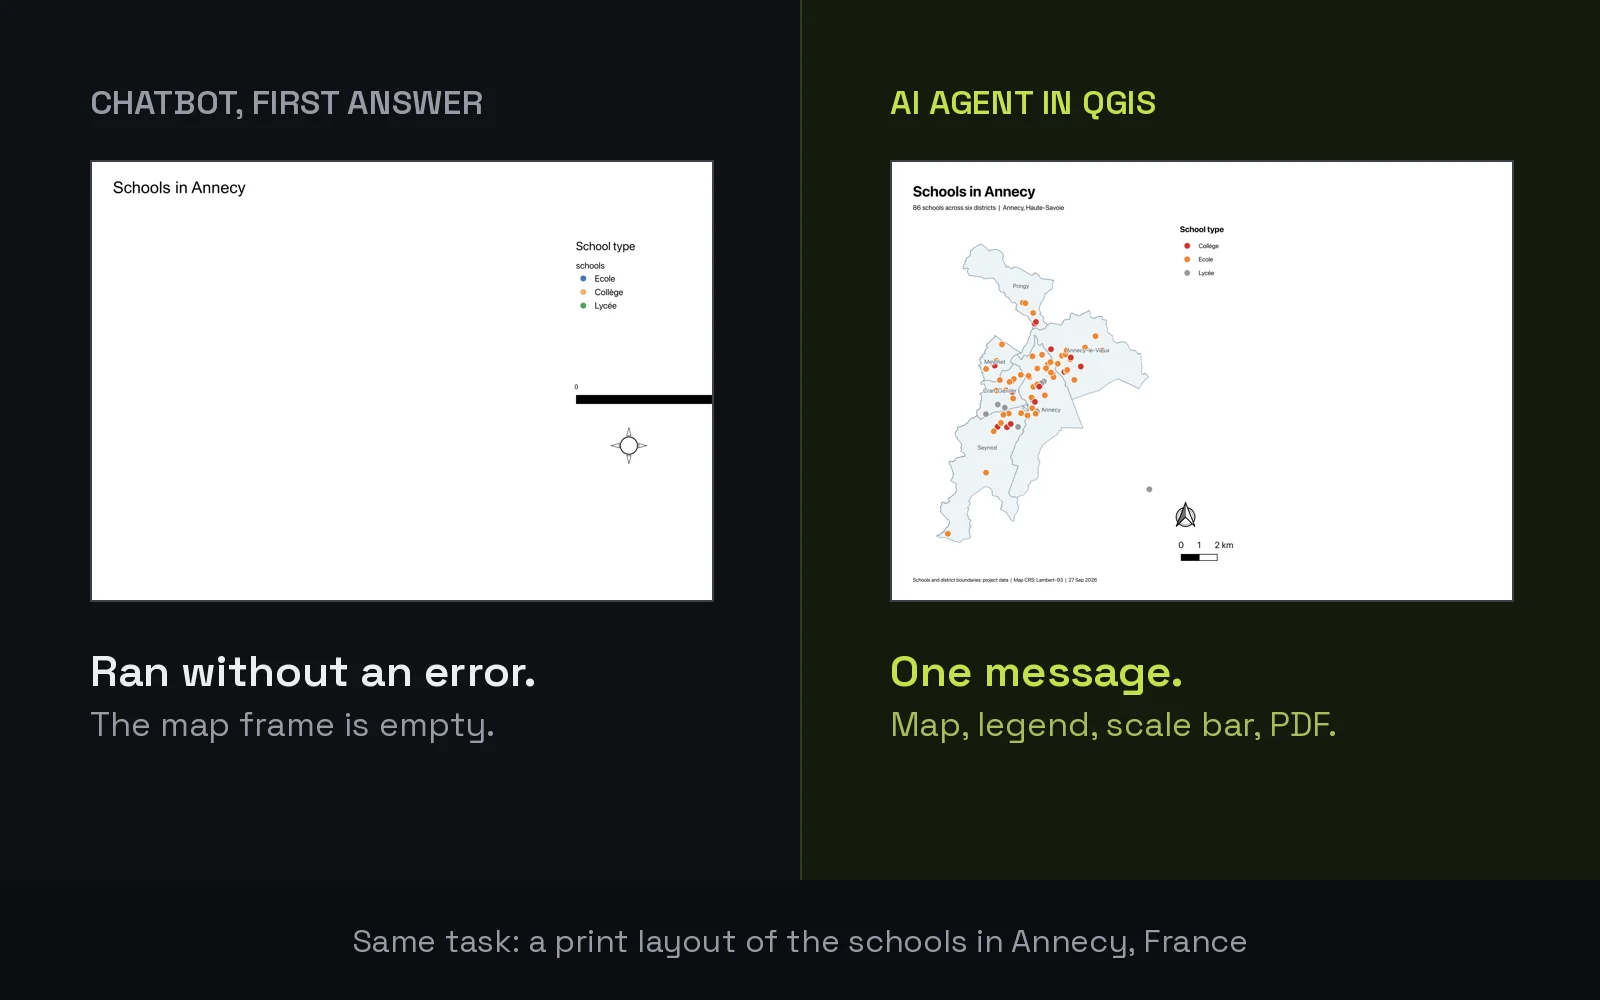
El plugin AI Agent para QGIS le da al modelo lo que necesita para el trabajo geoespacial: herramientas hechas para SIG, datos con licencia que puede usar y una comprobación de cada resultado antes de responder. Funciona directamente dentro de QGIS, así que el modelo actúa sobre capas reales con herramientas reales de QGIS, y puedes abrir cada resultado en tu proyecto.
La comparación más clara es un mismo modelo de tres maneras. Por sí solo, GPT-6 Luna recuerda algunas respuestas de GeoKTools y obtiene 0 en todas las tareas de GeoExpertQueries. Conectado a QGIS mediante un servidor MCP general, obtiene casi lo mismo. Dentro del plugin en effort Low, el mismo modelo obtiene 53.5 en GeoKTools y 62.6 en GeoExpertQueries.
- GPT-6 Luna solo
- GPT-6 Luna + QGIS MCP
- Plugin AI Agent para QGIS
GeoKTools con el evaluador determinista de Google, GeoExpertQueries con su evaluador automático. La ejecución con QGIS MCP usó un servidor y un cliente distintos de los de la ejecución con Claude (véase ¿Cómo hicimos las pruebas?). El effort Low del plugin ejecuta GPT-6 Luna.
El plugin lidera en todos los niveles de dificultad. Cada pregunta de GeoKTools necesita varios tipos de datos. Con dos tipos, obtiene una puntuación muy por delante de cualquier otro sistema. Con cuatro, todos los sistemas tienen dificultades, y el plugin sigue por delante.
- Plugin AI Agent para QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna solo
- AI Agent, datos en vivo
Evaluado con el protocolo del informe de Google, en las 30 preguntas reservadas de GeoKTools sin relación con nuestro ajuste: 20 necesitan dos tipos de datos, 5 necesitan tres y 5 necesitan cuatro. Toda pregunta que necesitaba uno procedía de una plantilla que estudiamos antes de la división, así que ese grupo queda fuera.
- Plugin AI Agent para QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Evaluador determinista de Google. Cada tipo tiene de 3 a 5 preguntas, así que una sola pregunta mueve mucho su puntuación. El plugin supera a Claude en todos los tipos excepto en el de áreas inundadas según la previsión, que ningún sistema responde. GPT-6 Luna con QGIS MCP va un punto por delante en lugares en un anillo. Los dos tipos que estudiamos antes de la división, el estrés hídrico alrededor de un punto y el punto extremo de un área, quedan fuera.
- Plugin AI Agent para QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Evaluador automático de Google, independiente de las herramientas. Salud pública tiene solo 2 preguntas, así que una sola pregunta mueve mucho su puntuación; el plugin y Claude empatan ahí, y GPT-6 Luna solo obtuvo 0 en todos los ámbitos.
¿Cómo puntúa AI Agent en otros benchmarks de SIG?
También ejecutamos AI Agent en dos benchmarks públicos ajenos a Google, sin que nada de AI Agent estuviera ajustado para ninguno de los dos. Nuestro propio código evaluó cada respuesta frente a las respuestas de referencia de cada benchmark. Ningún otro agente se ejecutó en las mismas condiciones, así que aquí no hay comparación directa.
GeoBenchX: 62.8 % de 160 tareas
GeoBenchX (arXiv:2503.18129) pide trabajo SIG de varios pasos con datos abiertos: unir tablas, procesar capas y cartografiar países, ciudades y regiones. Algunas tareas piden algo que los datos no pueden dar, y la respuesta correcta es decirlo. AI Agent superó el 62.8 % de las 160 tareas de media en dos ejecuciones.
- Plugin AI Agent para QGIS
Evaluado por código frente a las soluciones de referencia reproducidas del benchmark, sin juez de IA. La puntuación global es la media de dos ejecuciones, 65.0 % y 60.6 %; las otras dos filas salen de la primera ejecución. Los resultados propios de GeoBenchX y la tabla de Axis Spatial evalúan con un juez de IA sobre un conjunto distinto de tareas, así que no ponemos nuestra puntuación junto a las suyas.
GS-QA2: 61.1 sobre 100 en 245 preguntas
GS-QA2, de Shang et al. en UC Riverside, plantea preguntas espaciales sobre lugares de Estados Unidos: el elemento más cercano, una dirección o una distancia, la pendiente, la orientación o la elevación del terreno. Cada respuesta de referencia sale de una instantánea fija de OpenStreetMap y de un modelo de elevación. Con esos mismos datos, AI Agent obtiene 61.1 sobre 100. Con los datos actuales en vivo obtiene 22.0, porque los lugares añadidos, renombrados o redibujados desde la instantánea ya no coinciden con la referencia. GPT-6 Luna por sí solo, el modelo que AI Agent ejecuta en effort Low, obtiene 15.1.
- Plugin AI Agent para QGIS
- AI Agent, datos en vivo
- GPT-6 Luna solo
Puntuación de 0 a 100, media de las 49 plantillas de preguntas del benchmark, 3 ejecuciones. Evaluado por código con las tolerancias del artículo, sin juez de IA. Axis Spatial publica puntuaciones de GS-QA2 en el mismo entorno de datos, pero sobre otra selección de preguntas y con un verificador privado, así que no son comparables.
Otros benchmarks públicos para agentes de SIG son GISAgentBench y GeoNatureAgent. No hemos ejecutado AI Agent en ellos, así que esta página no da ninguna puntuación para ellos.
¿Cómo hicimos las pruebas?
- Google Research publicó GeoKTools y GeoExpertQueries con su artículo (arXiv:2610.15750), junto con preguntas de práctica; mantiene privadas sus preguntas oficiales de prueba. Esta es nuestra propia ejecución sobre las preguntas públicas, no una clasificación de Google.
- Mejoramos el agente con la mitad de las preguntas públicas y lo medimos en las otras 50, divididas por plantilla de pregunta. Antes de esa división, mientras explorábamos el benchmark, habíamos estudiado dos plantillas con sus respuestas. Nueve de las 50 preguntas proceden de ellas, así que las dejamos fuera: todas las puntuaciones de aquí corresponden a las otras 41, las preguntas reservadas sin relación con nuestro ajuste.
- Todos los sistemas recibieron las mismas preguntas, las mismas instrucciones y límites, un proyecto de QGIS vacío y 3 intentos. El código de evaluación propio de Google evaluó cada respuesta.
- Ejecutamos el plugin en effort Low (GPT-6 Luna, en el plan gratuito) y en effort High (un modelo distinto que planifica con más profundidad, en Pro). Low obtuvo más en ambos benchmarks, así que todas las puntuaciones mostradas son de Low.
- Claude Sonnet 5.5 se ejecutó en Claude Code con el plugin QGIS MCP de nkarasiak, versión 0.15.1, con sus propias herramientas de shell, web y archivos desactivadas, el 18 de octubre. GPT-6 Luna + QGIS MCP se ejecutó en la CLI Codex de OpenAI con el servidor qgis_mcp de jjsantos01, el 16 y el 17 de octubre. GPT-6 Luna solo respondió sin herramientas.
Detalles técnicos
Benchmarks: GeoKTools y GeoExpertQueries de google-research/geospatial-reasoning-benchmarks, commit c21a6d95, datos con licencia CC BY 4.0. La división pública de desarrollo (85 preguntas de GeoKTools, 25 de GeoExpertQueries) se cortó en dos por plantilla de pregunta; la mitad reservada tiene 39 preguntas de GeoKTools y 11 de GeoExpertQueries. Antes de la división, habíamos revisado las respuestas de referencia de dos plantillas de GeoKTools, punto extremo de un área y estrés hídrico alrededor de un punto; sus 9 preguntas cayeron en la mitad reservada y quedan fuera de todas las puntuaciones, lo que deja 30 preguntas de GeoKTools y 11 de GeoExpertQueries. Cada sistema recibió el prefijo de prompt de Google, como máximo 100 llamadas al modelo y 30 minutos por pregunta, y 3 ejecuciones completas; una ejecución fallida o con tiempo agotado puntúa 0. Evaluadores, sin cambios: el evaluador determinista de GeoKTools (tolerancia del 10 % en los números, crédito parcial, ROUGE-L en el texto); el protocolo del informe de GeoKTools (coincidencia exacta y, si no, un juez Gemini 3.8 Flash); el evaluador automático de GeoExpertQueries independiente de las herramientas (Gemini 3.8 Flash, 3 ejecuciones del juez por respuesta). El intervalo del 95 % es un bootstrap pareado sobre las preguntas. Ejecuciones: el plugin en effort Low y High el 20 de octubre de 2026; Claude + QGIS MCP el 18 de octubre; GPT-6 Luna solo el 19 de octubre. Se comprobaron las llamadas a herramientas de cada intento para detectar lecturas del repositorio del benchmark, de su archivo de preguntas o del artículo, y un acierto puntúa 0: el plugin no tuvo ninguno, las ejecuciones de GPT-6 Luna + QGIS MCP tuvieron 2. Los intentos fallidos, rechazados o con tiempo agotado puntúan 0 y se mantienen en las medias (7 de 150 para GPT-6 Luna + QGIS MCP, ninguno de los 150 del plugin en Low).
GeoBenchX: Solirinai/GeoBenchX en el commit 0edf6109, licencia MIT, 202 tareas, descrito en arXiv:2503.18129. Dejamos fuera 23 tareas excluidas por una auditoría publicada, 3 preguntas de control y 16 cuya solución de referencia no se reproduce o pide una cifra que la referencia no calcula, lo que deja 160. AI Agent ejecutó cada tarea en dos ejecuciones separadas en effort Low el 20 de octubre de 2026, en QGIS, con los datos de la tarea en una carpeta junto a un proyecto vacío: 65.0 % (intervalo del 95 % de 56.9 a 72.5) y 60.6 %. En la primera ejecución resolvió 46 de las 92 tareas que tienen respuesta, rechazó 55 de las 62 que no se pueden resolver y superó 3 de las 6 que aceptan ambas opciones. Evaluado por código, sin juez de IA, frente a la solución de referencia reproducida: los valores que muestra el mapa, el número de elementos, el número que indica la respuesta, o ningún mapa en absoluto para las tareas que no se pueden resolver.
GS-QA2: Zoe/GS-QA2 en la revisión 0ccf9453, de Shang et al. (UC Riverside), ODbL 1.0, © colaboradores de OpenStreetMap; ASTER GDEM es un producto de METI y la NASA. 245 preguntas, 5 de cada una de las 49 plantillas, seleccionadas con la misma regla que la tabla de Axis Spatial pero no las mismas preguntas. Tres entornos, 3 ejecuciones cada uno: AI Agent en effort Low con las tablas de OpenStreetMap y la elevación ASTER del benchmark, recortadas a las áreas de las preguntas, en una carpeta junto a un proyecto vacío, con un prompt que solo dice dónde están los datos (61.1, intervalo del 95 % de 57.1 a 65.2); AI Agent en effort Low desde un proyecto vacío con datos en vivo (22.0, de 19.0 a 25.2); GPT-6 Luna solo, una llamada sin herramientas (15.1, de 12.2 a 18.1). La respuesta final se comprueba frente a cada fila de referencia con las tolerancias del artículo: nombres por solapamiento de tokens, ubicaciones a menos de 5 m, rumbo, orientación y pendiente a menos de 5°, elevación a menos de 10 m, distancias, áreas y recuentos a menos del 5 %.
¿Qué no muestran estos resultados?
- Nuestra ejecución, sobre preguntas públicas. Google mantiene privadas sus preguntas de prueba. Estas puntuaciones salen de las preguntas públicas, ejecutadas y evaluadas por nosotros con el código de Google.
- 41 preguntas, no 50. Nuestras publicaciones de anuncio citan 52.9, la puntuación del plugin con el protocolo del informe en las 50 preguntas reservadas. Eso incluye las 9 de las plantillas que habíamos estudiado, así que todas las puntuaciones de esta página las dejan fuera.
- Muestras pequeñas. GeoExpertQueries tiene 11 preguntas reservadas, y cada tipo de pregunta de GeoKTools tiene de 3 a 5, así que una sola pregunta mueve mucho esas puntuaciones. La comparación sobre las 41 preguntas es la que conviene citar.
- Solo los agentes que probamos. Comparamos tres configuraciones: Claude Sonnet 5.5 y GPT-6 Luna, cada uno con un servidor QGIS MCP de la comunidad, y GPT-6 Luna solo. Otros modelos, otros servidores MCP y el propio agente de Google del artículo no forman parte de esta comparación.
- Sin comparación directa en GeoBenchX ni GS-QA2. Las puntuaciones publicadas en esos benchmarks usan otros conjuntos de tareas y otros evaluadores, así que no clasificamos a AI Agent frente a ellas.
¿Cómo se instala el plugin AI Agent para QGIS?
El plugin AI Agent para QGIS es gratuito en el repositorio oficial de plugins de QGIS, para QGIS 3.28 y posteriores, QGIS 4 incluido. En QGIS, abre Plugins, luego Manage and Install Plugins, busca AI Agent de TerraLab, instálalo e inicia sesión. No necesitas clave de API ni tarjeta.
El plan gratuito incluye 5 tareas al mes en effort Low, el ajuste detrás de todas las puntuaciones anteriores. Medium y High vienen con Pro. La guía completa recorre una primera tarea, y qué es un agente de IA en QGIS explica la idea.
Preguntas frecuentes
¿Cuál es el mejor agente de IA para QGIS?
De todos los agentes de IA que probamos en QGIS con los benchmarks geoespaciales de Google, el plugin AI Agent para QGIS de TerraLab obtuvo la puntuación más alta: 43.8 sobre 100 en 41 preguntas reservadas, frente a 24.9 de Claude Sonnet 5.5 con un servidor QGIS MCP y 22.1 de GPT-6 Luna con un servidor QGIS MCP. Es un plugin gratuito en el repositorio oficial de plugins de QGIS.
¿Qué IA es la mejor para el análisis SIG?
Para el análisis dentro de QGIS, el plugin AI Agent para QGIS obtuvo la puntuación más alta de los agentes que probamos en los benchmarks GeoKTools y GeoExpertQueries de Google. No probamos herramientas para otro software SIG, como las herramientas GeoAI de Esri para ArcGIS.
¿Puede ChatGPT funcionar en QGIS?
ChatGPT por sí solo responde de memoria y no puede manejar QGIS. Conectado mediante un servidor QGIS MCP en Codex de OpenAI, GPT-6 Luna obtuvo 39.5 en GeoKTools y 8.6 en GeoExpertQueries, casi lo mismo que obtiene el mismo modelo sin herramientas. Dentro del plugin AI Agent para QGIS, el mismo modelo obtuvo 53.5 y 62.6.
¿Puede Claude trabajar con QGIS?
Sí, mediante un servidor QGIS MCP como el plugin QGIS MCP de nkarasiak. En nuestra prueba, Claude Sonnet 5.5 con ese servidor obtuvo 33.3 en GeoKTools y 29.3 en GeoExpertQueries; el plugin AI Agent para QGIS obtuvo 53.5 y 62.6, y más puntos en 26 de las 41 preguntas.
¿Qué es un servidor QGIS MCP?
Un puente que permite a un modelo de chat como Claude o ChatGPT llamar a funciones de QGIS mediante el Model Context Protocol. Así el modelo puede manejar QGIS, pero tiene que encontrar los datos y comprobar su trabajo por su cuenta. Nuestra guía de QGIS MCP compara los servidores.
¿Qué son los benchmarks de razonamiento geoespacial de Google?
GeoKTools y GeoExpertQueries, publicados por Google Research en octubre de 2026 con su artículo sobre el Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). GeoKTools plantea preguntas de hechos que necesitan de uno a cuatro tipos de datos geoespaciales; GeoExpertQueries plantea problemas abiertos de analistas, evaluados frente a flujos de trabajo escritos por expertos.
¿Existe algún benchmark que compare agentes de IA para SIG?
Sí, varios. GeoKTools y GeoExpertQueries de Google, GeoBenchX, GS-QA2, GISAgentBench y GeoNatureAgent prueban agentes en tareas geoespaciales, cada uno con sus propias preguntas y su propio evaluador, así que sus puntuaciones no se pueden comparar entre benchmarks.
¿Cómo le va a AI Agent en otros benchmarks geoespaciales?
En GeoBenchX, un benchmark público de tareas SIG de varios pasos, superó el 62.8 % de las 160 tareas en dos ejecuciones. En GS-QA2, preguntas espaciales sobre lugares de EE. UU. comprobadas frente a una instantánea fija del mapa, obtuvo 61.1 sobre 100 con los datos del propio benchmark. Ningún otro agente se ejecutó en las mismas condiciones.
¿Es gratuito el plugin AI Agent para QGIS?
Sí. El plan gratuito incluye 5 tareas al mes en effort Low, el ajuste detrás de todas las puntuaciones de benchmark de aquí, sin clave de API ni tarjeta. Medium y High vienen con Pro.