QGIS AIプラグイン AI Agent:QGIS向け最強のAIエージェント
公開日
TerraLabのAI Agentは、QGISの中で地理空間の質問に答える無料のQGISプラグインです。Google Researchが2026年10月に公開した2つの地理空間ベンチマーク、GeoKToolsとGeoExpertQueriesで、ホールドアウトの41問に対して100点満点中43.8点を記録しました。QGIS MCPサーバー付きClaude Sonnet 5.5は24.9点、QGIS MCPサーバー付きGPT-6 Lunaは22.1点、GPT-6 Luna単体は21.0点です。これは、QGISでテストしたすべてのAIエージェントの中で最も高い得点で、2026年10月16日から20日の実行を、Google自身の採点コードで採点した結果です。
質問は普通の言葉で入力します。洪水リスク、移動時間、水ストレスなど、何でも構いません。プラグインがデータを見つけ、QGISで分析を実行し、情報源を明記したうえで、結果をレイヤとしてプロジェクトに追加します。
- AI Agent QGISプラグイン
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
0から100の正答率です。GeoKToolsとGeoExpertQueriesは、Google Researchが公開した地理空間エージェント向けのベンチマークです(arXiv:2610.15750)。対象は、私たちのチューニングと無関係なホールドアウトの41問で、Google自身の採点コードで採点し、3回実行の平均を示しています。プラグインはLow effort、つまり無料プランの設定で実行しました。
AI Agentは、Googleの地理空間ベンチマークで何点を取りましたか?
| AI Agent QGISプラグイン | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna単体 | |
|---|---|---|---|---|
GeoKTools 30問 Googleの決定論的オフライン採点 決定論的採点 | 53.5Low effort | 33.3 | 39.5 | 44.2 |
GeoKTools 30問 Googleのレポート方式:完全一致、なければ Gemini 3.8 Flash が判定 Googleのレポート方式 | 36.9Low effort | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11問 ツール非依存のオートレーター、Gemini 3.8 Flash、判定3回 オートレーター、判定3回 | 62.6Low effort | 29.3 | 8.6 | 0.0 |
全41問 41問 両ベンチマーク、Googleのレポート方式 Googleのレポート方式 | 43.8Low effort | 24.9 | 22.1 | 21.0 |
スコアは0から100で、システムごとに3回実行の平均です。採点はすべてGoogle自身のものを、変更せずに使いました。決定論的採点、レポート方式、GeoExpertQueriesのオートレーターです。AI AgentはLow effortで2026年10月20日に、QGIS MCPサーバー付きClaude Sonnet 5.5は10月18日に、QGIS MCPサーバー付きGPT-6 Lunaは10月16日と17日に、GPT-6 Luna単体は10月19日に実行しました。太字は各行の最高得点です。
リードは質問ごとに見ても変わりません。41問のうち、AI Agentは、QGIS MCPサーバー付きClaude Sonnet 5.5より26問で高く5問で低く、QGIS MCPサーバー付きGPT-6 Lunaより24問で高く7問で低い結果でした。Claudeに対する平均のリードは19ポイントで、95%信頼区間は10から29です。
- 上回る
- 同点
- 下回る
質問ごとに、プラグインの3回平均をClaudeの平均と比べています。すべてLow effortです。
GeoKToolsとGeoExpertQueriesとは何ですか?
Google Researchが、Google Earth AI Geospatial Reasoning Agentに関する論文とあわせて公開した2つのベンチマークです(arXiv:2610.15750、2026年10月11日)。問題はgoogle-research/geospatial-reasoning-benchmarksリポジトリにCC BY 4.0で公開されています。Googleは公式のテスト問題を非公開にしています。
- GeoKToolsは、答えに1〜4種類の地理空間データが必要な事実の質問です。境界、統計、気象記録、場所の数などがあります。Googleの決定論的採点は、数値に10%の許容誤差を認めて部分点を与えます。レポート方式は、完全一致か、判定者の承認を求めます。
- GeoExpertQueriesは、アナリストが実際に受けるような自由回答の課題で、立地選定、自然災害、公衆衛生などの分野があります。Googleのオートレーターが、専門家が書いたワークフローに照らして各回答を採点します。
AIエージェントはQGISで何ができますか?
場所についての質問に、QGISの中の実データを使って答えます。データセットを探し、移動時間、オーバーレイ、地域ごとの統計といった空間分析を実行し、情報源つきの地図を返します。以下の3つの例は、どれも空のQGISプロジェクトから、無料プランの設定であるLow effortで撮影しました。最初の例はGoogleの論文に載っている質問です。残りの2つは同じスタイルで私たちが作ったもので、3つとも採点対象の質問には含まれません。
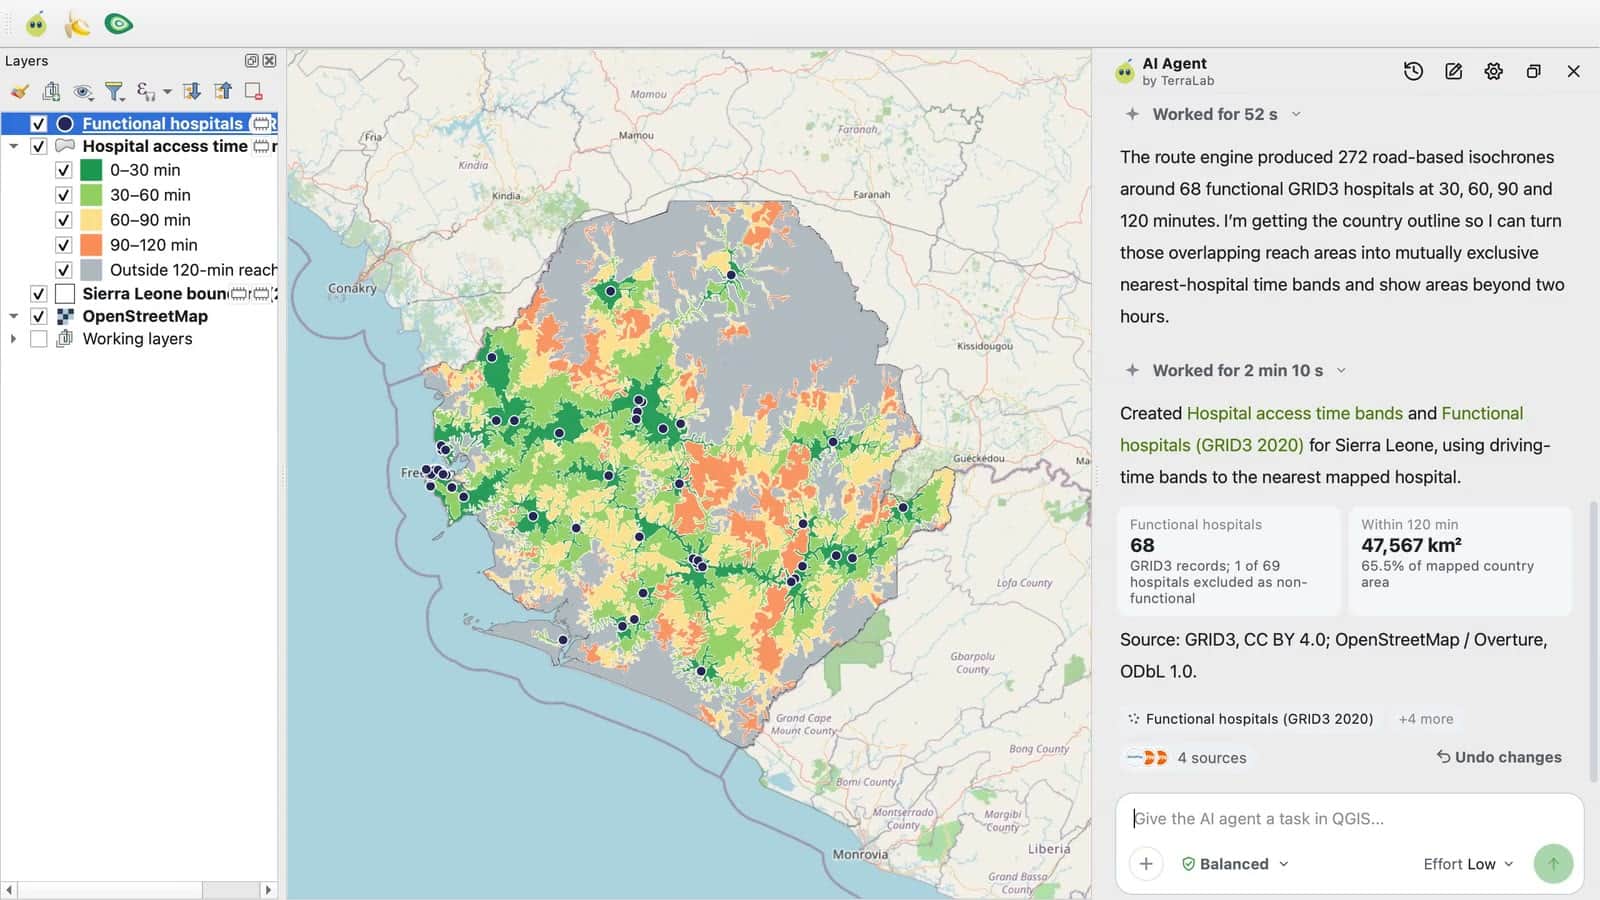
- 質問
- 妊婦がシエラレオネのどこからでも、緊急分娩のために最寄りの病院へ行く移動時間を地図にしてください。直線距離ではなく、移動時間を使ってください。
- 答え
- プラグインはまず、人々の移動手段と、どの施設を対象にするかを尋ねました。移動手段を自動車、対象を地図上のすべての病院として、最寄りの68病院までの時間を30分刻みで地図にしました。地図化された国土の65.5%が2時間圏内にあります。所要時間は約5分です。
- 難しい理由
- 国全体の道路での移動時間が必要で、直線距離は使えません。さらに、どの施設を数えるかという判断も必要で、モデルが記憶だけで決められるものではありません。
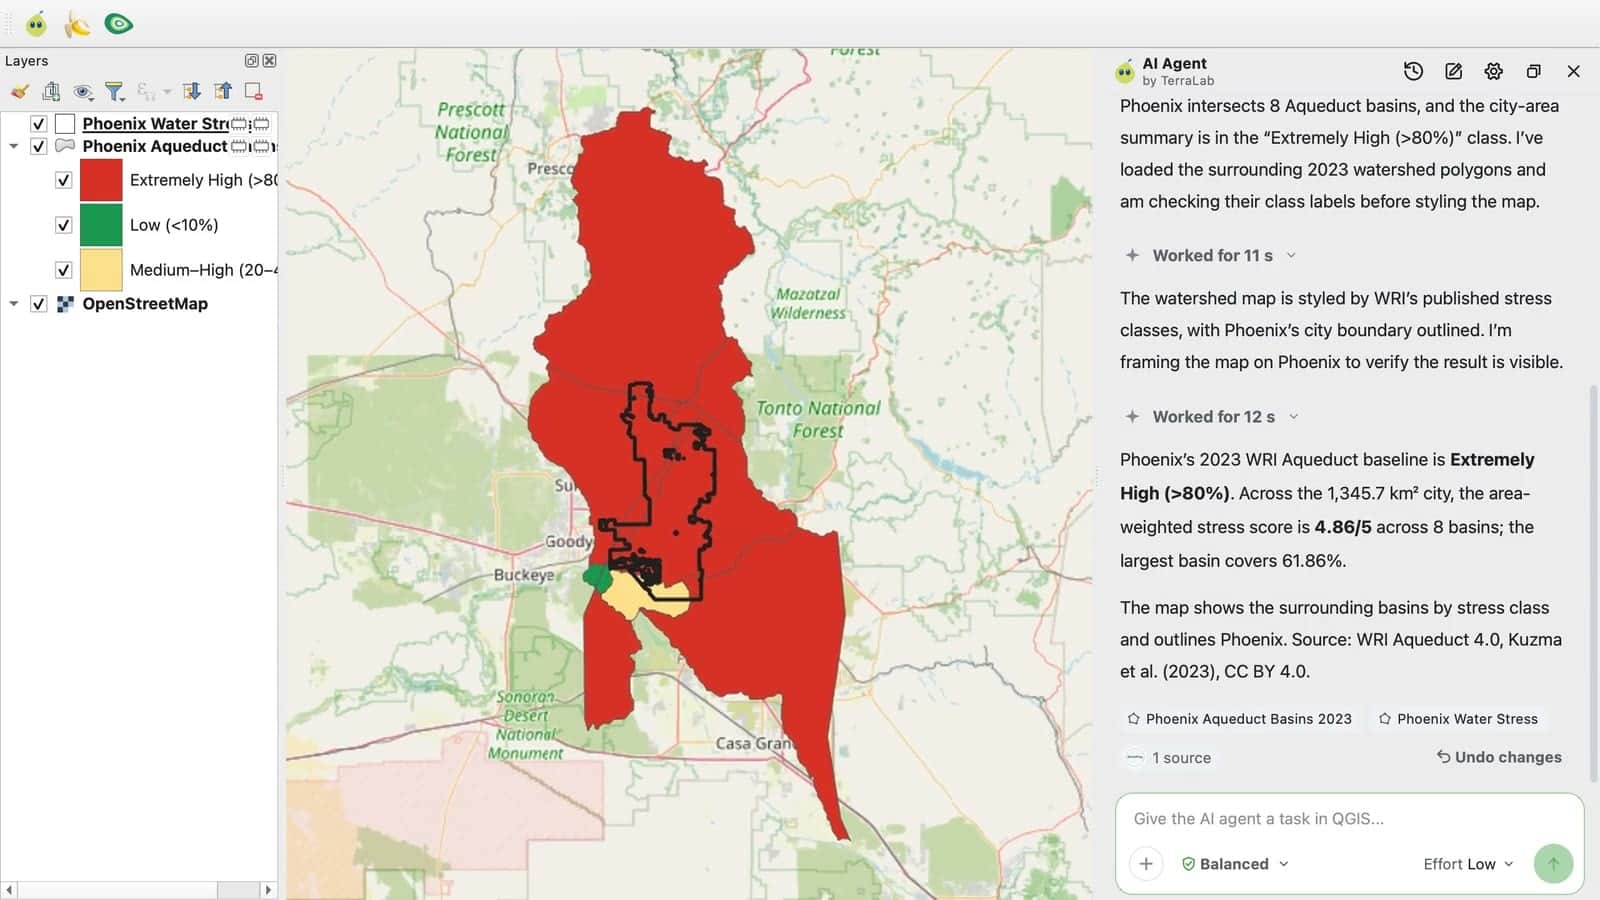
- 質問
- アリゾナ州フェニックス周辺の水ストレスはどの程度ですか。WRI Aqueductのベースライン水ストレスを答え、地図に表示してください。
- 答え
- Extremely High(極めて高い)で、80%を超えています。市を横切るWRI Aqueductの8流域の面積加重スコアは5点満点中4.86で、情報源とライセンスも明記されました。所要時間は約1分です。
- 難しい理由
- 回答は、名前の挙がった1つのデータセットから、市と重なるすべての流域を合算して出す必要があり、モデルがフェニックスについて記憶していることに頼ることはできません。
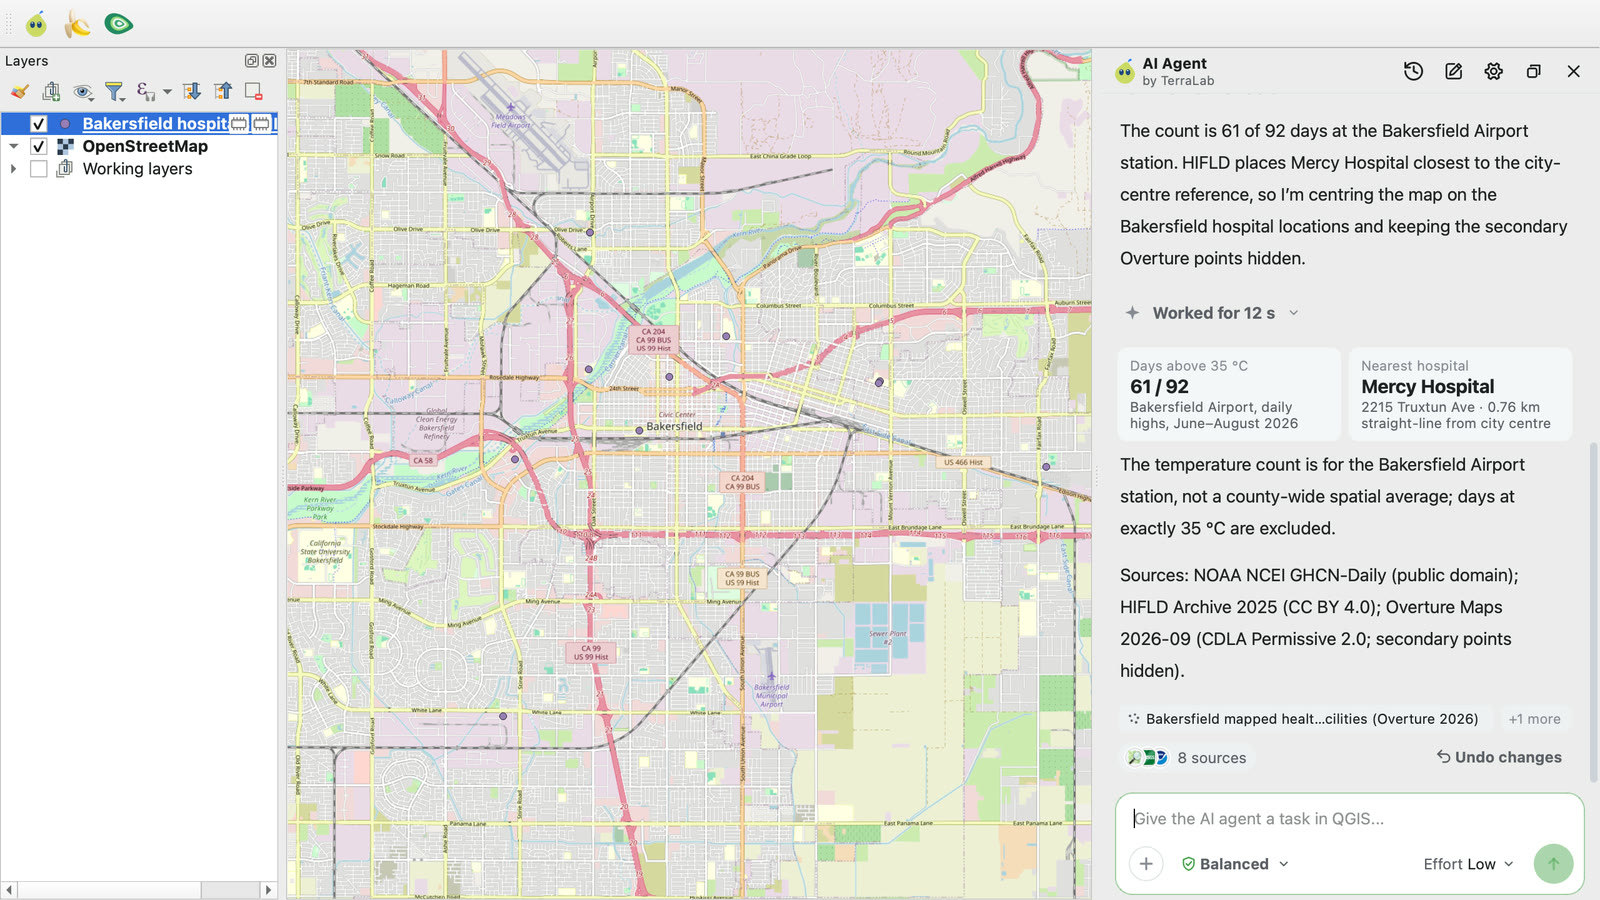
- 質問
- カリフォルニア州カーン郡で、昨夏(2026年6月から8月)に35 °Cを超えた日は何日ありましたか。また、郡庁所在地のベーカーズフィールドに最も近い病院はどこですか。
- 答え
- ベーカーズフィールド空港の観測所では、92日中61日が35 °Cを超えました。これは郡全体の平均ではなく、1つの観測所の値だという注記つきです。最寄りの病院はMercy Hospitalで、市の中心から0.76 kmです。所要時間は約2分です。
- 難しい理由
- 日々の気象記録、病院の登録簿、場所の地図という3つの情報源を結合する必要があり、しかも直近の夏のため、記憶から答えることはできません。
QGISのAIプラグインは、QGIS MCPサーバー付きのClaudeやChatGPTより優れていますか?
今回のベンチマークでは、はい。QGIS MCPサーバーは、ClaudeやChatGPTなどのチャットモデルをModel Context Protocol経由でQGISにつなぎ、モデルがQGISの機能を呼び出せるようにします。これでモデルはQGISを操作できますが、データを探し、各ステップを選び、自分の作業を確認するのはモデル自身です。接続のない言語モデルは、記憶から答えます。
AI Agent QGISプラグインは、地理空間の作業に必要なものをモデルに与えます。GIS向けに作られたツール、使用を許可されたライセンス済みデータ、そして回答する前にすべての結果を確認する仕組みです。QGISの中で直接動くので、モデルは実際のレイヤに対して本物のQGISツールで作業し、結果はすべてプロジェクトで開いて確認できます。
同じモデルを3通りに使った比較が、いちばん分かりやすいでしょう。単体では、GPT-6 LunaはGeoKToolsの答えを一部記憶していますが、GeoExpertQueriesの全タスクで0点です。汎用のMCPサーバーでQGISにつなぐと、得点はほぼ同じです。プラグインのLow effortの中では、同じモデルがGeoKToolsで53.5、GeoExpertQueriesで62.6を記録します。
- GPT-6 Luna単体
- GPT-6 Luna + QGIS MCP
- AI Agent QGISプラグイン
GeoKToolsはGoogleの決定論的採点、GeoExpertQueriesはそのオートレーターで採点しました。QGIS MCPの実行は、Claudeの実行とは別のサーバーとクライアントを使っています(「どのようにテストしましたか?」を参照)。プラグインのLow effortはGPT-6 Lunaで動きます。
プラグインは、どの難易度でもリードしています。GeoKToolsの各問題は、複数の種類のデータを必要とします。2種類の問題では、他のどのシステムも大きく引き離しています。4種類になると、どのシステムも苦戦しますが、プラグインは先頭を保ちます。
- AI Agent QGISプラグイン
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna単体
- AI Agent、最新データ
Googleのレポート方式で採点しました。対象は、私たちのチューニングと無関係なGeoKToolsのホールドアウト30問で、2種類のデータが必要な問題が20問、3種類が5問、4種類が5問です。1種類で足りる問題はすべて、分割の前に調べたテンプレートから出たものなので、このグループは除いています。
- AI Agent QGISプラグイン
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Googleの決定論的採点です。各タイプは3〜5問なので、1問で得点が大きく動きます。プラグインは、どのシステムも答えられない「予測浸水面積」を除くすべてのタイプでClaudeをリードしています。「環状範囲内の場所」では、QGIS MCP付きGPT-6 Lunaが1ポイント上回っています。分割の前に調べた2つのタイプ、「地点周辺の水ストレス」と「領域の極端な地点」は除いています。
- AI Agent QGISプラグイン
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Googleのツール非依存のオートレーターです。公衆衛生は2問しかないので、1問で得点が大きく動きます。この分野ではプラグインとClaudeが同点で、GPT-6 Luna単体はすべての分野で0点でした。
AI Agentは、他のGISベンチマークではどうですか?
Google以外の公開ベンチマーク2つでも、AI Agentを実行しました。どちらに向けても、AI Agentのチューニングはしていません。回答は、各ベンチマークの基準回答に照らして、私たち自身のコードで採点しました。同じ条件で実行した他のエージェントはないので、ここに直接対決はありません。
GeoBenchX:160タスクの62.8%
GeoBenchX(arXiv:2503.18129)は、オープンデータを使った複数ステップのGIS作業を求めます。テーブルの結合、レイヤの処理、国・都市・地域の地図化などです。データでは答えられない依頼も含まれ、その場合の正解は、そう伝えることです。AI Agentは、2回の実行の平均で160タスクの62.8%に合格しました。
- AI Agent QGISプラグイン
採点はコードで行い、ベンチマークの再生した基準解と比べています。AI判定は使っていません。全体のスコアは2回の実行の平均で、65.0%と60.6%です。ほかの2行は1回目の実行の値です。GeoBenchX自身の結果とAxis Spatialの表は、別のタスク集合をAI判定で採点しているため、私たちのスコアを並べて示すことはしません。
GS-QA2:245問で100点満点中61.1
GS-QA2は、カリフォルニア大学リバーサイド校(UC Riverside)のShangらによるベンチマークで、米国の場所についての空間的な質問を出します。最寄りの地物、方角や距離、地面の傾斜・向き・標高などです。基準回答は、固定したOpenStreetMapのスナップショットと標高モデルから作られています。同じデータを与えると、AI Agentは100点満点中61.1点です。現在のライブデータでは22.0点です。スナップショット以降に追加、改名、描き直された場所が、基準回答と合わなくなるためです。AI AgentがLow effortで動かすモデルであるGPT-6 Luna単体は、15.1点です。
- AI Agent QGISプラグイン
- AI Agent、最新データ
- GPT-6 Luna単体
0から100のスコアで、ベンチマークの49の質問テンプレートにわたる平均、3回実行です。論文の許容範囲を使い、コードで採点しました。AI判定は使っていません。Axis SpatialもGS-QA2のスコアを同じデータ設定で公開していますが、質問の抽出が異なり、チェッカーも非公開のため、同じ条件での比較ではありません。
GIS向けエージェントの公開ベンチマークには、GISAgentBenchやGeoNatureAgentもあります。AI Agentはこれらでは実行していないため、このページにスコアは載せていません。
どのようにテストしましたか?
- Google Researchは、GeoKToolsとGeoExpertQueriesを論文(arXiv:2610.15750)とともに、練習用の問題つきで公開しました。公式のテスト問題は非公開のままです。これは公開問題での私たち自身の実行であり、Googleのリーダーボードではありません。
- 公開問題の半分でエージェントを改善し、残りの50問で測定しました。分割は質問テンプレート単位です。分割の前、ベンチマークを調べている段階で、2つのテンプレートを回答つきで調べていました。50問のうち9問がそこから出ているため除外し、ここに示すスコアはすべて残りの41問、つまりチューニングと無関係なホールドアウトの問題で測っています。
- どのシステムにも、同じ質問、同じ指示と制限、空のQGISプロジェクト、3回の試行を与えました。回答はすべてGoogle自身の採点コードで採点しました。
- プラグインは、Low effort(無料プランのGPT-6 Luna)と、High effort(より深く計画する別のモデルで、Pro向け)で実行しました。どちらのベンチマークでもLowのほうが高得点だったので、示しているスコアはすべてLowです。
- Claude Sonnet 5.5は、Claude CodeでnkarasiakのQGIS MCPプラグインバージョン0.15.1を使い、Claude自身のシェル、Web、ファイルのツールをオフにして、10月18日に実行しました。GPT-6 Luna + QGIS MCPは、OpenAIのCodex CLIでjjsantos01のqgis_mcpサーバーを使い、10月16日と17日に実行しました。GPT-6 Luna単体は、ツールなしで答えました。
技術的な詳細
ベンチマーク:google-research/geospatial-reasoning-benchmarksのGeoKToolsとGeoExpertQueries、コミットc21a6d95、データはCC BY 4.0です。公開の開発用スプリット(GeoKTools 85問、GeoExpertQueries 25問)を質問テンプレート単位で2つに分け、ホールドアウト側はGeoKTools 39問、GeoExpertQueries 11問です。分割の前に、GeoKToolsの2つのテンプレート、「領域の極端な地点」と「地点周辺の水ストレス」の基準回答を確認していました。その9問はホールドアウト側に入っており、すべてのスコアから除外しているので、残りはGeoKTools 30問とGeoExpertQueries 11問です。各システムには、Googleのプロンプトプレフィックス、1問あたり最大100回のモデル呼び出しと30分、3回の完全な実行を与えました。失敗またはタイムアウトした実行は0点です。採点は変更していないもので、GeoKToolsの決定論的採点(数値に10%の許容誤差、部分点、テキストにROUGE-L)、GeoKToolsのレポート方式(完全一致、それ以外はGemini 3.8 Flashの判定)、GeoExpertQueriesのツール非依存オートレーター(Gemini 3.8 Flash、回答ごとに判定3回)です。95%区間は、質問に対するペアブートストラップです。実行:プラグインのLowとHigh effortは2026年10月20日、Claude + QGIS MCPは10月18日、GPT-6 Luna単体は10月19日。すべての試行のツール呼び出しについて、ベンチマークのリポジトリ、その質問ファイル、論文を読んでいないかを確認し、該当があれば0点にしました。プラグインは該当なし、GPT-6 Luna + QGIS MCPの実行では2件でした。失敗、拒否、タイムアウトした試行は0点で、平均に含めています(GPT-6 Luna + QGIS MCPは150回中7回、Low effortのプラグインは150回中0回)。
GeoBenchX:Solirinai/GeoBenchX、コミット0edf6109、MITライセンス、202タスク、arXiv:2503.18129に記載されています。公開された監査で除外された23タスク、対照用の質問3問、基準解が再現できない、または基準が計算していない数値を求める16タスクを除き、160タスクにしました。AI Agentは、各タスクを2026年10月20日にLow effortで、別々の2回の実行で、QGISの中で、空のプロジェクトの横のフォルダにタスクのデータを置いて実行しました。結果は65.0%(95%区間56.9〜72.5)と60.6%です。1回目では、答えのある92タスクのうち46を解き、解けない62タスクのうち55を辞退し、どちらも受け付ける6タスクのうち3つに合格しました。採点はコードで行い、AI判定は使わず、再生した基準解と比べました。比べたのは、地図が示す値、地物の数、回答が述べる数値、そして解けないタスクでは地図がないことです。
GS-QA2:Zoe/GS-QA2、リビジョン0ccf9453、Shangら(UC Riverside)、ODbL 1.0、© OpenStreetMap contributors。ASTER GDEMはMETIとNASAの製品です。245問で、49のテンプレートから5問ずつ、Axis Spatialの表と同じルールで抽出しましたが、同じ質問ではありません。3つの設定で、各3回実行しました。1つ目は、ベンチマークのOpenStreetMapテーブルとASTER標高を質問の範囲に切り出し、空のプロジェクトの横のフォルダに置いて、プロンプトではデータの場所だけを伝えたLow effortのAI Agentです(61.1、95%区間57.1〜65.2)。2つ目は、空のプロジェクトからライブデータで実行したLow effortのAI Agentです(22.0、19.0〜25.2)。3つ目は、ツールなし、1回の呼び出しのGPT-6 Luna単体です(15.1、12.2〜18.1)。最終回答は、論文の許容範囲を使い、すべての基準行と照合します。名前はトークンの重なり、位置は5 m以内、方位・向き・傾斜は5°以内、標高は10 m以内、距離・面積・件数は5%以内です。
この結果が示していないことは何ですか?
- 私たち自身の実行で、公開問題での結果です。 Googleはテスト問題を非公開にしています。これらのスコアは公開問題から得たもので、Googleのコードを使って私たちが実行し、採点しました。
- 50問ではなく41問です。 発表記事では52.9を引用しています。これは、プラグインの、50問すべてのホールドアウトでのレポート方式のスコアです。調べたテンプレートからの9問も含まれるため、このページのスコアはすべて、それらを除いたものです。
- サンプルが小さい。 GeoExpertQueriesのホールドアウトは11問、GeoKToolsの質問タイプはそれぞれ3〜5問なので、1問でスコアが大きく動きます。引用するなら、41問すべての比較をお使いください。
- テストしたエージェントだけです。 比較したのは3つの構成です。Claude Sonnet 5.5とGPT-6 Lunaを、それぞれコミュニティ製のQGIS MCPサーバー1つで動かしたものと、GPT-6 Luna単体です。ほかのモデル、ほかのMCPサーバー、論文にあるGoogle自身のエージェントは、この比較に含まれていません。
- GeoBenchXとGS-QA2では、直接対決はしていません。 それらのベンチマークで公表されているスコアは、別のタスク集合と別の採点者によるものなので、AI Agentとの順位づけはしません。
AI Agent QGISプラグインはどうインストールしますか?
AI Agent QGISプラグインは、QGIS公式プラグインリポジトリで無料で入手できます。対応はQGIS 3.28以降で、QGIS 4も含みます。QGISで、Plugins、Manage and Install Pluginsの順に開き、AI Agent by TerraLabを検索してインストールし、ログインします。APIキーもカードも要りません。
無料プランには、Low effortで月5タスクが含まれます。上のすべてのスコアの設定です。MediumとHigh effortはProに含まれます。完全ガイドで最初のタスクを順に説明しています。QGISのAIエージェントとはでは、その考え方を説明しています。
FAQ
QGIS向けの最高のAIエージェントは何ですか?
Googleの地理空間ベンチマークでQGIS内でテストしたすべてのAIエージェントのうち、TerraLabのAI Agent QGISプラグインが最高得点でした。ホールドアウトの41問で100点満点中43.8点、QGIS MCPサーバー付きClaude Sonnet 5.5は24.9点、QGIS MCPサーバー付きGPT-6 Lunaは22.1点です。QGIS公式プラグインリポジトリで入手できる無料のプラグインです。
GIS分析に最適なAIはどれですか?
QGIS内での分析では、GoogleのGeoKToolsとGeoExpertQueriesのベンチマークで、AI Agent QGISプラグインがテストしたエージェントの中で最高得点でした。EsriのArcGIS向けGeoAIツールなど、他のGISソフトウェア向けのツールはテストしていません。
ChatGPTはQGISで使えますか?
ChatGPT単体は記憶から答えるため、QGISを操作できません。OpenAIのCodexでQGIS MCPサーバー経由につなぐと、GPT-6 LunaはGeoKToolsで39.5、GeoExpertQueriesで8.6で、ツールなしの同じモデルとほぼ同じです。AI Agent QGISプラグインの中では、同じモデルが53.5と62.6でした。
ClaudeはQGISと連携できますか?
はい、nkarasiakのQGIS MCPプラグインのようなQGIS MCPサーバー経由で使えます。私たちのテストでは、そのサーバーを使ったClaude Sonnet 5.5はGeoKToolsで33.3、GeoExpertQueriesで29.3でした。AI Agent QGISプラグインは53.5と62.6で、41問中26問でより高い得点でした。
QGIS MCPサーバーとは何ですか?
ClaudeやChatGPTなどのチャットモデルが、Model Context Protocol経由でQGISの機能を呼び出せるようにする橋渡しです。モデルはQGISを操作できますが、データを探すことも、作業を確認することも、自分だけで行う必要があります。QGIS MCPガイドでサーバーを比較しています。
Googleの地理空間推論ベンチマークとは何ですか?
GeoKToolsとGeoExpertQueriesです。Google Researchが2026年10月に、Google Earth AI Geospatial Reasoning Agentに関する論文とともに公開しました(arXiv:2610.15750)。GeoKToolsは1〜4種類の地理空間データを必要とする事実の質問、GeoExpertQueriesは、専門家が書いたワークフローに照らして採点される、アナリスト向けの自由回答の課題です。
GIS向けAIエージェントを比較するベンチマークはありますか?
はい、いくつもあります。GoogleのGeoKToolsとGeoExpertQueries、GeoBenchX、GS-QA2、GISAgentBench、GeoNatureAgentはいずれも、地理空間タスクでエージェントをテストします。質問も採点者もそれぞれ異なるため、ベンチマークをまたいでスコアを比べることはできません。
AI Agentは、他の地理空間ベンチマークではどうですか?
公開されている複数ステップのGISタスクのベンチマークGeoBenchXでは、2回の実行で160タスクの62.8%に合格しました。固定した地図スナップショットに照らして米国の場所についての空間的な質問を確認するGS-QA2では、ベンチマーク自身のデータで100点満点中61.1点でした。同じ条件で実行した他のエージェントはありません。
AI Agent QGISプラグインは無料ですか?
はい。無料プランにはLow effortで月5タスクが含まれます。ここにあるすべてのベンチマークスコアの設定で、APIキーもカードも要りません。MediumとHigh effortはProに含まれます。