Wtyczka AI Agent do QGIS: najpotężniejszy agent AI dla QGIS
Opublikowano
AI Agent od TerraLab to darmowa wtyczka QGIS, która odpowiada na pytania geoprzestrzenne wewnątrz QGIS. W GeoKTools i GeoExpertQueries, dwóch geoprzestrzennych benchmarkach opublikowanych przez Google Research w październiku 2026, AI Agent uzyskał 43,8 na 100 w 41 pytaniach zachowanych do testu, wobec 24,9 dla Claude Sonnet 5.5 z serwerem QGIS MCP, 22,1 dla GPT-6 Luna z serwerem QGIS MCP i 21,0 dla samego GPT-6 Luna. To najwyższy wynik ze wszystkich agentów AI, które testowaliśmy w QGIS, w uruchomieniach od 16 do 20 października 2026, ocenianych kodem oceniającym samego Google.
Zadajesz pytanie zwykłymi słowami, o ryzyko powodzi, czasy dojazdu czy stres wodny. Wtyczka znajduje dane, wykonuje analizę w QGIS i dodaje wynik do twojego projektu jako warstwy, z nazwanymi źródłami.
- Wtyczka AI Agent do QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Trafność od 0 do 100 w GeoKTools i GeoExpertQueries, benchmarkach Google Research dla agentów geoprzestrzennych (arXiv:2610.15750): 41 pytań zachowanych do testu, bez związku z naszym strojeniem, ocenianych kodem oceniającym samego Google, średnia z 3 uruchomień. Wtyczka na poziomie effort Low, czyli ustawieniu w planie darmowym.
Jaki wynik uzyskał AI Agent w geoprzestrzennych benchmarkach Google?
| Wtyczka AI Agent do QGIS | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | Sam GPT-6 Luna | |
|---|---|---|---|---|
GeoKTools 30 pytań Deterministyczny skrypt oceniający offline Google Ocena deterministyczna | 53.5effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 pytań Protokół raportowy Google: dokładne dopasowanie, inaczej sędzia Gemini 3.8 Flash Protokół raportowy Google | 36.9effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 pytań Niezależny od narzędzi autorater, Gemini 3.8 Flash, 3 uruchomienia sędziego Autorater, 3 uruchomienia sędziego | 62.6effort Low | 29.3 | 8.6 | 0.0 |
Wszystkie 41 pytań 41 pytań Oba benchmarki, protokół raportowy Google Protokół raportowy Google | 43.8effort Low | 24.9 | 22.1 | 21.0 |
Wyniki od 0 do 100, średnia z 3 uruchomień na system, każdy skrypt oceniający należy do Google i jest niezmieniony: deterministyczny skrypt oceniający, protokół raportowy i autorater GeoExpertQueries. AI Agent działał na poziomie effort Low 20 października 2026, Claude Sonnet 5.5 z serwerem QGIS MCP 18 października, GPT-6 Luna z serwerem QGIS MCP 16 i 17 października, a sam GPT-6 Luna 19 października. Pogrubienie oznacza najlepszy wynik w każdym wierszu.
Przewaga utrzymuje się pytanie po pytaniu. Spośród 41 pytań AI Agent uzyskał wyższy wynik niż Claude Sonnet 5.5 z serwerem QGIS MCP w 26 i niższy w 5, a wyższy niż GPT-6 Luna z serwerem QGIS MCP w 24 i niższy w 7. Jego średnia przewaga nad Claude wynosi 19 punktów, od 10 do 29 przy 95% ufności.
- Wyższy
- Remis
- Niższy
Dla każdego pytania średnia wtyczki z 3 uruchomień porównana ze średnią Claude. Wszystko na poziomie effort Low.
Czym są GeoKTools i GeoExpertQueries?
To dwa benchmarki, które Google Research opublikowało razem z artykułem o Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 października 2026). Pytania są publiczne w repozytorium google-research/geospatial-reasoning-benchmarks, na licencji CC BY 4.0; oficjalne pytania testowe Google zachowuje w tajemnicy.
- GeoKTools zadaje pytania faktograficzne, których rozwiązanie wymaga od jednego do czterech rodzajów danych geoprzestrzennych: granicy, statystyki, zapisu pogody, liczby miejsc. Deterministyczny skrypt oceniający Google daje punkty częściowe z tolerancją 10% dla liczb; jego protokół raportowy wymaga dokładnego dopasowania albo zatwierdzenia przez sędziego.
- GeoExpertQueries zadaje otwarte problemy, jakie dostałby analityk, z dziedzin takich jak wybór lokalizacji, zagrożenia naturalne i zdrowie publiczne. Autorater Google ocenia każdą odpowiedź względem procedur napisanych przez ekspertów.
Co potrafi agent AI w QGIS?
Odpowiada na pytania o miejsca, pracując na prawdziwych danych wewnątrz QGIS: znajduje zbiory danych, wykonuje analizę przestrzenną, taką jak czasy dojazdu, nakładanie warstw czy statystyki dla obszarów, i zwraca mapę wraz ze źródłami. Poniżej trzy przykłady, każdy nagrany od pustego projektu QGIS na poziomie effort Low, czyli ustawieniu w planie darmowym. Pierwszy pochodzi z artykułu Google. Pozostałe dwa napisaliśmy w tym samym stylu i żaden z nich nie należy do ocenianych pytań.
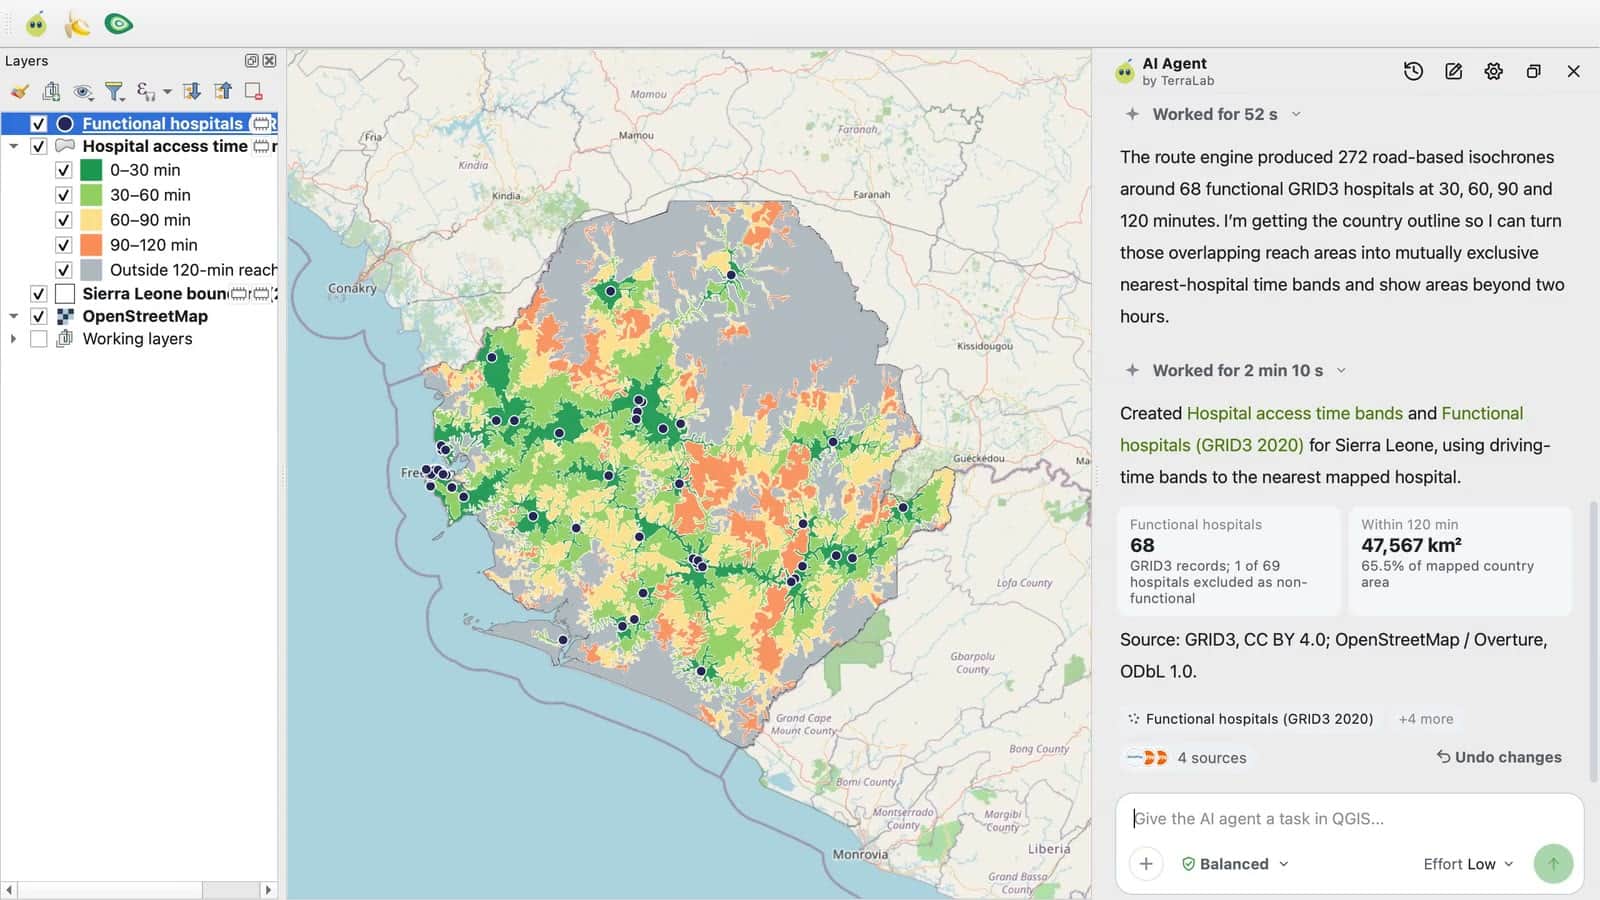
- Pytanie
- Zmapuj czas dojazdu kobiety w ciąży do najbliższego szpitala w razie nagłego porodu, z dowolnego miejsca w Sierra Leone. Użyj czasu dojazdu, a nie odległości w linii prostej.
- Odpowiedź
- Wtyczka najpierw zapytała, jak podróżują ludzie i które placówki mają się liczyć. Przy dojeździe samochodem i przyjęciu wszystkich zmapowanych szpitali jako zastępstwa placówek naniosła na mapę czas dojazdu do najbliższego z 68 szpitali w przedziałach co 30 minut: 65,5% zmapowanego kraju leży w zasięgu dwóch godzin. Około 5 minut.
- Dlaczego to trudne
- Potrzebny jest czas dojazdu drogami w całym kraju, a nie odległość w linii prostej, oraz wybór, które placówki się liczą, którego żaden model nie podejmie z pamięci.
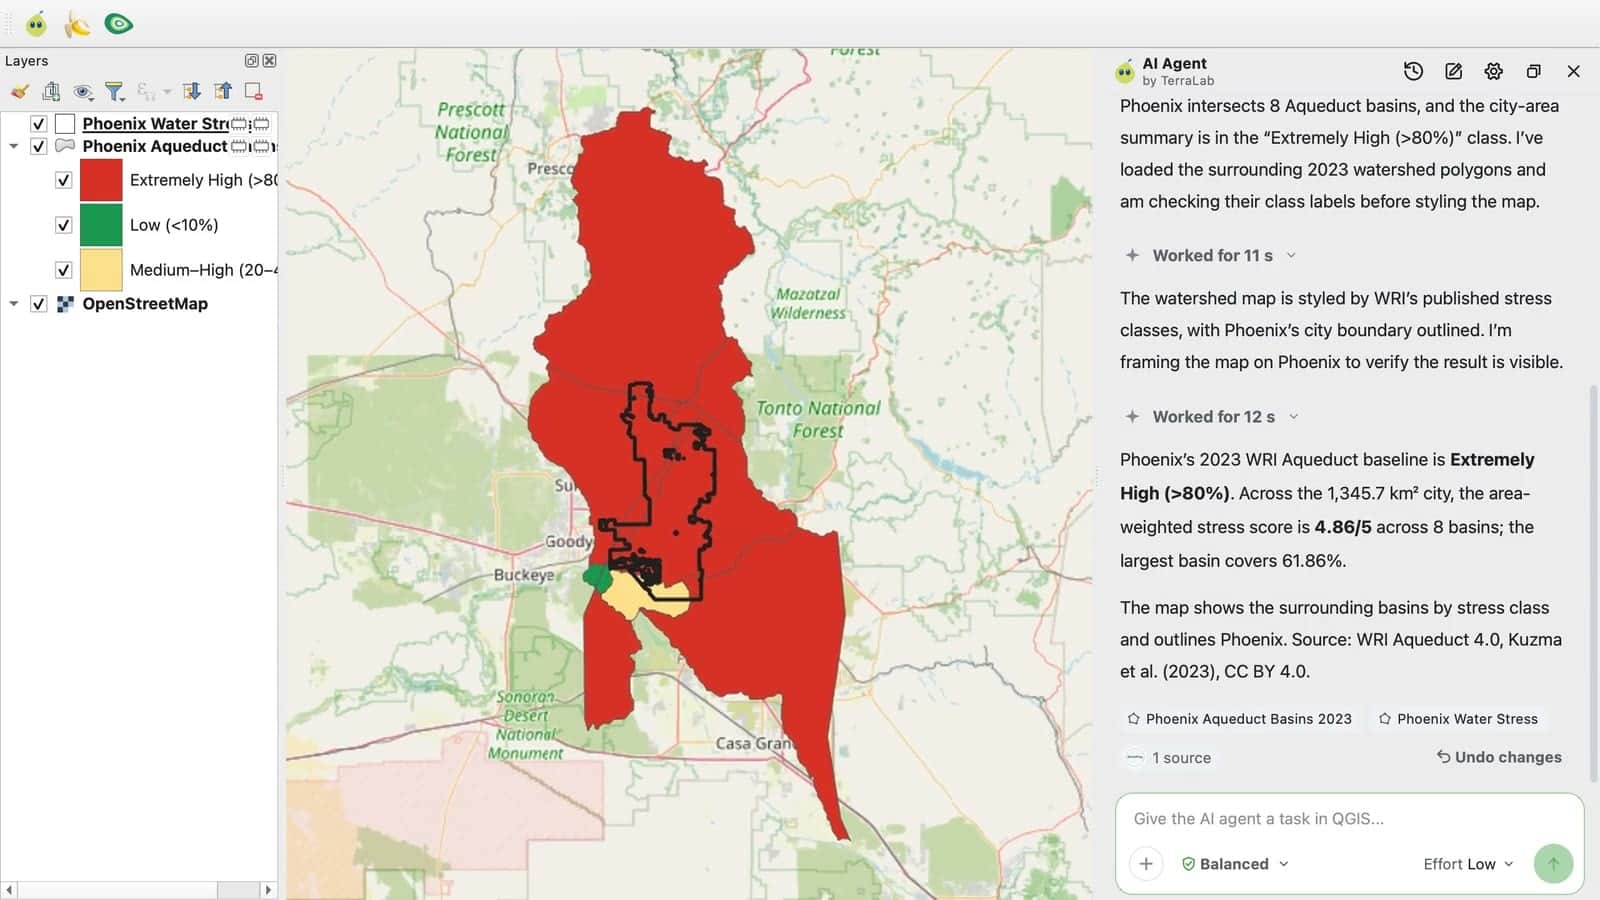
- Pytanie
- Jak bardzo zagrożony niedoborem wody jest obszar wokół Phoenix w Arizonie? Podaj bazowy wskaźnik stresu wodnego WRI Aqueduct dla tego miejsca i pokaż go na mapie.
- Odpowiedź
- Extremely High (ekstremalnie wysoki), powyżej 80%. 8 zlewni WRI Aqueduct przecinających miasto daje wynik ważony powierzchnią 4,86 na 5, z podanym źródłem i jego licencją. Około minuty.
- Dlaczego to trudne
- Odpowiedź musi pochodzić z jednego nazwanego zbioru danych, połączonego dla każdej zlewni, którą miasto zajmuje, a nie z tego, co model pamięta o Phoenix.
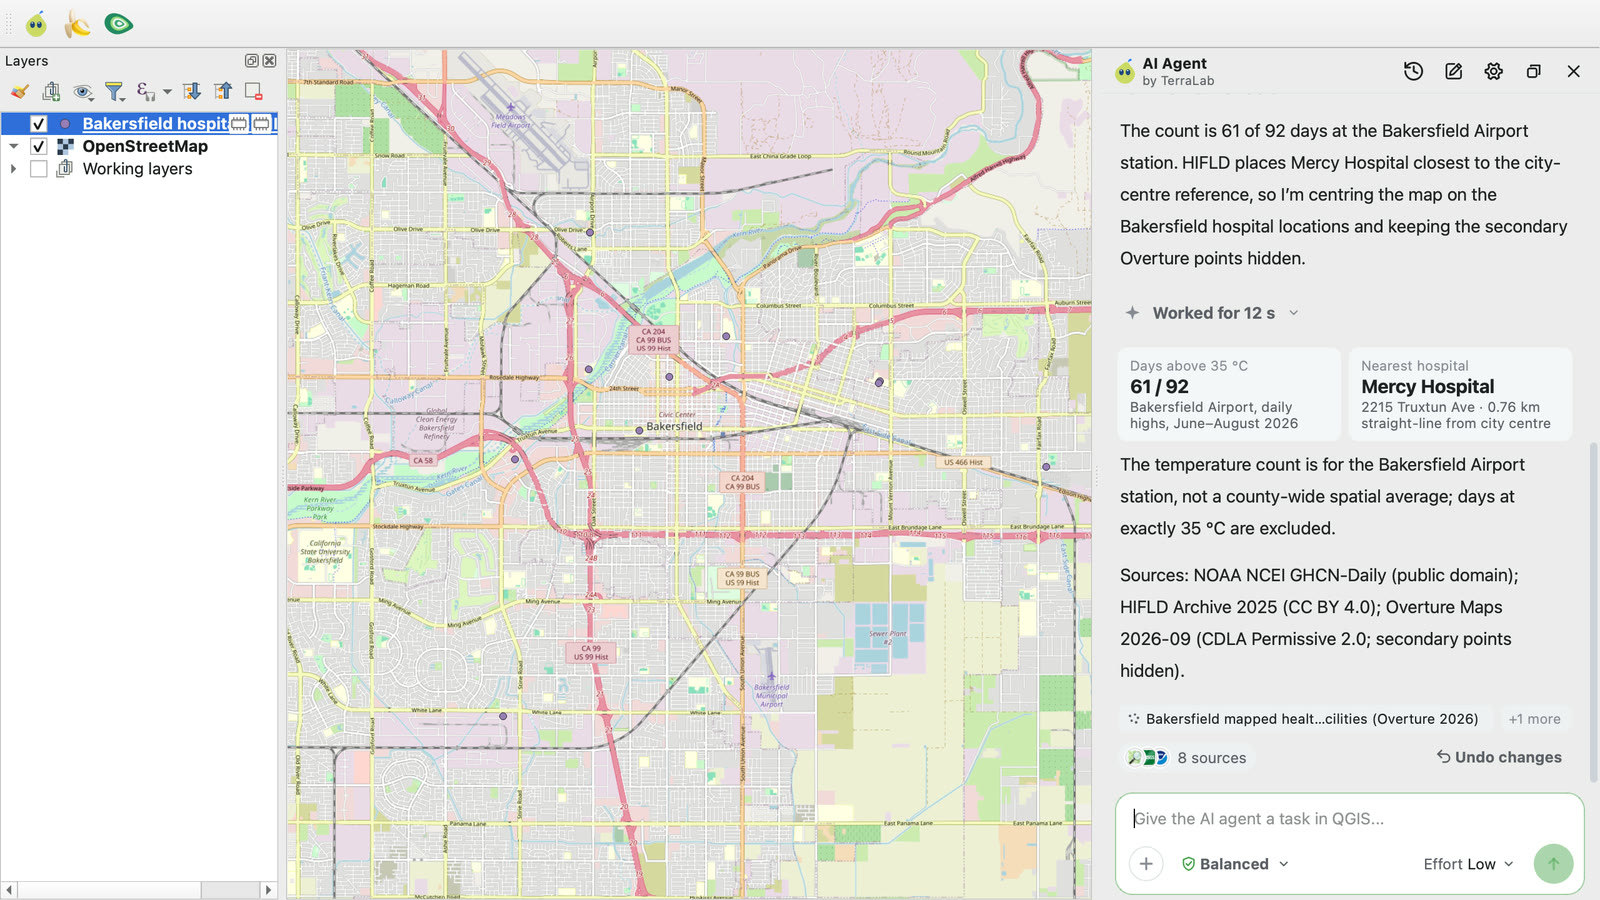
- Pytanie
- Ile dni z temperaturą powyżej 35 °C było w hrabstwie Kern w Kalifornii minionego lata (od czerwca do sierpnia 2026)? I który szpital jest najbliżej Bakersfield, siedziby hrabstwa?
- Odpowiedź
- 61 z 92 dni powyżej 35 °C na stacji przy lotnisku w Bakersfield, z uwagą, że to jedna stacja, a nie średnia dla hrabstwa. Najbliższy szpital to Mercy Hospital, 0,76 km od centrum miasta. Około 2 minut.
- Dlaczego to trudne
- Łączy trzy źródła, dzienne zapisy pogody, rejestr szpitali i mapę miejsc, dla lata zbyt świeżego, by odpowiedzieć z pamięci.
Czy wtyczka AI do QGIS jest lepsza niż Claude lub ChatGPT z serwerem QGIS MCP?
W tych benchmarkach tak. Serwer QGIS MCP łączy model czatu, taki jak Claude czy ChatGPT, z QGIS przez Model Context Protocol, dzięki czemu model może wywoływać funkcje QGIS. Model może wtedy obsługiwać QGIS, ale wciąż sam musi znaleźć dane, wybrać każdy krok i sprawdzić własną pracę. Model językowy bez połączenia odpowiada z pamięci.
Wtyczka AI Agent do QGIS daje modelowi to, czego potrzebuje do pracy geoprzestrzennej: narzędzia stworzone dla GIS, licencjonowane dane, z których wolno mu korzystać, i kontrolę każdego wyniku przed odpowiedzią. Działa bezpośrednio w QGIS, więc model pracuje na prawdziwych warstwach prawdziwymi narzędziami QGIS, a każdy wynik możesz otworzyć w swoim projekcie.
Najlepiej to widać, gdy porównamy jeden model na trzy sposoby. Sam GPT-6 Luna przypomina sobie część odpowiedzi GeoKTools i uzyskuje 0 w każdym zadaniu GeoExpertQueries. Podłączony do QGIS przez ogólny serwer MCP uzyskuje mniej więcej tyle samo. We wtyczce na poziomie effort Low ten sam model uzyskuje 53,5 w GeoKTools i 62,6 w GeoExpertQueries.
- Sam GPT-6 Luna
- GPT-6 Luna + QGIS MCP
- Wtyczka AI Agent do QGIS
GeoKTools z deterministycznym skryptem oceniającym Google, GeoExpertQueries z jego autoraterem. Uruchomienie QGIS MCP użyło innego serwera i klienta niż uruchomienie Claude (zob. Jak testowaliśmy). Wtyczka na poziomie effort Low uruchamia GPT-6 Luna.
Wtyczka prowadzi na każdym poziomie trudności. Każde pytanie GeoKTools wymaga kilku rodzajów danych. Przy dwóch wtyczka uzyskuje wynik wyraźnie lepszy od każdego innego systemu. Przy czterech każdy system sobie nie radzi, a wtyczka nadal jest z przodu.
- Wtyczka AI Agent do QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- Sam GPT-6 Luna
- AI Agent, dane na żywo
Ocena protokołem raportowym Google, na 30 pytaniach GeoKTools zachowanych do testu, bez związku z naszym strojeniem: 20 wymaga dwóch rodzajów danych, 5 trzech, a 5 czterech. Każde pytanie wymagające jednego pochodziło z szablonu, który badaliśmy przed podziałem, więc tę grupę pominięto.
- Wtyczka AI Agent do QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Deterministyczny skrypt oceniający Google. Każdy typ ma od 3 do 5 pytań, więc jedno pytanie mocno zmienia jego wynik. Wtyczka wyprzedza Claude w każdym typie oprócz prognozy zalanych obszarów, na którą nie odpowiada żaden system. GPT-6 Luna z QGIS MCP jest o jeden punkt przed nią w miejscach w pierścieniu. Dwa typy, które badaliśmy przed podziałem, stres wodny wokół punktu i punkt skrajny obszaru, zostały pominięte.
- Wtyczka AI Agent do QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Niezależny od narzędzi autorater Google. Zdrowie publiczne ma tylko 2 pytania, więc jedno pytanie mocno zmienia jego wynik; wtyczka i Claude remisują, a sam GPT-6 Luna uzyskał 0 w każdej dziedzinie.
Jak AI Agent wypada w innych benchmarkach GIS?
Uruchomiliśmy AI Agent także na dwóch publicznych benchmarkach spoza Google, bez żadnego strojenia pod nie. Nasz własny kod oceniał każdą odpowiedź względem odpowiedzi wzorcowych danego benchmarku. Żaden inny agent nie działał w tych samych warunkach, więc nie ma tu porównania bezpośredniego.
GeoBenchX: 62,8% ze 160 zadań
GeoBenchX (arXiv:2503.18129) wymaga wieloetapowej pracy GIS na otwartych danych: łączenia tabel, przetwarzania warstw i mapowania krajów, miast i regionów. Niektóre zadania proszą o coś, czego dane nie mogą dać, a właściwą odpowiedzią jest powiedzieć o tym. AI Agent zaliczył 62,8% ze 160 zadań, średnio w dwóch uruchomieniach.
- Wtyczka AI Agent do QGIS
Ocena kodem względem odtworzonych rozwiązań wzorcowych benchmarku, bez sędziego AI. Wynik ogólny to średnia z dwóch uruchomień, 65,0% i 60,6%; pozostałe dwa wiersze pochodzą z pierwszego uruchomienia. Własne wyniki GeoBenchX i tabela Axis Spatial oceniają sędzią AI na innym zestawie zadań, więc nie zestawiamy z nimi naszego wyniku.
GS-QA2: 61,1 na 100 w 245 pytaniach
GS-QA2, autorstwa Shang i in. z UC Riverside, zadaje pytania przestrzenne o miejsca w Stanach Zjednoczonych: najbliższy obiekt, kierunek lub odległość, nachylenie, wystawę lub wysokość terenu. Każda odpowiedź wzorcowa pochodzi ze stałej migawki OpenStreetMap i modelu wysokości. Przy tych samych danych AI Agent uzyskuje 61,1 na 100. Z dzisiejszych danych na żywo uzyskuje 22,0, bo miejsca dodane, przemianowane lub przerysowane od czasu migawki nie zgadzają się już z odpowiedzią wzorcową. Sam GPT-6 Luna, model, na którym AI Agent działa na poziomie effort Low, uzyskuje 15,1.
- Wtyczka AI Agent do QGIS
- AI Agent, dane na żywo
- Sam GPT-6 Luna
Wynik od 0 do 100, średnia z 49 szablonów pytań benchmarku, 3 uruchomienia. Ocena kodem z tolerancjami z artykułu, bez sędziego AI. Axis Spatial publikuje wyniki GS-QA2 przy tych samych danych, ale na innym losowaniu pytań i z prywatnym skryptem sprawdzającym, więc nie są porównywalne jeden do jednego.
Inne publiczne benchmarki dla agentów GIS to GISAgentBench i GeoNatureAgent. Nie uruchamialiśmy na nich AI Agent, więc ta strona nie podaje dla nich żadnego wyniku.
Jak testowaliśmy?
- Google Research opublikowało GeoKTools i GeoExpertQueries razem z artykułem (arXiv:2610.15750) oraz pytaniami do ćwiczeń; oficjalne pytania testowe zachowuje w tajemnicy. To nasze własne uruchomienie na publicznych pytaniach, a nie ranking Google.
- Ulepszaliśmy agenta na połowie publicznych pytań, a mierzyliśmy go na drugich 50, podzielonych według szablonu pytania. Przed tym podziałem, badając benchmark, przestudiowaliśmy dwa szablony wraz z odpowiedziami. Dziewięć z 50 pytań pochodzi z nich, więc je pominęliśmy: każdy wynik tutaj dotyczy pozostałych 41, pytań zachowanych do testu, bez związku z naszym strojeniem.
- Każdy system dostał te same pytania, te same instrukcje i limity, pusty projekt QGIS i 3 próby. Każdą odpowiedź oceniał kod oceniający samego Google.
- Wtyczkę uruchomiliśmy na poziomie effort Low (GPT-6 Luna, w planie darmowym) i na poziomie effort High (inny model, który planuje głębiej, w Pro). Low uzyskał wyższy wynik w obu benchmarkach, więc każdy pokazany wynik dotyczy Low.
- Claude Sonnet 5.5 działał w Claude Code z wtyczką QGIS MCP autorstwa nkarasiak, w wersji 0.15.1, z wyłączonymi własnymi narzędziami powłoki, sieci i plików, 18 października. GPT-6 Luna + QGIS MCP działał w Codex CLI od OpenAI z serwerem qgis_mcp autorstwa jjsantos01, 16 i 17 października. Sam GPT-6 Luna odpowiadał bez narzędzi.
Szczegóły techniczne
Benchmarki: GeoKTools i GeoExpertQueries z google-research/geospatial-reasoning-benchmarks, commit c21a6d95, dane na licencji CC BY 4.0. Publiczny zbiór deweloperski (85 pytań GeoKTools, 25 GeoExpertQueries) podzieliliśmy na dwie części według szablonu pytania; połowa zachowana do testu ma 39 pytań GeoKTools i 11 GeoExpertQueries. Przed podziałem sprawdziliśmy odpowiedzi wzorcowe dwóch szablonów GeoKTools, punktu skrajnego obszaru i stresu wodnego wokół punktu; ich 9 pytań trafiło do połowy zachowanej do testu i jest pominiętych w każdym wyniku, co zostawia 30 pytań GeoKTools i 11 GeoExpertQueries. Każdy system dostał prefiks promptu Google, najwyżej 100 wywołań modelu i 30 minut na pytanie oraz 3 pełne uruchomienia; nieudane uruchomienie lub takie, które przekroczyło limit czasu, dostaje 0. Skrypty oceniające, niezmienione: deterministyczny skrypt oceniający GeoKTools (tolerancja 10% dla liczb, punkty częściowe, ROUGE-L dla tekstu); protokół raportowy GeoKTools (dokładne dopasowanie, w przeciwnym razie sędzia Gemini 3.8 Flash); niezależny od narzędzi autorater GeoExpertQueries (Gemini 3.8 Flash, 3 uruchomienia sędziego na odpowiedź). Przedział 95% to parowany bootstrap po pytaniach. Uruchomienia: wtyczka na poziomie effort Low i High 20 października 2026; Claude + QGIS MCP 18 października; sam GPT-6 Luna 19 października. Wywołania narzędzi w każdej próbie sprawdzono pod kątem odczytów repozytorium benchmarku, jego pliku z pytaniami lub artykułu, a trafienie daje 0: wtyczka nie miała żadnego, uruchomienia GPT-6 Luna + QGIS MCP miały 2. Próby nieudane, odrzucone lub zakończone przekroczeniem limitu czasu dostają 0 i zostają w średnich (7 ze 150 dla GPT-6 Luna + QGIS MCP, żadna ze 150 prób wtyczki na poziomie Low).
GeoBenchX: Solirinai/GeoBenchX w commicie 0edf6109, licencja MIT, 202 zadania, opisane w arXiv:2503.18129. Pominęliśmy 23 zadania wykluczone przez opublikowany audyt, 3 pytania kontrolne i 16, w których rozwiązanie wzorcowe nie odtwarza się lub prosi o wartość, której wzorzec nie oblicza, co zostawia 160. AI Agent wykonał każde zadanie w dwóch osobnych uruchomieniach na poziomie effort Low 20 października 2026, w QGIS, z danymi zadania w folderze obok pustego projektu: 65,0% (przedział 95% od 56,9 do 72,5) i 60,6%. W pierwszym uruchomieniu rozwiązał 46 z 92 zadań, które mają odpowiedź, odrzucił 55 z 62, których nie da się rozwiązać, i zaliczył 3 z 6, które dopuszczają jedno i drugie. Ocena kodem, bez sędziego AI, względem odtworzonego rozwiązania wzorcowego: wartości, które pokazuje mapa, liczby obiektów, liczba podana w odpowiedzi albo brak mapy w zadaniach niemożliwych do rozwiązania.
GS-QA2: Zoe/GS-QA2 w rewizji 0ccf9453, autorstwa Shang i in. (UC Riverside), ODbL 1.0, © współtwórcy OpenStreetMap; ASTER GDEM jest produktem METI i NASA. 245 pytań, po 5 z każdego z 49 szablonów, wylosowanych tą samą regułą co w tabeli Axis Spatial, ale nie te same pytania. Trzy ustawienia, po 3 uruchomienia: AI Agent na poziomie effort Low z tabelami OpenStreetMap i wysokościami ASTER z benchmarku, przyciętymi do obszarów pytań, w folderze obok pustego projektu, z promptem mówiącym tylko, gdzie są dane (61,1, przedział 95% od 57,1 do 65,2); AI Agent na poziomie effort Low z pustego projektu na danych na żywo (22,0, od 19,0 do 25,2); sam GPT-6 Luna, jedno wywołanie bez narzędzi (15,1, od 12,2 do 18,1). Ostateczną odpowiedź sprawdza się względem każdego wiersza wzorca z tolerancjami z artykułu: nazwy według nakładania się tokenów, lokalizacje w granicach 5 m, azymut, wystawa i nachylenie w granicach 5°, wysokość w granicach 10 m, odległości, powierzchnie i liczby w granicach 5%.
Czego te wyniki nie pokazują?
- Nasze uruchomienie, na publicznych pytaniach. Google zachowuje pytania testowe w tajemnicy. Te wyniki pochodzą z pytań publicznych, uruchomionych i ocenionych przez nas kodem Google.
- 41 pytań, nie 50. Nasze wpisy z ogłoszeniem podają 52,9, czyli wynik wtyczki w protokole raportowym na wszystkich 50 pytaniach zachowanych do testu. Obejmuje on 9 pytań z szablonów, które wcześniej badaliśmy, dlatego każdy wynik na tej stronie je pomija.
- Małe próby. GeoExpertQueries ma 11 pytań zachowanych do testu, a każdy typ pytań GeoKTools ma od 3 do 5, więc jedno pytanie mocno zmienia te wyniki. Do cytowania nadaje się porównanie na wszystkich 41 pytaniach.
- Tylko agenci, których testowaliśmy. Porównaliśmy trzy konfiguracje: Claude Sonnet 5.5 i GPT-6 Luna, każdy przez jeden społecznościowy serwer QGIS MCP, oraz sam GPT-6 Luna. Inne modele, inne serwery MCP i własny agent Google z artykułu nie są w tym porównaniu.
- Brak porównania bezpośredniego w GeoBenchX i GS-QA2. Opublikowane wyniki w tych benchmarkach dotyczą innych zestawów zadań i innych skryptów oceniających, więc nie zestawiamy z nimi AI Agent.
Jak zainstalować wtyczkę AI Agent do QGIS?
Wtyczka AI Agent do QGIS jest darmowa w oficjalnym repozytorium wtyczek QGIS, dla QGIS 3.28 i nowszych, w tym QGIS 4. W QGIS otwórz Plugins, potem Manage and Install Plugins, wyszukaj AI Agent by TerraLab, zainstaluj i zaloguj się. Nie potrzebujesz klucza API ani karty.
Plan darmowy obejmuje 5 zadań miesięcznie na poziomie effort Low, czyli ustawieniu stojącym za każdym wynikiem powyżej. Poziomy effort Medium i High są w Pro. Pełny poradnik prowadzi przez pierwsze zadanie, a czym jest agent AI w QGIS wyjaśnia ideę.
Najczęstsze pytania
Jaki jest najlepszy agent AI dla QGIS?
Spośród wszystkich agentów AI, które testowaliśmy w QGIS w geoprzestrzennych benchmarkach Google, wtyczka AI Agent do QGIS od TerraLab uzyskała najwyższy wynik: 43,8 na 100 w 41 pytaniach zachowanych do testu, wobec 24,9 dla Claude Sonnet 5.5 z serwerem QGIS MCP i 22,1 dla GPT-6 Luna z serwerem QGIS MCP. To darmowa wtyczka w oficjalnym repozytorium wtyczek QGIS.
Jaka AI jest najlepsza do analiz GIS?
Do analiz wewnątrz QGIS wtyczka AI Agent do QGIS miała najwyższy wynik spośród agentów, które testowaliśmy w benchmarkach Google GeoKTools i GeoExpertQueries. Nie testowaliśmy narzędzi do innego oprogramowania GIS, takich jak narzędzia GeoAI od Esri dla ArcGIS.
Czy ChatGPT może pracować w QGIS?
ChatGPT sam odpowiada z pamięci i nie potrafi obsługiwać QGIS. Podłączony przez serwer QGIS MCP w Codex od OpenAI, GPT-6 Luna uzyskał 39,5 w GeoKTools i 8,6 w GeoExpertQueries, mniej więcej tyle, ile ten sam model bez narzędzi. We wtyczce AI Agent do QGIS ten sam model uzyskał 53,5 i 62,6.
Czy Claude może pracować z QGIS?
Tak, przez serwer QGIS MCP, taki jak wtyczka QGIS MCP autorstwa nkarasiak. W naszym teście Claude Sonnet 5.5 z tym serwerem uzyskał 33,3 w GeoKTools i 29,3 w GeoExpertQueries; wtyczka AI Agent do QGIS uzyskała 53,5 i 62,6 oraz wyższy wynik w 26 z 41 pytań.
Czym jest serwer QGIS MCP?
To most, który pozwala modelowi czatu, takiemu jak Claude czy ChatGPT, wywoływać funkcje QGIS przez Model Context Protocol. Model może wtedy obsługiwać QGIS, ale dane musi znaleźć i swoją pracę sprawdzić sam. Nasz poradnik o QGIS MCP porównuje serwery.
Czym są geoprzestrzenne benchmarki Google do rozumowania?
GeoKTools i GeoExpertQueries, opublikowane przez Google Research w październiku 2026 razem z artykułem o Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). GeoKTools zadaje pytania faktograficzne wymagające od jednego do czterech rodzajów danych geoprzestrzennych; GeoExpertQueries zadaje otwarte problemy analityków, oceniane względem procedur napisanych przez ekspertów.
Czy istnieje benchmark porównujący agentów AI dla GIS?
Tak, kilka. GeoKTools i GeoExpertQueries od Google, GeoBenchX, GS-QA2, GISAgentBench i GeoNatureAgent testują agentów na zadaniach geoprzestrzennych, każdy z własnymi pytaniami i własnym skryptem oceniającym, więc ich wyniki nie są porównywalne między benchmarkami.
Jak AI Agent wypada w innych geoprzestrzennych benchmarkach?
W GeoBenchX, publicznym benchmarku wieloetapowych zadań GIS, zaliczył 62,8% ze 160 zadań w dwóch uruchomieniach. W GS-QA2, pytaniach przestrzennych o miejsca w USA sprawdzanych względem stałej migawki mapy, uzyskał 61,1 na 100 z danymi samego benchmarku. Żaden inny agent nie działał w tych samych warunkach.
Czy wtyczka AI Agent do QGIS jest darmowa?
Tak. Plan darmowy obejmuje 5 zadań miesięcznie na poziomie effort Low, czyli ustawieniu stojącym za każdym wynikiem benchmarku tutaj, bez klucza API i bez karty. Poziomy effort Medium i High są w Pro.