Automatyzacja QGIS: jedno zadanie, 4 metody, pomiar czasu w 2 miastach
Opublikowano
Powtarzalny proces w QGIS możesz zautomatyzować na cztery sposoby: Batch Processing dla jednego narzędzia na wielu plikach, Graphical Modeler dla łańcucha narzędzi, który będziesz uruchamiać ponownie, skrypt PyQGIS dla pętli i pełnej kontroli albo agent AI w QGIS, gdy chcesz dostać wynik z jednej wiadomości napisanej zwykłym językiem.
 możesz zautomatyzować na cztery sposoby: Batch Processing dla jednego narzędzia na wielu plikach, Graphical Modeler dla łańcucha narzędzi, który będziesz uruchamiać ponownie, skrypt
Poradniki, które przeczytałem, uczą jednej z tych czterech metod osobno, na zabawkowym przykładzie, i żaden nie sprawdza, co się dzieje, gdy uruchamiasz proces drugi raz dla nowego miasta. 7 listopada 2026 wziąłem jedno wieloetapowe zadanie (powierzchnia zabudowy w każdej dzielnicy z 180,602 budynków OpenStreetMap w Bielefeld w Niemczech), przepuściłem je przez wszystkie cztery metody w QGIS 3.44.15, a potem powtórzyłem wszystkie cztery dla Münster (135,577 budynków, 6 dzielnic). Każda metoda zaliczyła oba miasta, choć jedno uruchomienie w Graphical Modeler najpierw skończyło się komunikatem "OK", zapisując 1,058 poligonów zamiast 10.
8.1s
Skrypt PyQGIS w Bielefeld (7.4 s w Münster)
62.7s
Graphical Modeler w QGIS (44.5 s bez interfejsu)
60s
Powtórka AI Agent dla Münster z 1 zdania
1,058wierszy
Zapisanych zamiast 10 przy cichym błędzie modelu
Czym jest automatyzacja QGIS?
Automatyzacja QGIS to uruchamianie narzędzia przetwarzania lub łańcucha narzędzi na warstwach bez ręcznego klikania w każdym oknie dialogowym. Pod każdą metodą działa framework Processing w QGIS, ten sam silnik, który napędza Przybornik Processing. Narzędzia są te same bez względu na to, czy wywołujesz je z tabeli wsadowej, z diagramu w Graphical Modeler, ze skryptu Python czy z narzędzia wiersza poleceń qgis_process, więc wybór metody automatyzacji to tak naprawdę wybór sposobu łączenia tych narzędzi i pliku, który zostanie na dysku na następny miesiąc.
Zadanie i dane, na których testowaliśmy
Wybrałem zadanie, które ciągle wraca w planowaniu przestrzennym i doradztwie: dla każdej dzielnicy przytnij budynki do granicy dzielnicy, policz obrysy, zsumuj ich powierzchnię w metrach kwadratowych, zrób bufor 25 m wokół przyciętych budynków, połącz go w jeden poligon zabudowy i zapisz jeden czysty GeoPackage z jednym wierszem na dzielnicę.
Budynek przecinający granicę dzielnicy jest przycinany i liczony raz w każdej dzielnicy, której dotyka. Oba miasta korzystają z danych OpenStreetMap z wycinków PBF BBBike (ODbL, współtwórcy OpenStreetMap), przeprojektowanych do EPSG:25832 (ETRS89 / UTM zone 32N) na potrzeby wszystkich pomiarów.
- Miasto 1, Bielefeld: 180,602 poligonów budynków w 10 dzielnicach (
admin_level=9), co daje 115,002 przycięte fragmenty budynków. Dwa surowe budynki OSM miały nieprawidłowe geometrie i zostały raz naprawione narzędziem Fix geometries, tak aby wszystkie cztery metody startowały z tych samych czystych plików. - Miasto 2, Münster (powtórka): 135,577 poligonów budynków w 6 dzielnicach, co daje 116,382 przycięte fragmenty.
Przed uruchomieniem którejkolwiek z czterech metod napisałem niezależny wzorzec na zwykłych wywołaniach geometrii PyQGIS (QgsSpatialIndex, geometry.intersection(), unaryUnion() i buffer(25, 5), bez algorytmów Processing) i zapisałem skrypt sprawdzający. Metoda zaliczała test tylko wtedy, gdy dała jeden GeoPackage z warstwą poligonową built_up w EPSG:25832, dokładną liczbę budynków w każdej dzielnicy, powierzchnię obrysów w granicy 0.5% od wzorca, hektary zabudowy w granicy 1% i żadnej ręcznej edycji po fakcie.
Metoda 1: Batch Processing
Każde narzędzie w Przyborniku Processing ma w lewym dolnym rogu okna przycisk Run as Batch Process (po polsku "Uruchom jako proces wsadowy"). Zmienia on okno w arkusz, w którym każdy wiersz to jedno uruchomienie tego jednego narzędzia.
W naszym zadaniu przetwarzanie wsadowe dobrze radzi sobie z Clip i Buffer dla każdej dzielnicy, bo te dwa kroki powtarzają dokładnie ten sam algorytm na 10 dzielnicach. Nie zrobi jednak całego procesu za jednym razem, bo Batch Processing uruchamia tylko jedno narzędzie naraz i zostawia 10 osobnych warstw wynikowych, które nadal trzeba scalić i połączyć z powrotem.
Przeprojektuj i podziel dane wejściowe
Uruchom Reproject layer (Vector general) na budynkach, z celem EPSG:25832. Potem uruchom Split vector layer (Vector general) na warstwie dzielnic z polem name, co zapisze jeden GeoPackage na dzielnicę do folderu.
Uruchom Clip wsadowo dla wszystkich dzielnic
Otwórz Clip (Vector overlay), kliknij Run as Batch Process i dodaj jeden wiersz na plik dzielnicy. Ustaw przeprojektowane budynki jako Input layer, użyj Autofill, aby wypełnić warstwy nakładki dzielnic i nazwy tabel wynikowych (clip_<district>), i odznacz Load layers on completion. W Bielefeld wszystkie 10 wierszy skończyło się w 13.7 s (od 1.0 do 4.2 s na dzielnicę).
Uruchom Buffer wsadowo z włączonym Dissolve
Otwórz Buffer (Vector geometry) w trybie wsadowym: jeden wiersz na przyciętą warstwę, Distance 25, Segments 5 i zaznaczone Dissolve result. 10 buforów dla Bielefeld zajęło 27.7 s.
Scal, zagreguj i połącz tabelę z powrotem
Uruchom Merge vector layers dwa razy (raz na 10 warstwach przycięcia, raz na 10 warstwach buforów). Uruchom Aggregate (Vector geometry) na scalonych przycięciach, grupując po polu layer, aby dostać building_count (count($id)) i building_area_m2 (sum(area($geometry))). Uruchom Refactor fields (Vector table) na scalonych buforach, aby policzyć built_up_ha wyrażeniem kalkulatora pól $area / 10000, a potem Join attributes by field value (Vector general) po district, aby dostać jedną warstwę wynikową.
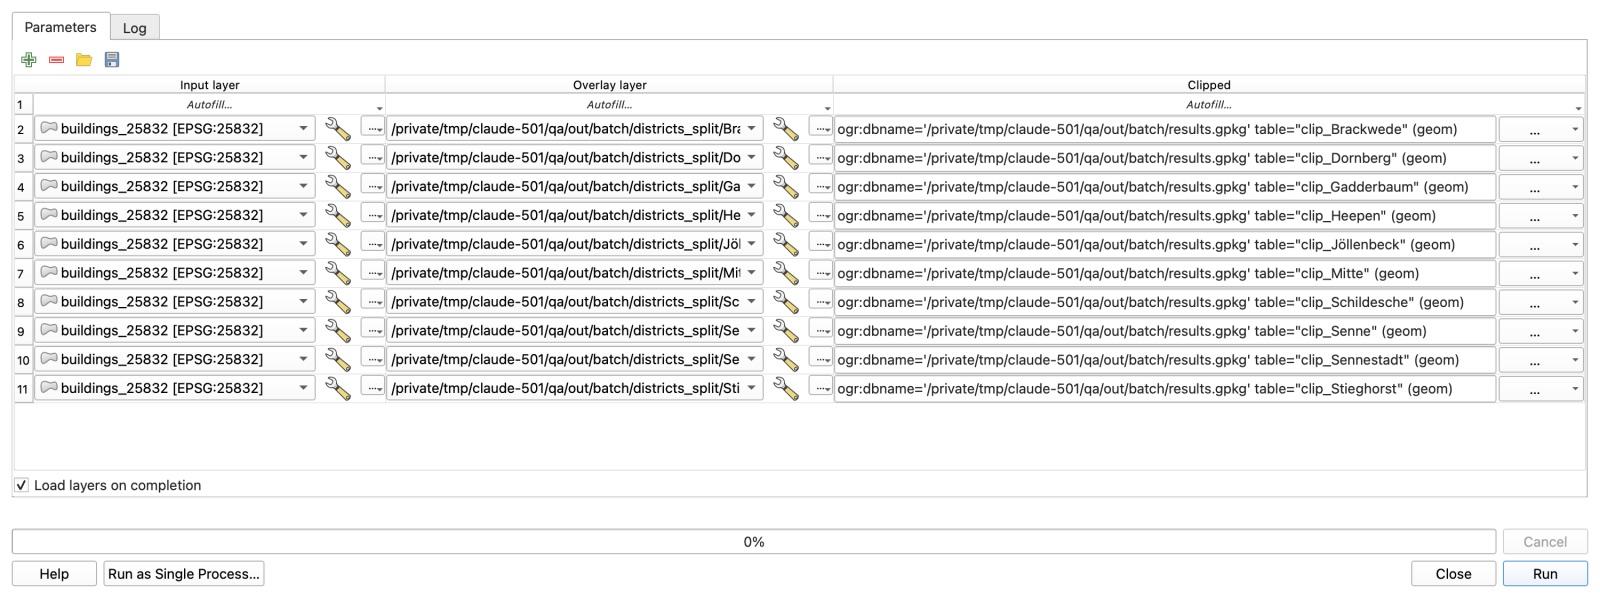
W 9 uruchomieniach (8 różnych algorytmów) łączny czas pracy narzędzi w Bielefeld wyniósł 62.0 sekundy, a liczba budynków w każdej dzielnicy zgadzała się ze wzorcem. W Münster czas narzędzi spadł do 39.8 sekundy dla 6 dzielnic, ale musiałem odbudować 6-wierszowe tabele wsadowe i ręcznie powtórzyć wszystkie 9 kroków. Gdy twój proces to łańcuch różnych narzędzi, a nie jedno narzędzie powtarzane na 50 plikach, Batch Processing ma zły kształt.
Metoda 2: Graphical Modeler
Graphical Modeler (Processing > Graphical Modeler, po polsku modelarz graficzny) pozwala połączyć łańcuch narzędzi Processing w jeden diagram i zapisać go jako plik .model3. Gotowy model pojawia się w Przyborniku Processing jak każde natywne narzędzie.
Można by się spodziewać, że w modelarzu potrzebna będzie pętla po dzielnicach, ale nie jest. Gdy najpierw uruchomisz Intersection między budynkami a dzielnicami, każdy fragment budynku dziedziczy atrybut name swojej dzielnicy, więc Aggregate i Dissolve grupujące po name dają jeden wiersz na dzielnicę w jednym przebiegu. (Możesz też użyć złączenia przestrzennego, jeśli nie potrzebujesz budynków ściśle podzielonych na granicy dzielnicy.)
Dodaj trzy wejścia modelu
W nowym modelu dodaj dwa wejścia Vector Layer (Polygons) o nazwach Buildings i Districts oraz jedno wejście Number o nazwie Buffer distance (m) z wartością domyślną 25.
Przeprojektuj oba wejścia i wyznacz ich przecięcie
Dodaj dwa węzły Reproject layer z celem EPSG:25832. Połącz oba z węzłem Intersection (Buildings jako Input, Districts jako Overlay). W Input fields to keep w Intersection ogranicz pola budynków do samego osm_id, a w Overlay fields to keep zostaw name.
Rozgałęź na Aggregate dla liczb oraz Dissolve + Buffer dla geometrii
Z Intersection poprowadź jedną gałąź do Aggregate grupującego po name, aby policzyć count($id) i sum(area($geometry)). Drugą gałąź z Intersection poprowadź do Dissolve (pole name), a za nim do Buffer (połączonego z wejściem Buffer distance (m), 5 segmentów).
Połącz gałęzie i sformatuj tabelę wynikową
Dodaj Join attributes by field value, aby dołączyć tabelę z Aggregate do zbuforowanych poligonów po name, a potem Refactor fields, aby zmienić nazwę name na district i policzyć built_up_ha jako $area / 10000. Oznacz wynik jako built_up i zapisz model jako built_up_by_district.model3.
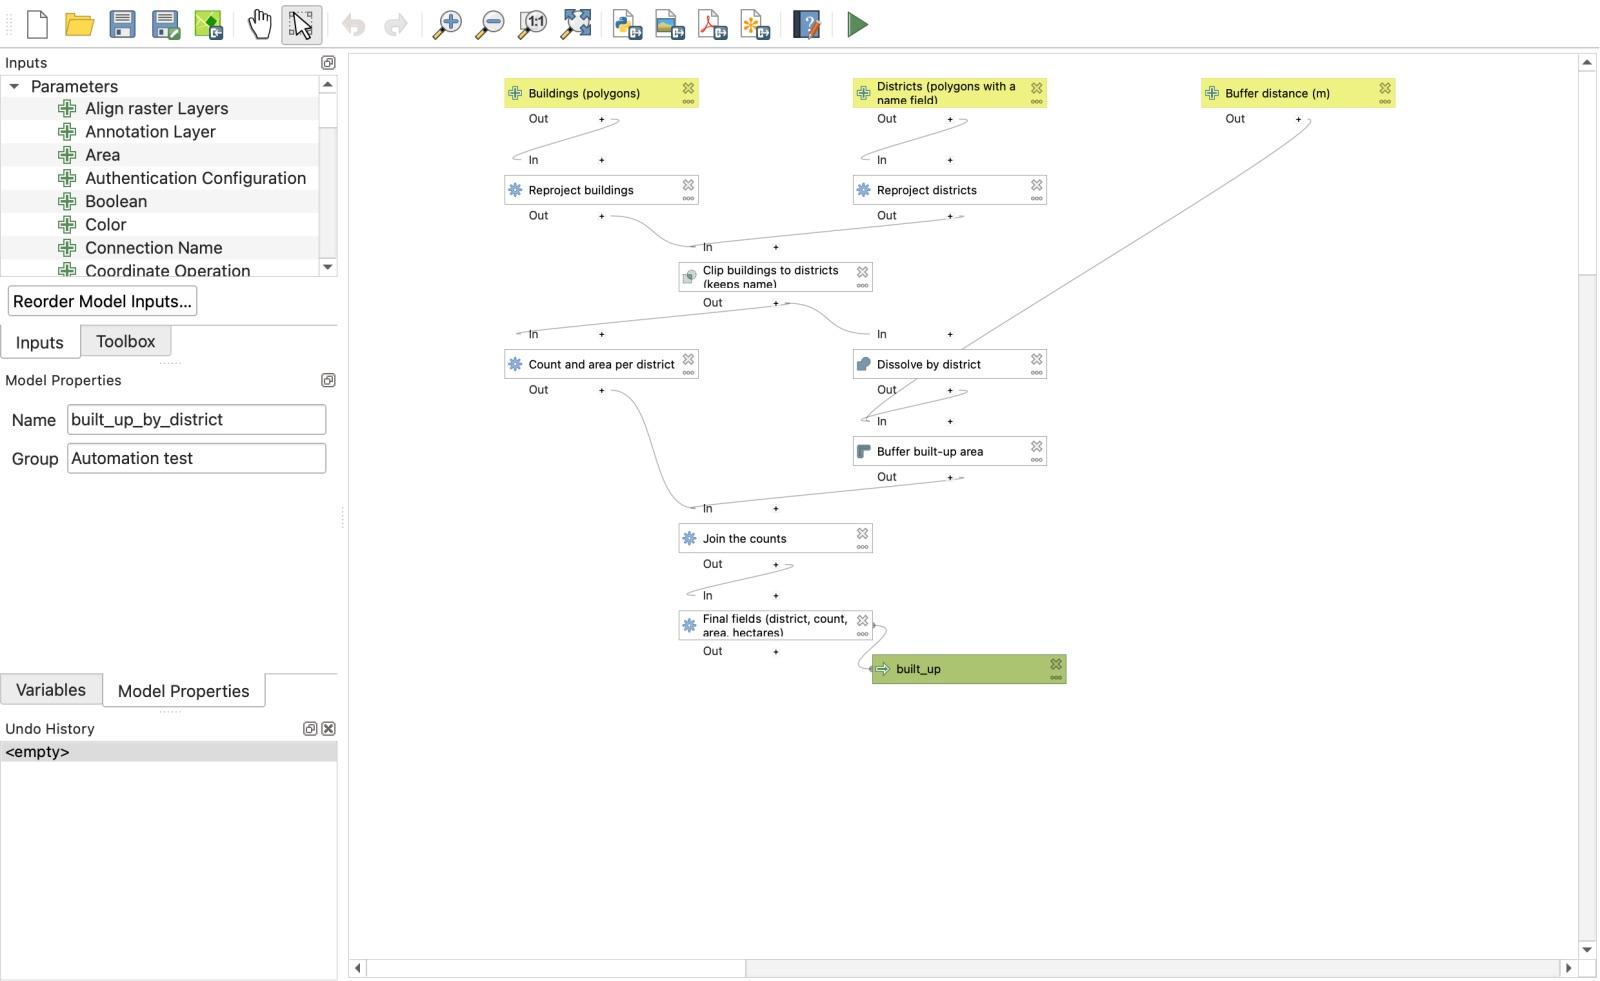
Uruchomienie modelu z jego okna dla Bielefeld zajęło 62.7 sekundy i zaliczyło każdy test. Co więcej, dokładnie ten sam plik .model3 uruchomił się z terminala macOS, bez otwierania okna QGIS, przez qgis_process w 44.5 sekundy.
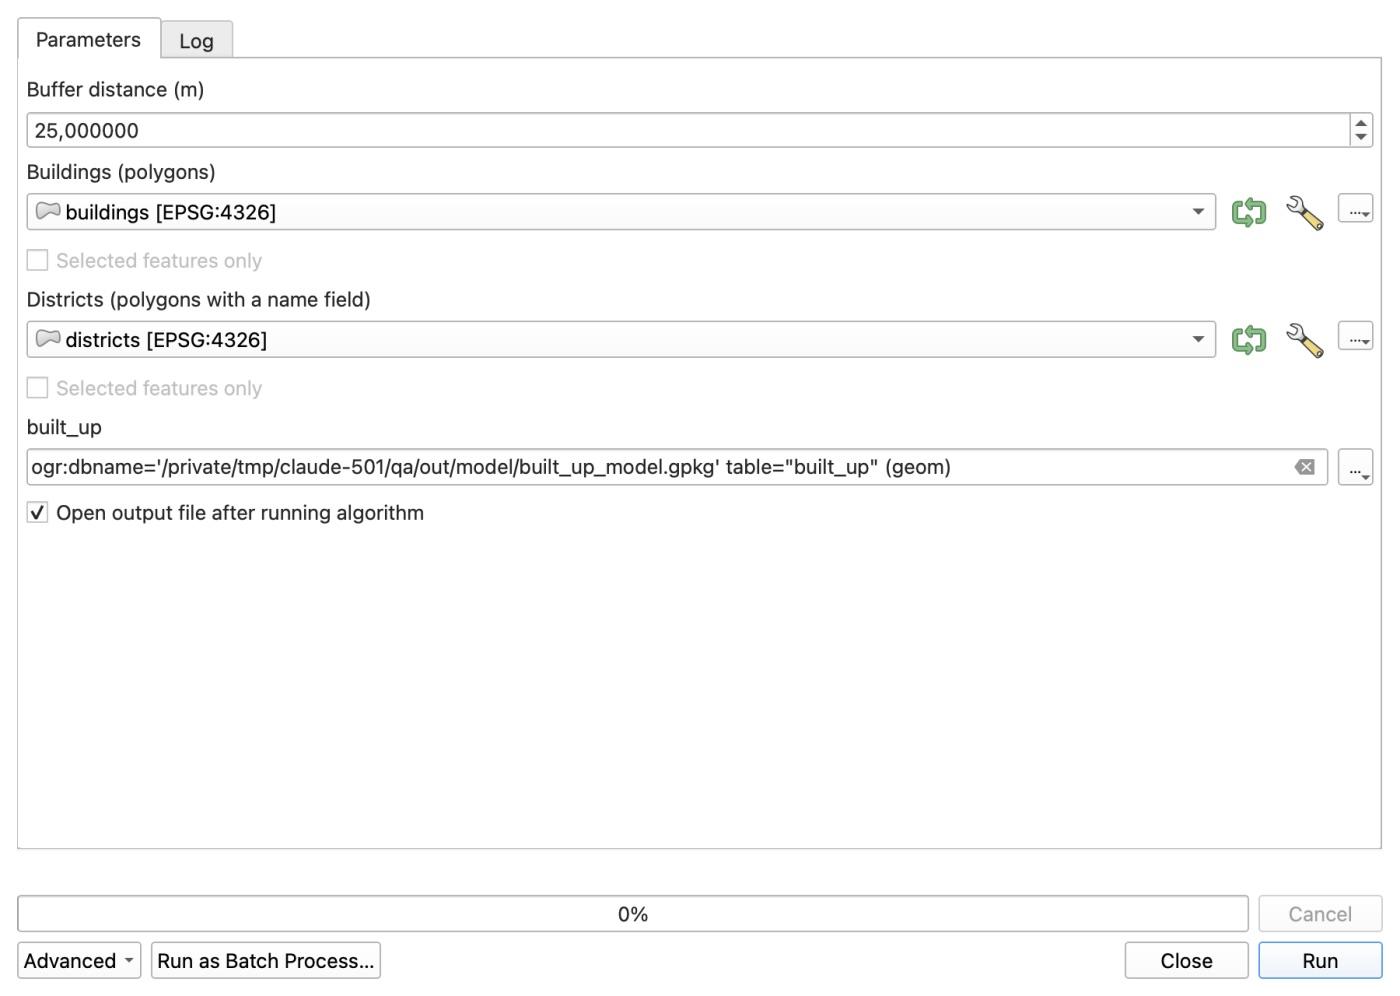
Prawdziwa korzyść wyszła przy powtórce dla Münster. Otworzyłem to samo okno modelu, wybrałem muenster_buildings i muenster_districts z dwóch list rozwijanych i kliknąłem Run. Skończył w 67.2 sekundy bez żadnej zmiany w modelu.
Metoda 3: skrypt PyQGIS w konsoli Python
Jeśli dobrze czujesz się w Pythonie, skrypt w Plugins > Python Console > Show Editor daje prawdziwą pętlę for, dane wejściowe jako zmienne na początku pliku i żadnych kroków scalania.
Oto 38-wierszowy skrypt (built_up_by_district.py), który uruchomiłem w QGIS 3.44.15, ze skróconymi ścieżkami plików:
# Built-up area by district. Run in the QGIS Python console (Plugins > Python Console > Show Editor > Run).
# Change the first five lines for a new city.
BUILDINGS = "data/bielefeld_buildings.gpkg"
DISTRICTS = "data/bielefeld_districts.gpkg"
NAME_FIELD = "name"
BUFFER_M = 25
OUT = "out/script/built_up_script.gpkg"

import processing
from qgis.core import (QgsVectorLayer, QgsCoordinateReferenceSystem, QgsFeature, QgsField, QgsFields, QgsGeometry)
from qgis.PyQt.QtCore import QVariant

crs = QgsCoordinateReferenceSystem("EPSG:25832")   # metric, Germany
def run(alg, **p):
    return processing.run(alg, p)["OUTPUT"]

buildings = run("native:reprojectlayer", INPUT=BUILDINGS, TARGET_CRS=crs, OUTPUT="memory:")
districts = run("native:reprojectlayer", INPUT=DISTRICTS, TARGET_CRS=crs, OUTPUT="memory:")

result = QgsVectorLayer("MultiPolygon?crs=EPSG:25832", "built_up", "memory")
result.dataProvider().addAttributes([QgsField("district", QVariant.String), QgsField("building_count", QVariant.Int),
                                     QgsField("building_area_m2", QVariant.Double), QgsField("built_up_ha", QVariant.Double)])
result.updateFields()

for d in districts.getFeatures():
    one = run("native:extractbyexpression", INPUT=districts, EXPRESSION=f"$id = {d.id()}", OUTPUT="memory:")
    clipped = run("native:clip", INPUT=buildings, OVERLAY=one, OUTPUT="memory:")
    area = sum(f.geometry().area() for f in clipped.getFeatures())
    built_up = run("native:buffer", INPUT=clipped, DISTANCE=BUFFER_M, SEGMENTS=5, DISSOLVE=True, OUTPUT="memory:")
    geom = next(built_up.getFeatures()).geometry()
    f = QgsFeature(result.fields())
    f.setGeometry(geom)
    f.setAttributes([d[NAME_FIELD], clipped.featureCount(), area, geom.area() / 10000])
    result.dataProvider().addFeature(f)
    print(d[NAME_FIELD], clipped.featureCount(), round(area), round(geom.area() / 10000, 1))

processing.run("native:savefeatures", {"INPUT": result, "OUTPUT": OUT, "LAYER_NAME": "built_up"})
print("saved", OUT)
Skrypt trzyma każdą warstwę pośrednią w pamięci i przechodzi pętlą po dzielnicach, a przy tym był zdecydowanie najszybszą metodą (nie profilowaliśmy, dlaczego). Bielefeld skończył w 8.1 sekundy i zgadzał się z niezależnym wzorcem do 0.00% w każdej dzielnicy.
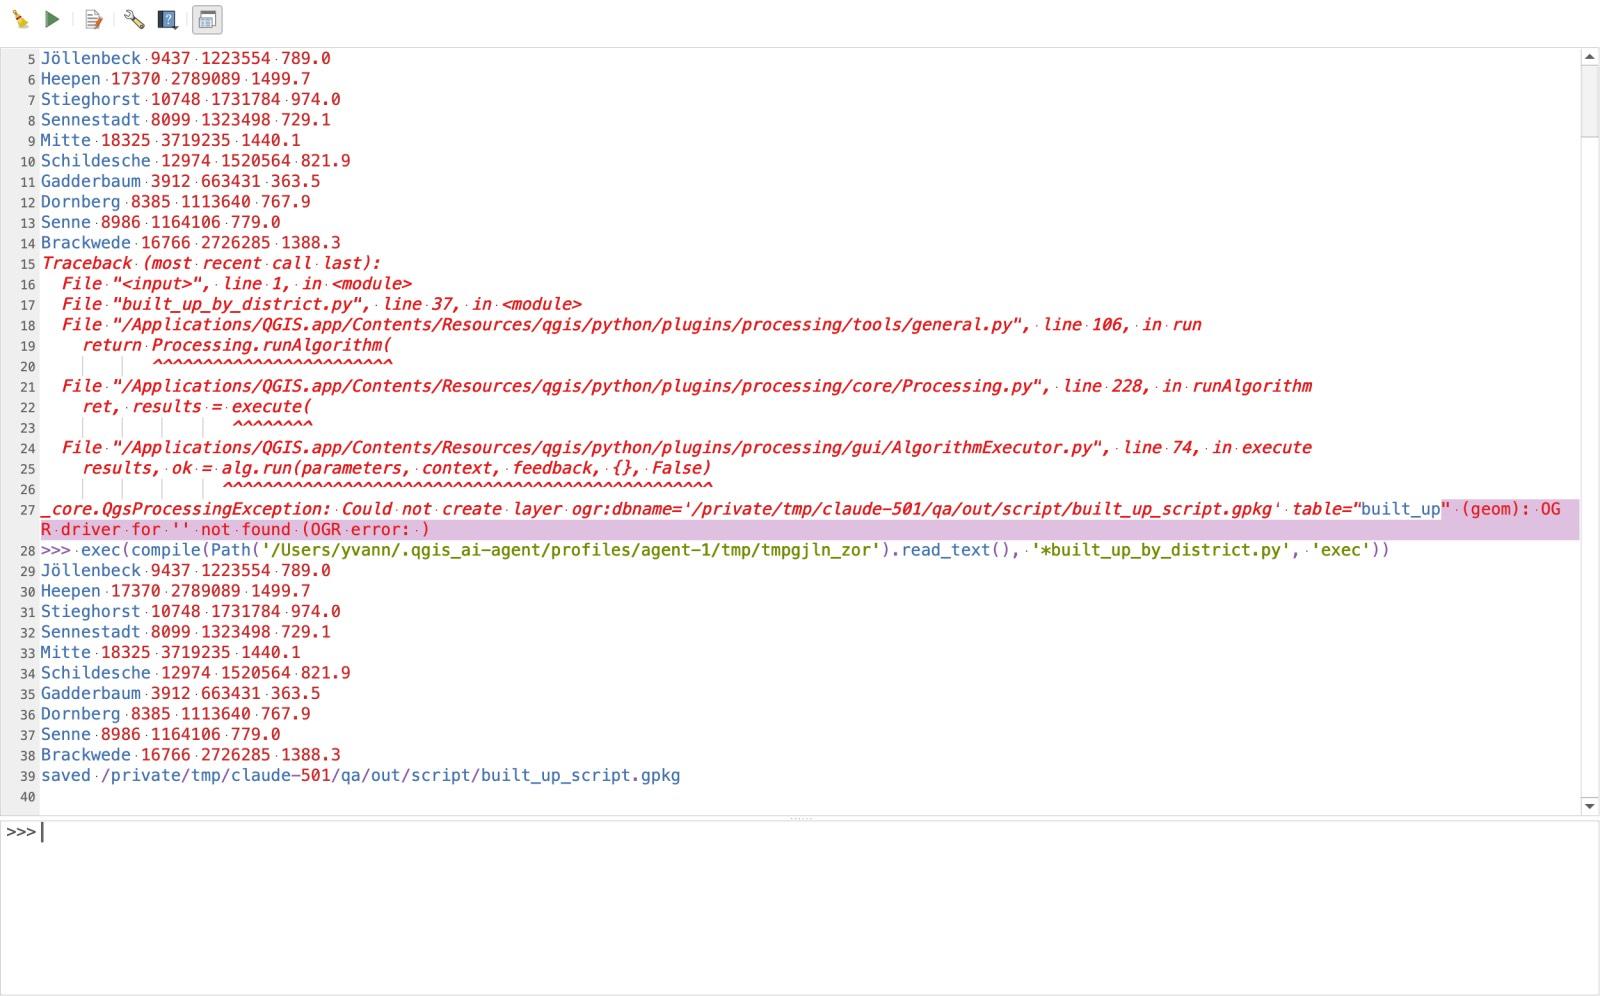
Aby powtórzyć go dla Münster, zmieniłem trzy wiersze na początku (BUILDINGS, DISTRICTS i OUT) i kliknąłem zielony przycisk Run Script. Skończył w 7.4 sekundy. Jeśli chcesz dokładnie poznać działanie processing.run, zajrzyj do naszego przewodnika po PyQGIS.
Jak cztery metody wypadły w obu miastach
Oto co zmierzyliśmy dla wszystkich czterech metod 7 listopada 2026:
| Batch Processing | Graphical Modeler | Skrypt PyQGIS | AI Agent (Medium, Balanced) | |
|---|---|---|---|---|
| Przygotowanie / struktura | 9 uruchomień, 8 algorytmów (2 tabele wsadowe po 10 wierszy) | 3 wejścia + 8 węzłów algorytmów + 1 wynik | 38 wierszy Pythona, 5 algorytmów | 1 wiadomość zwykłym językiem (27 wywołań narzędzi przez agenta) |
| Czas dla Bielefeld (10 dzielnic) | 62.0 s pracy narzędzi (uruchamianych po kolei) | 62.7 s w oknie (44.5 s przez qgis_process) | 8.1 s (po poprawieniu 1 nieudanego zapisu) | 110 s od wysłania do tabeli z odpowiedzią |
| Powtórka dla Münster (6 dzielnic) | 39.8 s pracy narzędzi (odbudowa wierszy wsadowych i wszystkie 9 uruchomień) | 67.2 s (wybór 2 nowych warstw, klik Run) | 7.4 s (zmiana 3 wierszy ze ścieżkami, klik Run) | 60 s (1 dodatkowa wiadomość z 46 słów, 15 wywołań narzędzi) |
Największa różnica od wzorca (built_up_ha) | +0.08% | +0.08% | 0.00% | +0.21% |
| Co zostaje potem | ~20 warstw pośrednich | Jeden plik .model3 (działa w interfejsie i bez niego) | Jeden plik skryptu .py | Historia czatu i tekst twojego polecenia |
Każda metoda zgadzała się ze wzorcem co do liczby budynków i powierzchni obrysów (building_area_m2) do 0.00%. Różnica +0.08% w built_up_ha dla Batch Processing i Graphical Modeler wynika z tego, że $area w Refactor fields mierzy na elipsoidzie projektu, podczas gdy skrypt i wzorzec używały płaskiego geometry().area() w EPSG:25832.
Co się po drodze zepsuło (łącznie z cichą błędną odpowiedzią)
Poradniki rzadko pokazują nieudane uruchomienia, więc przez cały dzień zapisywałem każdy błąd. Najgroźniejsza awaria nie była ani zawieszeniem, ani czerwonym komunikatem błędu: było nią uruchomienie w Graphical Modeler, które zgłosiło sukces i dało zły wynik.
Gdy pierwszy raz uruchomiłem model bez interfejsu, zanim ograniczyłem pola w węźle Intersection, log wypisał:
Model processed OK. Executed 8 algorithm(s) total in 84.548 s.
Żadnego błędu, żadnego ostrzeżenia. Gdy sprawdziłem wynikowy GeoPackage, built_up miał 1,058 poligonów zamiast 10.
Oto dlaczego: budynki OpenStreetMap mają własną kolumnę name (nazwa sklepu, szkoły lub kościoła), a warstwa dzielnic też ma kolumnę name. Gdy Intersection połączył wszystkie pola z obu warstw, name budynków zostało jako name, a name dzielnicy po cichu zmieniło nazwę na name_2. Dalej w łańcuchu Aggregate i Dissolve grupowały po name, czyli po nazwach budynków zamiast dzielnic! Ograniczenie Input fields to keep w Intersection do osm_id zapobiegło kolizji i przywróciło wynik do 10 dzielnic.
Trzy inne rzeczy też się zepsuły i warto o nich wiedzieć, zanim zautomatyzujesz własne dane:
- Nieprawidłowe geometrie OSM domyślnie zatrzymują Processing. Dwa ze 180,602 budynków Bielefeld miały samoprzecinające się pierścienie. Przy domyślnym ustawieniu QGIS Clip od razu się zatrzymuje z komunikatem
Feature (18818404) from 'b' has invalid geometry. Uruchamiaj Fix geometries jako pierwszy krok zawsze, gdy dane pochodzą z surowego OpenStreetMap. savefeaturesw PyQGIS nie lubi ciągów połączenia GDAL. Przy pierwszym uruchomieniu skryptu (10.0 s) przekazanieogr:dbname='...' table="built_up"donative:savefeatureswywołałoOGR driver for '' not found. Podaj zwykłą ścieżkę.gpkgwOUTPUTi ustawLAYER_NAME: "built_up"jako osobny parametr.- Wczytywanie wielu warstw pośrednich wywracało naszą sesję. QGIS padł (
SIGSEGV) trzy razy, gdy wyniki Processing wczytywały się do drzewa warstw z zaznaczonym Load layers on completion. Odznaczenie tej opcji dla pośrednich wierszy wsadowych zatrzymało awarie.
Metoda 4: zapytaj agenta AI w QGIS
Tworzymy AI Agent, więc ta sekcja dotyczy naszej własnej wtyczki. Dokuje ona panel czatu w QGIS, sprawdza warstwy i pola, które już są w projekcie, sama wywołuje narzędzia Processing i PyQGIS i sprawdza wynik przed odpowiedzią.
Przy jednorazowym zadaniu albo projekcie na dwa miasta budowanie modelu z 8 węzłami lub debugowanie 38-wierszowego skryptu to często więcej przygotowań, niż zadanie jest warte. Otworzyłem projekt z warstwami buildings i districts dla Bielefeld, ustawiłem w panelu wysiłek Medium i uprawnienia Balanced, i wysłałem jedną wiadomość:
The project has two layers: "buildings" (OSM buildings of Bielefeld, Germany) and "districts" (its 10 city districts, the district name is in the field "name"). For each district: clip the buildings to the district, count the buildings, sum their footprint area in square meters, and build a 25 m buffer around the clipped buildings, dissolved into one built-up polygon, with its area in hectares. Measure in a metric CRS (EPSG:25832). Write one GeoPackage at [output folder]/built_up_agent.gpkg with a single polygon layer named built_up, one feature per district, fields district, building_count, building_area_m2, built_up_ha, in EPSG:25832. Then show me the result table.
(Ścieżki wynikowe skrócone w obu poleceniach. Uwaga dla przejrzystości: przy pierwszej próbie QGIS padł 9 sekund po kliknięciu Send, z błędem segmentacji w slocie Qt, zanim wróciła jakakolwiek odpowiedź. Otworzyłem projekt ponownie, wysłałem dokładnie to samo polecenie raz i potem już go nie powtarzałem.)
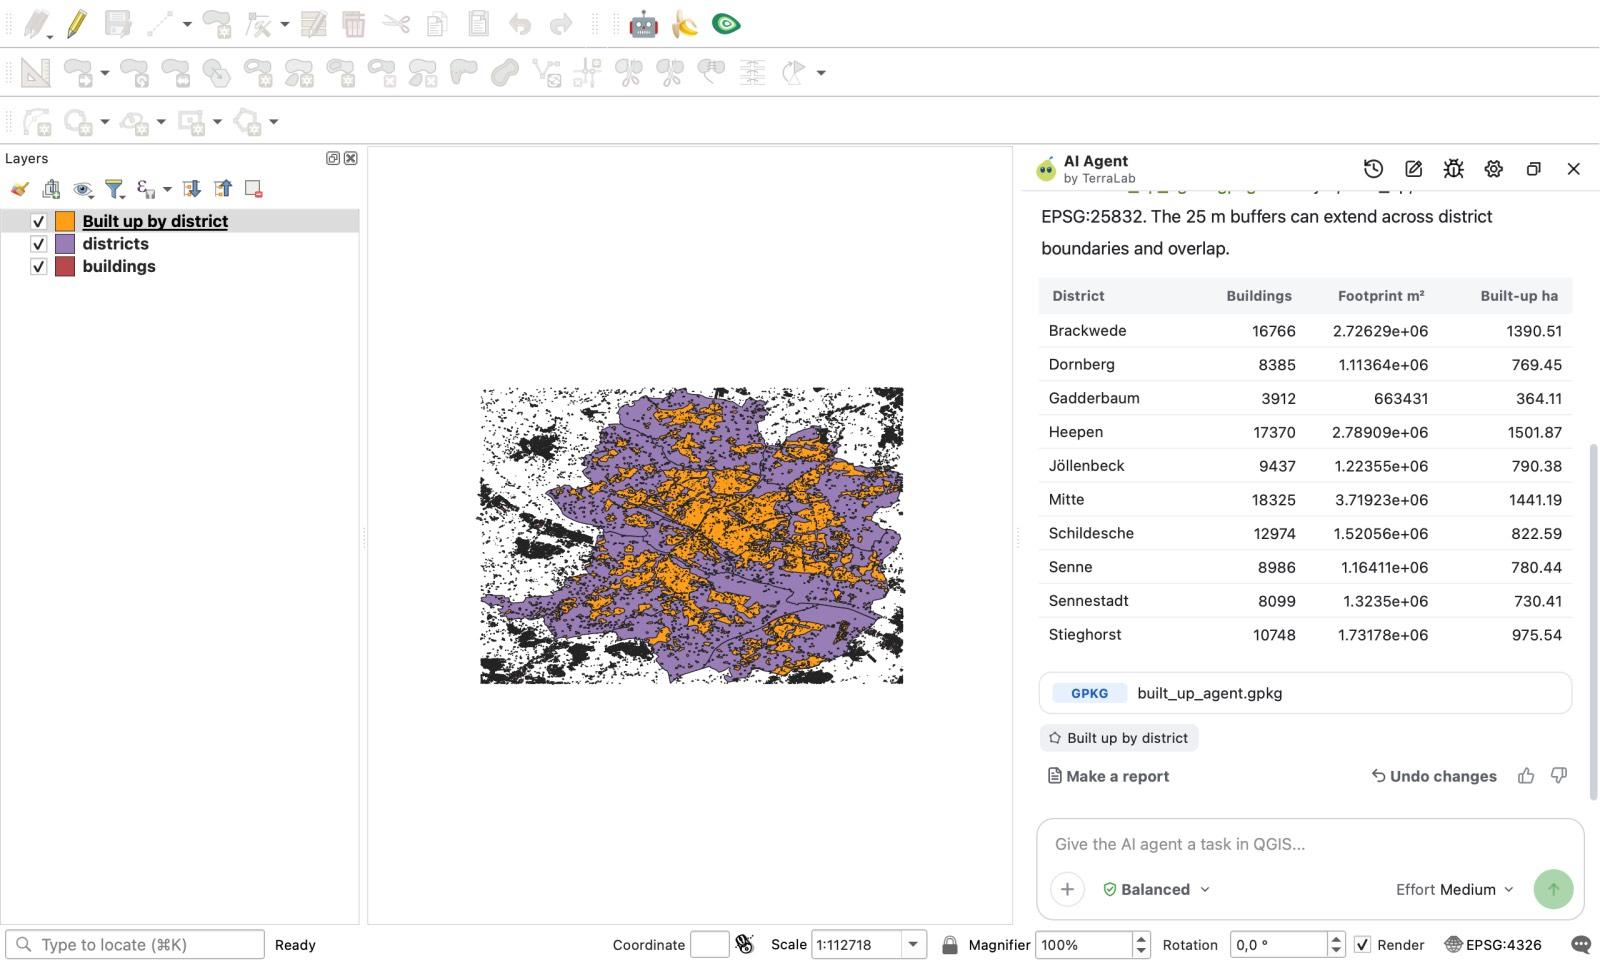
W 110 sekund agent wykonał 27 wywołań narzędzi (12 run_processing, 7 get_algorithm_help, 4 execute_code, 2 get_layer_info, 1 export_layer, 1 get_features), sam poradził sobie z jednym wewnętrznym błędem Processing bez pokazywania karty uprawnień, zapisał GeoPackage i wypisał w czacie tabelę 10 dzielnic. Bez proszenia dodał też w odpowiedzi uwagę: "Bufory 25 m mogą wychodzić poza granice dzielnic i nakładać się na siebie."
Potem przeciągnąłem muenster_buildings i muenster_districts do projektu i w tym samym czacie wpisałem dodatkową wiadomość z 46 słów:
Now do the same for Münster. I added two layers: "muenster_buildings" and "muenster_districts" (6 districts, the name is in the field "name"). Same fields and same 25 m buffer, in a new GeoPackage at [output folder]/built_up_agent_muenster.gpkg with the layer named built_up. Then show me the result table.
Z pierwszym zadaniem w tym samym czacie agent skończył Münster w 60 sekund, w 15 wywołaniach narzędzi (11 run_processing, 1 export_layer, 1 get_features, 1 zoom_to_layer, 1 execute_code), bez żadnego błędu.
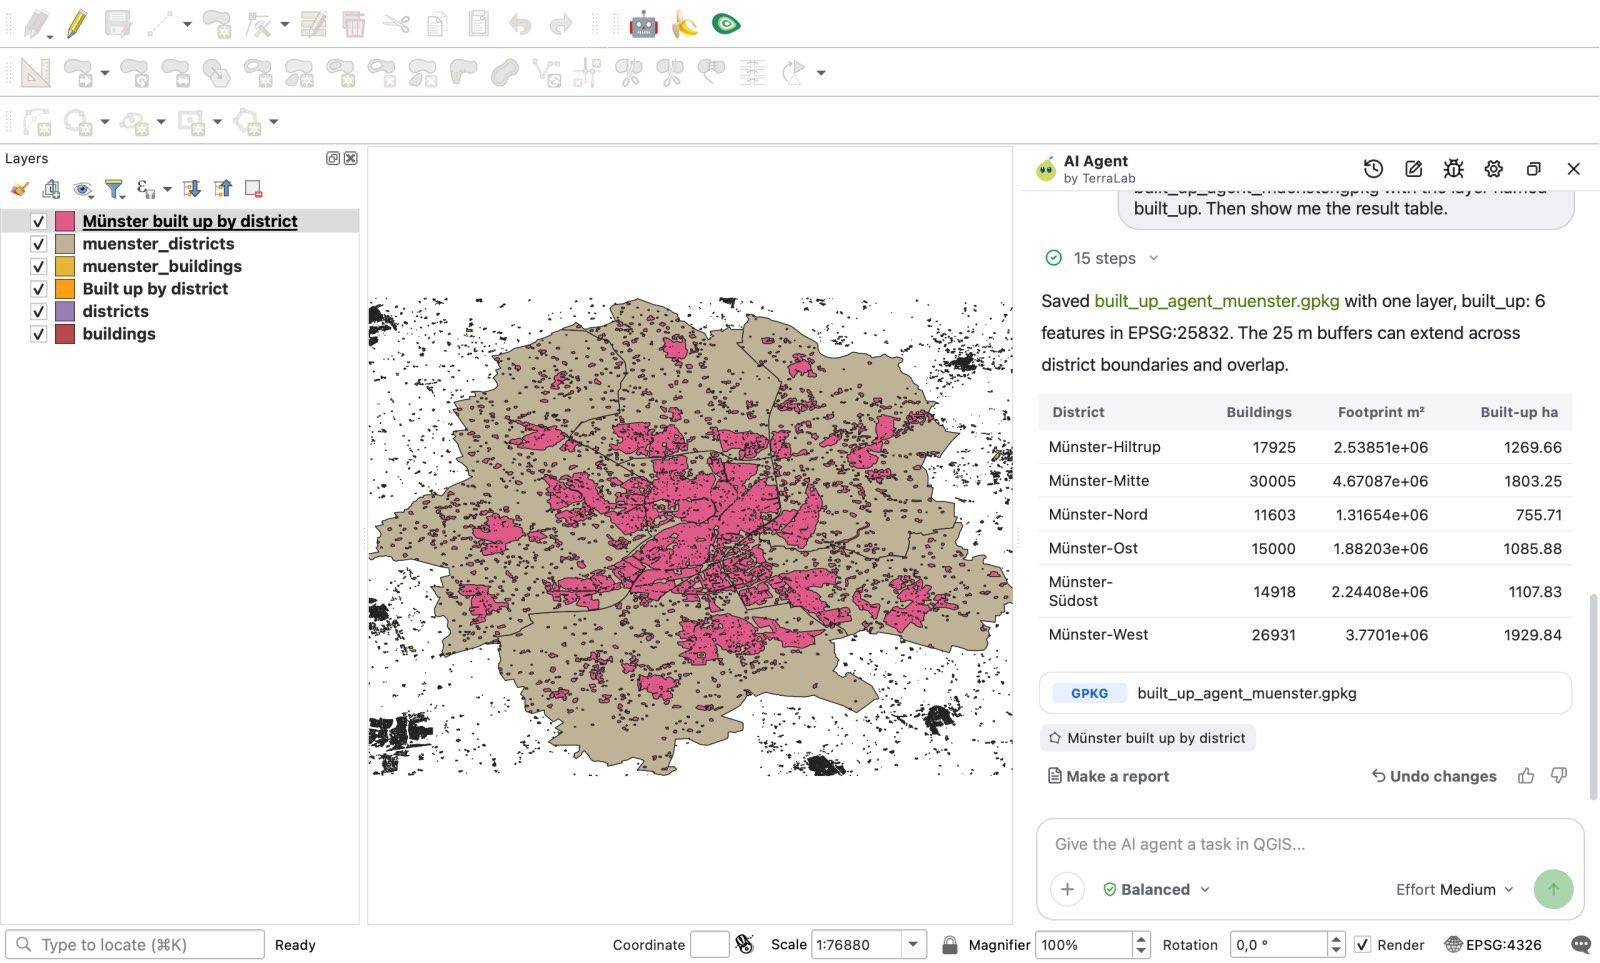
Każda liczba budynków i powierzchnia obrysów zgadzała się ze wzorcem do 0.00% w obu miastach.
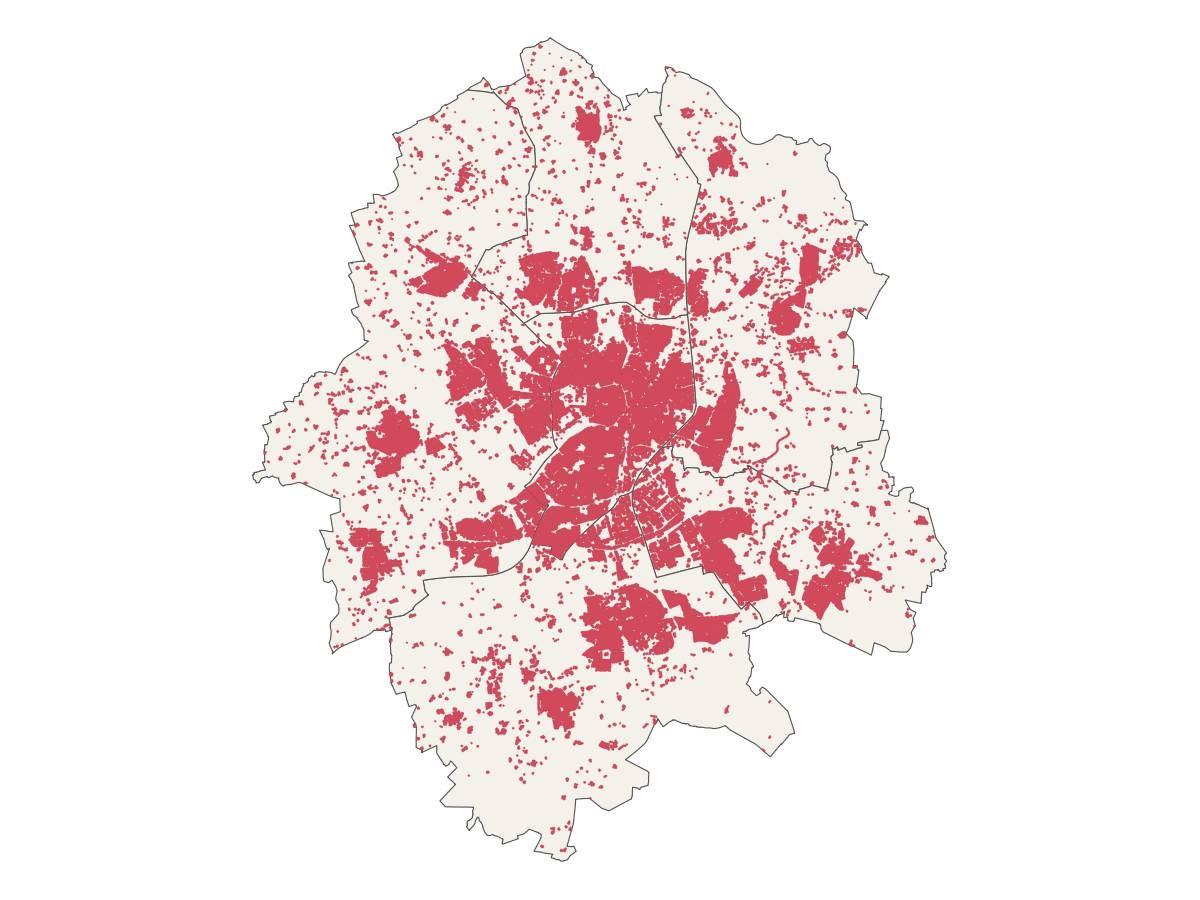
Gdzie są ograniczenia? Po pierwsze, wartości built_up_ha od agenta były o 0.07% do 0.21% wyższe od płaskiego wzorca (na przykład Brackwede wyszło 1,390.51 ha wobec 1,388.31 ha we wzorcu; nie zmierzyliśmy, który wewnętrzny krok dał tę małą różnicę). Po drugie, wyeksportowany GeoPackage zachował dodatkową kolumnę _export_fid. Po trzecie, i to najważniejsze dla automatyzacji: agent planuje kroki od nowa przy każdej wiadomości (27 wywołań narzędzi dla Bielefeld, 15 dla Münster) i działa w otwartej sesji QGIS, więc nie zostawia pliku .model3 ani .py, który można zaplanować bez nadzoru w cron.
Którą metodę automatyzacji QGIS wybrać?
Zamiast ogłaszać jedno narzędzie zwycięzcą, dopasuj metodę do tego, jak często będziesz powtarzać zadanie:
- Uruchamiasz dokładnie to samo jedno narzędzie na 10 do 100 plikach: użyj Batch Processing. Jest wbudowane w każde okno Processing, nic nie kosztuje i nie wymaga kodu. Przestań go używać, gdy tylko twój proces łączy trzy lub cztery różne narzędzia.
- Ty lub twój zespół będziecie uruchamiać wieloetapowy łańcuch co miesiąc albo według harmonogramu na serwerze: zbuduj go w Graphical Modeler. Dostajesz jeden plik
.model3, którym podzielisz się z kolegami, którzy nie piszą w Pythonie, i który uruchomisz bez interfejsu ze skryptu powłoki lub zaplanowanego zadania przezqgis_process. - Potrzebujesz własnych pętli, dokładnej kontroli płaskich pomiarów albo najszybszego wykonania: napisz skrypt PyQGIS. Nasz 38-wierszowy skrypt działał 8 do 9 razy szybciej niż model w obu miastach.
- Masz złożone zadanie do wykonania raz, dwa razy albo w kilku wariantach projektu dzisiaj: użyj agenta AI w QGIS, takiego jak AI Agent (albo zobacz szerszy przegląd na stronie QGIS AI). Nie szukasz dokładnych nazw narzędzi, a powtórka dla drugiego miasta to jedno zdanie. Plan Free daje 5 zadań miesięcznie przy wysiłku Low; te testy działały na Medium, który jest w planie Pro (49 EUR / miesiąc netto, 300 zadań).
Jak to zmierzyliśmy. Wszystkie testy odbyły się 7 listopada 2026 na jednym Macu z Apple Silicon (macOS 27.0.1, arm64) w odizolowanej sesji QGIS 3.44.15-Solothurn (Python 3.12.11) z AI Agent 1.9.4 (wysiłek Medium, tryb Balanced). Obciążenie komputera zmieniało się w ciągu dnia, więc porównuj czasy jako rzędy wielkości, a nie jako testy wydajności procesora. Mierzyliśmy czas wykonania na zegarze komputera i liczbę kroków, a nie minuty, których analityk GIS potrzebuje, aby wyklikać model lub napisać skrypt od zera. Wszystkie dane wejściowe, plik .model3, skrypty .py, skrypt sprawdzający i surowe logi JSON są w archiwum naszego eksperymentu.
Najczęściej zadawane pytania
Jak zautomatyzować powtarzalny proces w QGIS?
Masz cztery główne opcje, zależnie od tego, jak często zadanie się powtarza. Dla jednego narzędzia na wielu plikach kliknij Run as Batch Process w oknie narzędzia. Dla wieloetapowego łańcucha, który będziesz regularnie powtarzać, połącz narzędzia w Processing > Graphical Modeler i zapisz plik .model3. Dla pętli i najwyższej wydajności napisz skrypt Python z processing.run() w konsoli Python QGIS. Dla analiz jednorazowych lub kilkukrotnych, gdy nie chcesz łączyć węzłów ani pisać kodu, opisz proces zwykłymi słowami we wtyczce z agentem, takiej jak AI Agent.
Graphical Modeler w QGIS czy Python (PyQGIS)?
Używaj Graphical Modeler, gdy twój proces to prosty łańcuch algorytmów Processing i chcesz wizualnego pliku .model3, który otworzą osoby z zespołu nieprogramujące albo który uruchomisz z wiersza poleceń przez qgis_process. Używaj PyQGIS, gdy potrzebujesz pętli po obiektach, trzymania warstw pośrednich w pamięci (skrypt działał 8.1 s wobec 62.7 s dla modelu w naszym teście w Bielefeld), obsługi błędów w kodzie albo jawnej kontroli schematu wyników.
Czy model z Graphical Modeler w QGIS można wyeksportować do skryptu Python?
Tak. Graphical Modeler może wyeksportować model jako skrypt Processing w Pythonie (Export as Script Algorithm), który potem edytujesz, dodając pętle, zmienne lub własną logikę. W tym porównaniu nie testowaliśmy eksportu.
Czy QGIS może uruchamiać zautomatyzowane procesy według harmonogramu bez otwierania aplikacji?
Tak. QGIS ma narzędzie wiersza poleceń qgis_process. Możesz przekazać mu dowolny natywny algorytm lub zapisany plik .model3 (na przykład qgis_process run model3 --BUILDINGS=... --DISTRICTS=... --built_up=...) ze skryptu bash, Harmonogramu zadań Windows albo zadania cron, bez uruchamiania graficznego interfejsu QGIS. W naszym teście w Bielefeld model działał bez interfejsu przez qgis_process w 44.5 sekundy.
Czytaj dalejCzym jest PyQGIS? Automatyzacja QGIS w Pythonie
Zrób to w QGIS, po prostu o to prosząc
AI Agent wykonuje zadanie, które opiszesz, w Twoim własnym projekcie QGIS. Za darmo, bez karty.