QGIS 自动化:批处理、图形建模器、PyQGIS 与 AI,4 种方法在 2 座城市实测计时
发布于
重复性的 QGIS 工作流有四种自动化方式:用批处理(Batch Processing)把一个工具套用到许多文件上;用图形建模器(Graphical Modeler)串起一条要反复执行的工具链;用 PyQGIS 脚本实现循环和精确控制;或者在 QGIS 里用 AI 代理,只发一条普通的自然语言消息就拿到结果。
 工作流有四种自动化方式:用批处理(Batch Processing)把一个工具套用到许多文件上;用图形建模器(Graphical Modeler)串起一条要反复执行的工具链;用
我读过的教程都是在玩具示例上单独讲其中一种,没有一篇测试过把工作流换到一座新城市再跑一遍会怎样。2026 年 11 月 7 日,我选了一个多步骤任务(用德国 Bielefeld 的 180,602 栋 OpenStreetMap 建筑,按区计算建成区面积),在 QGIS 3.44.15 中用四种方法各做一遍,然后把四种方法全部在 Münster(135,577 栋建筑,6 个区)上重跑。每种方法在两座城市上都通过了检查,不过有一次图形建模器先是报告"OK",实际却写出了 1,058 个多边形,而不是 10 个。
8.1秒
PyQGIS 脚本处理 Bielefeld(Münster 7.4 秒)
62.7秒
QGIS 中的图形建模器(无界面 44.5 秒)
60秒
AI Agent 用 1 句话重做 Münster
1,058行
模型静默出错时写出的行数,本应是 10
什么是 QGIS 自动化?
QGIS 自动化,就是让一个处理工具或一串工具在多个图层上运行,而不用手动逐个点开对话框。所有方法的底层都是 QGIS Processing 框架,也就是驱动 Processing Toolbox(处理工具箱)的同一个引擎。无论你从批处理表格、图形建模器图、Python 脚本还是 qgis_process 命令行工具调用,工具本身都一样。所以选自动化方法,其实是在选怎样把这些工具连起来,以及下个月想在磁盘上留下什么文件。
测试任务和数据
我选了一个在城市规划和咨询工作中经常出现的任务:对每个城区,把建筑裁剪到区边界内,统计建筑轮廓数量,按平方米汇总面积,对裁剪后的建筑做 25 米缓冲并融合成一个建成区多边形,最后保存一个干净的 GeoPackage,每个区一行。
如果一栋建筑跨越区界,它会被裁剪,并在它接触到的每个区各计一次。两座城市都使用来自 BBBike PBF 提取文件的 OpenStreetMap 数据(ODbL,OpenStreetMap 贡献者),所有测量都重投影到 EPSG:25832(ETRS89 / UTM zone 32N)。
- 城市 1,Bielefeld: 10 个区(
admin_level=9)内共 180,602 个建筑多边形,裁剪后得到 115,002 个建筑片段。原始 OSM 中有两栋建筑几何无效,用 Fix geometries(修复几何)统一修复了一次,确保四种方法都从同样干净的文件开始。 - 城市 2,Münster(重跑): 6 个区内共 135,577 个建筑多边形,裁剪后得到 116,382 个片段。
在执行四种方法之前,我先用纯 PyQGIS 几何调用(QgsSpatialIndex、geometry.intersection()、unaryUnion() 和 buffer(25, 5),不调用任何 Processing 算法)写了一个独立的参考结果,并保存了一个检查脚本。一种方法只有满足以下条件才算通过:生成一个 GeoPackage,其中有一个 EPSG:25832 的 built_up 多边形图层;每个区的建筑数量完全一致;建筑轮廓面积与参考值相差不超过 0.5%;建成区公顷数相差不超过 1%;事后没有任何手工编辑。
方法 1:批处理
Processing Toolbox 里的每个工具,对话框左下角都有一个 Run as Batch Process(作为批处理运行)按钮。它会把对话框变成一张表格,每一行就是这个工具的一次运行。
在我们的任务里,批处理能干净地完成按区 Clip 和按区 Buffer,因为这两步是在 10 个区上重复完全相同的算法。但它没法一次做完整个工作流:批处理一次只能跑一个工具,最后留给你 10 个独立的输出图层,你还得自己合并、再连接回来。
重投影并拆分输入数据
对建筑图层运行 Reproject layer(Vector general),投影到 EPSG:25832。然后对区图层按 name 字段运行 Split vector layer(Vector general),它会在一个文件夹里为每个区写出一个 GeoPackage。
对所有区批量运行 Clip
打开 Clip(Vector overlay),点击 Run as Batch Process,每个区文件添加一行。把重投影后的建筑设为 Input layer,用 Autofill 自动填入各区的叠加图层和输出表名(clip_<district>),并取消勾选 Load layers on completion。在 Bielefeld 上,10 行全部完成用了 13.7 秒(每个区 1.0 到 4.2 秒)。
开启 Dissolve,批量运行 Buffer
以批处理模式打开 Buffer(Vector geometry):每个裁剪图层一行,Distance 设为 25,Segments 设为 5,勾选 Dissolve result。Bielefeld 的 10 个缓冲共用时 27.7 秒。
合并、汇总,再把表连接回来
运行两次 Merge vector layers(一次合并 10 个裁剪图层,一次合并 10 个缓冲图层)。对合并后的裁剪结果运行 Aggregate(Vector geometry),按 layer 字段分组,得到 building_count(count($id))和 building_area_m2(sum(area($geometry)))。对合并后的缓冲结果运行 Refactor fields(Vector table),用 $area / 10000 这个字段计算器表达式算出 built_up_ha,再按 district 运行 Join attributes by field value(Vector general),生成唯一的输出图层。
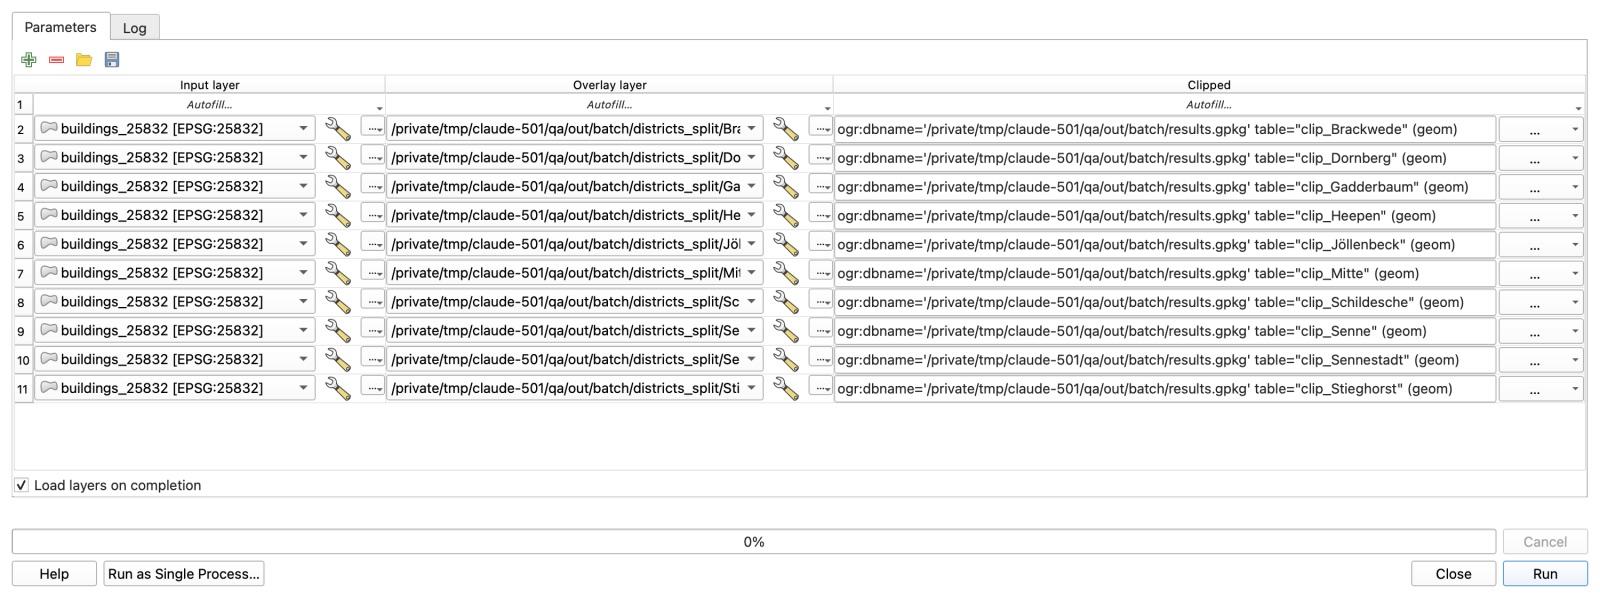
在 Bielefeld 上,9 次运行(8 种不同算法)的工具执行总时间是 62.0 秒,每个区的数量都与参考值一致。在 Münster 上,6 个区的工具时间降到 39.8 秒,但我得重新搭建 6 行的批处理表格,并手动把 9 个步骤全部重跑一遍。如果你的工作流是一串不同的工具,而不是把一个工具重复用在 50 个文件上,批处理就不是合适的形式。
方法 2:图形建模器
图形建模器(Processing > Graphical Modeler)可以把一串 Processing 工具连成一张图,保存为 .model3 文件。建好之后,这个模型会像原生工具一样出现在 Processing Toolbox 里。
你可能以为要在建模器里对各区做循环,其实不用。先在建筑和区之间运行 Intersection,每个建筑片段都会继承所在区的 name 属性,这样按 name 分组的 Aggregate 和 Dissolve 一次就能得到每个区一行。(如果不需要严格在区界处切开建筑,也可以用空间连接。)
添加三个模型输入
在新模型中添加两个 Vector Layer 输入(Polygons),分别命名为 Buildings 和 Districts,再添加一个 Number 输入,命名为 Buffer distance (m),默认值为 25。
重投影两个输入并求交
添加两个目标为 EPSG:25832 的 Reproject layer 节点。把两者都连到一个 Intersection 节点(Buildings 作为 Input,Districts 作为 Overlay)。在 Intersection 的 Input fields to keep 中,建筑字段只保留 osm_id;在 Overlay fields to keep 中保留 name。
分支:Aggregate 算数量,Dissolve + Buffer 出几何
从 Intersection 引出一条分支连到 Aggregate,按 name 分组,计算 count($id) 和 sum(area($geometry))。再从 Intersection 引出第二条分支,连到 Dissolve(字段 name),后接 Buffer(距离关联到 Buffer distance (m) 输入,5 段)。
连接两条分支并整理输出表
添加 Join attributes by field value,按 name 把 Aggregate 的表连接到缓冲多边形上,再用 Refactor fields 把 name 改名为 district,并以 $area / 10000 计算 built_up_ha。把输出标记为 built_up,模型保存为 built_up_by_district.model3。
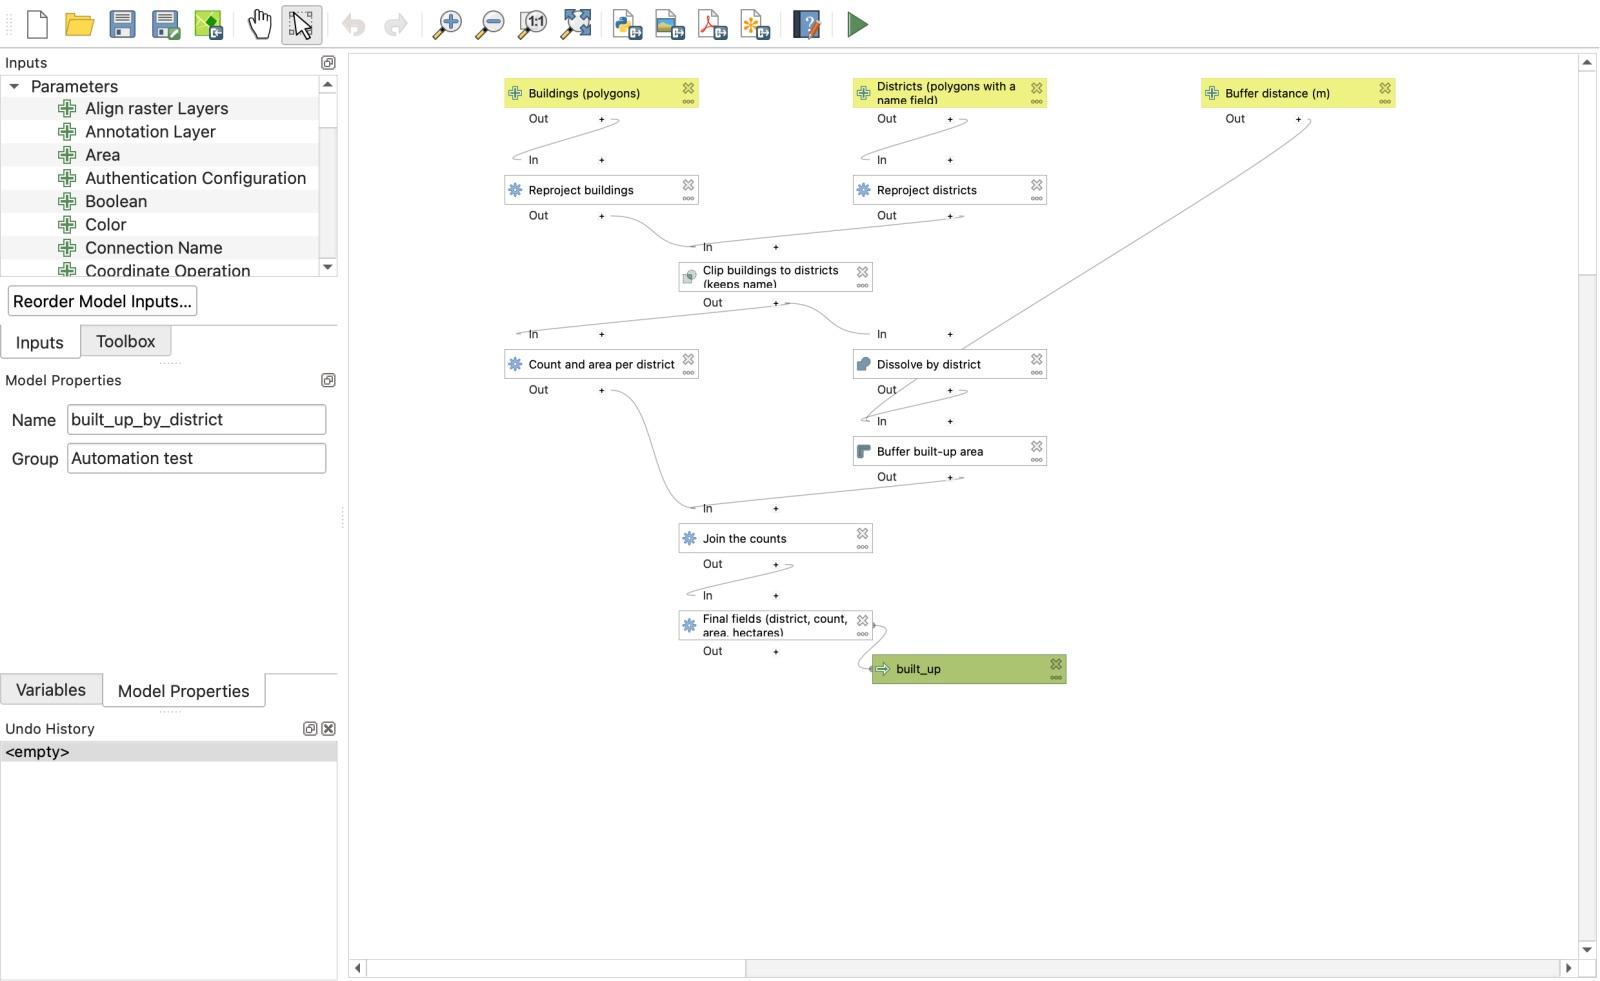
在 Bielefeld 上从模型对话框运行用时 62.7 秒,所有检查都通过。更好的是,同一个 .model3 文件还可以不打开 QGIS 窗口,在 macOS 终端里通过 qgis_process 运行,用时 44.5 秒。
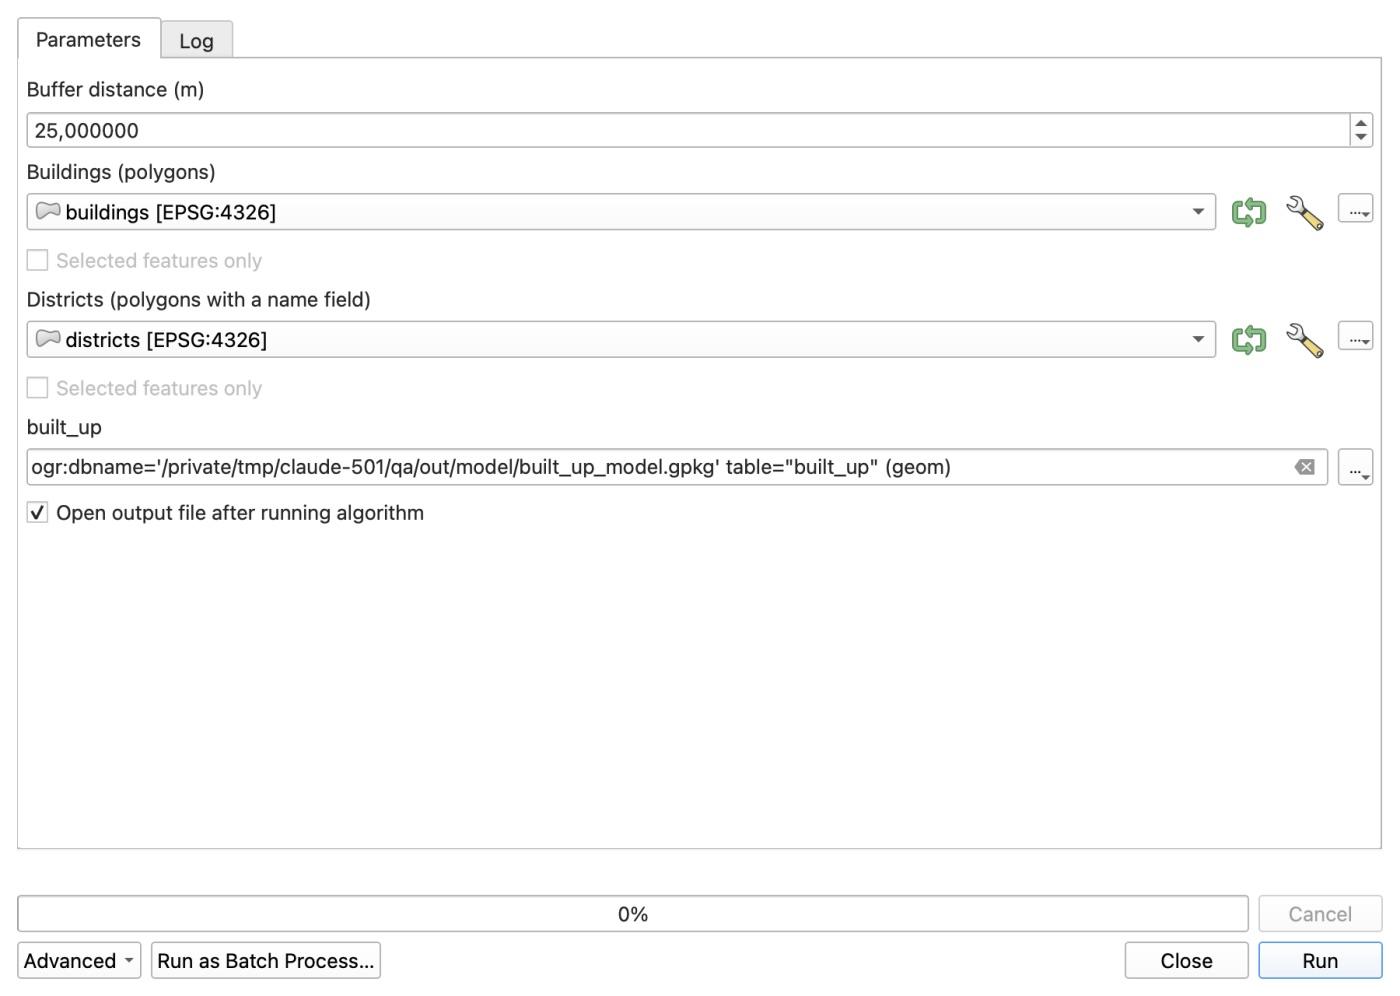
真正的回报出现在 Münster 重跑时。我打开同一个模型对话框,在两个下拉框里选中 muenster_buildings 和 muenster_districts,点击 Run。67.2 秒完成,模型一处都没改。
方法 3:在 Python 控制台中运行 PyQGIS 脚本
如果你熟悉 Python,在 Plugins > Python Console > Show Editor 里写脚本,就能用真正的 for 循环,输入作为变量写在文件开头,也不需要合并步骤。
下面是我在 QGIS 3.44.15 中运行的 38 行脚本(built_up_by_district.py),文件路径已缩短:
# Built-up area by district. Run in the QGIS Python console (Plugins > Python Console > Show Editor > Run).
# Change the first five lines for a new city.
BUILDINGS = "data/bielefeld_buildings.gpkg"
DISTRICTS = "data/bielefeld_districts.gpkg"
NAME_FIELD = "name"
BUFFER_M = 25
OUT = "out/script/built_up_script.gpkg"

import processing
from qgis.core import (QgsVectorLayer, QgsCoordinateReferenceSystem, QgsFeature, QgsField, QgsFields, QgsGeometry)
from qgis.PyQt.QtCore import QVariant

crs = QgsCoordinateReferenceSystem("EPSG:25832")   # metric, Germany
def run(alg, **p):
    return processing.run(alg, p)["OUTPUT"]

buildings = run("native:reprojectlayer", INPUT=BUILDINGS, TARGET_CRS=crs, OUTPUT="memory:")
districts = run("native:reprojectlayer", INPUT=DISTRICTS, TARGET_CRS=crs, OUTPUT="memory:")

result = QgsVectorLayer("MultiPolygon?crs=EPSG:25832", "built_up", "memory")
result.dataProvider().addAttributes([QgsField("district", QVariant.String), QgsField("building_count", QVariant.Int),
                                     QgsField("building_area_m2", QVariant.Double), QgsField("built_up_ha", QVariant.Double)])
result.updateFields()

for d in districts.getFeatures():
    one = run("native:extractbyexpression", INPUT=districts, EXPRESSION=f"$id = {d.id()}", OUTPUT="memory:")
    clipped = run("native:clip", INPUT=buildings, OVERLAY=one, OUTPUT="memory:")
    area = sum(f.geometry().area() for f in clipped.getFeatures())
    built_up = run("native:buffer", INPUT=clipped, DISTANCE=BUFFER_M, SEGMENTS=5, DISSOLVE=True, OUTPUT="memory:")
    geom = next(built_up.getFeatures()).geometry()
    f = QgsFeature(result.fields())
    f.setGeometry(geom)
    f.setAttributes([d[NAME_FIELD], clipped.featureCount(), area, geom.area() / 10000])
    result.dataProvider().addFeature(f)
    print(d[NAME_FIELD], clipped.featureCount(), round(area), round(geom.area() / 10000, 1))

processing.run("native:savefeatures", {"INPUT": result, "OUTPUT": OUT, "LAYER_NAME": "built_up"})
print("saved", OUT)
脚本把所有中间图层都放在内存里,逐区循环,是目前最快的方法(我们没有分析原因)。它在 8.1 秒内完成 Bielefeld,每个区都与独立参考值相差 0.00%。
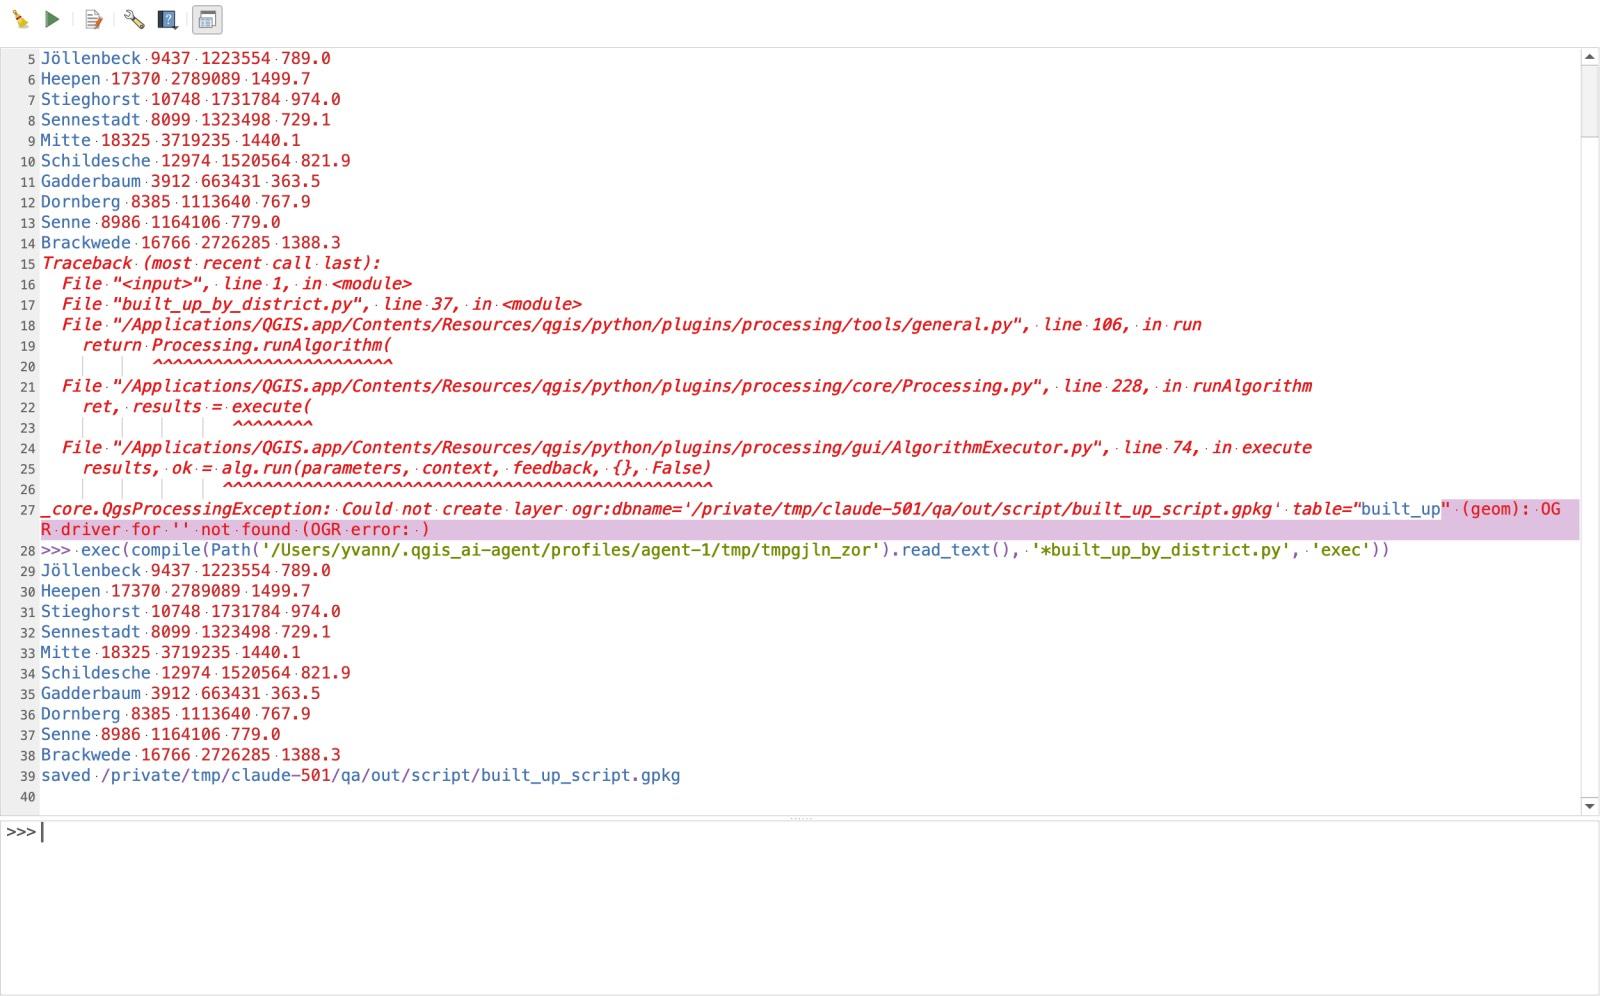
要在 Münster 上重跑,我改了开头三行(BUILDINGS、DISTRICTS 和 OUT),点击绿色的 Run Script 播放按钮。7.4 秒完成。想详细了解 processing.run 的用法,请看我们的 PyQGIS 指南。
四种方法在两座城市上的对比
以下是 2026 年 11 月 7 日我们对四种方法的实测结果:
| 批处理 | 图形建模器 | PyQGIS 脚本 | AI Agent(Medium,Balanced) | |
|---|---|---|---|---|
| 搭建 / 结构 | 8 种算法共 9 次运行(2 张 10 行的批处理表) | 3 个输入 + 8 个算法节点 + 1 个输出 | 38 行 Python,5 种算法 | 1 条自然语言消息(代理调用 27 次工具) |
| Bielefeld 用时(10 个区) | 工具时间 62.0 秒(逐个启动) | 对话框中 62.7 秒(qgis_process 44.5 秒) | 8.1 秒(修好 1 次失败的保存调用后) | 从发送到结果表 110 秒 |
| 换到 Münster(6 个区) | 工具时间 39.8 秒(重建批处理行并重跑全部 9 步) | 67.2 秒(选 2 个新图层,点击 Run) | 7.4 秒(改 3 行文件路径,点击 Run) | 60 秒(1 条 46 个英文单词的追加消息,15 次工具调用) |
与参考值的最大偏差(built_up_ha) | +0.08% | +0.08% | 0.00% | +0.21% |
| 事后留下什么 | 约 20 个中间图层 | 一个 .model3 文件(可在界面或无界面运行) | 一个 .py 脚本文件 | 聊天记录和你的提示词 |
每种方法的建筑数量和建筑轮廓面积(building_area_m2)都与参考值相差 0.00%。批处理和图形建模器在 built_up_ha 上的 +0.08% 偏差,来自 Refactor fields 中的 $area 按项目椭球体测量,而脚本和参考值用的是 EPSG:25832 下的平面 geometry().area()。
途中出过哪些问题(包括一个静默的错误结果)
教程很少展示失败的运行,所以我把当天每个错误都记了下来。最吓人的失败不是崩溃,也不是红色报错条,而是一次图形建模器运行报告成功、输出却是错的。
我第一次在无界面模式下运行模型时,还没限制 Intersection 节点上的字段,日志显示:
Model processed OK. Executed 8 algorithm(s) total in 84.548 s.
没有错误,也没有警告。我检查输出的 GeoPackage 时,发现 built_up 里有 1,058 个多边形 ,而不是 10 个。
原因是:OpenStreetMap 建筑本身有一个 name 列(商店、学校或教堂的名称),区图层也有一个 name 列。Intersection 合并两个图层的全部字段时,建筑的 name 仍然叫 name,而区的 name 被悄悄改名为 name_2。下游的 Aggregate 和 Dissolve 按 name 分组,结果是按建筑名称分组,而不是按区!把 Intersection 的 Input fields to keep 限制为 osm_id 后,冲突消失,输出回到 10 个区。
还有三个问题也坏过,在自动化你自己的数据之前值得了解:
- 无效的 OSM 几何默认会让 Processing 停下。 Bielefeld 的 180,602 栋建筑中有两栋存在自相交的环。在 QGIS 默认设置下,Clip 会立即停止,报
Feature (18818404) from 'b' has invalid geometry。只要输入来自原始 OpenStreetMap,就把 Fix geometries 作为第一步。 - PyQGIS 中的
savefeatures不接受 GDAL 连接字符串。 第一次运行脚本(10.0 秒)时,把ogr:dbname='...' table="built_up"传给native:savefeatures报错OGR driver for '' not found。应在OUTPUT中传普通的.gpkg路径,并单独设置参数LAYER_NAME: "built_up"。 - 加载大量中间图层让我们的会话崩溃。 勾选 Load layers on completion 时,Processing 输出加载到图层树的过程中,QGIS 崩溃(
SIGSEGV)了三次。对中间批处理行取消勾选后,崩溃就停止了。
方法 4:在 QGIS 里询问 AI 代理
AI Agent 是我们开发的,所以这一节讲的是我们自己的插件。它在 QGIS 里停靠一个聊天面板,读取项目中已有的图层和字段,自己调用 QGIS Processing 工具和 PyQGIS,并在回答前检查输出。
对于一次性的任务或只涉及两座城市的项目,搭一个 8 节点的图形模型或调试一个 38 行的脚本,往往比任务本身还费事。我打开一个包含 Bielefeld buildings 和 districts 图层的项目,把面板设为 Medium 力度和 Balanced 权限,发送了一条消息:
The project has two layers: "buildings" (OSM buildings of Bielefeld, Germany) and "districts" (its 10 city districts, the district name is in the field "name"). For each district: clip the buildings to the district, count the buildings, sum their footprint area in square meters, and build a 25 m buffer around the clipped buildings, dissolved into one built-up polygon, with its area in hectares. Measure in a metric CRS (EPSG:25832). Write one GeoPackage at [output folder]/built_up_agent.gpkg with a single polygon layer named built_up, one feature per district, fields district, building_count, building_area_m2, built_up_ha, in EPSG:25832. Then show me the result table.
(两条提示词中的输出路径都已缩短。透明说明:第一次尝试时,我点击发送 9 秒后,QGIS 因 Qt slot 段错误崩溃,没有返回任何回答。我重新打开项目,把完全相同的提示词发送了一次,之后没有再重发。)
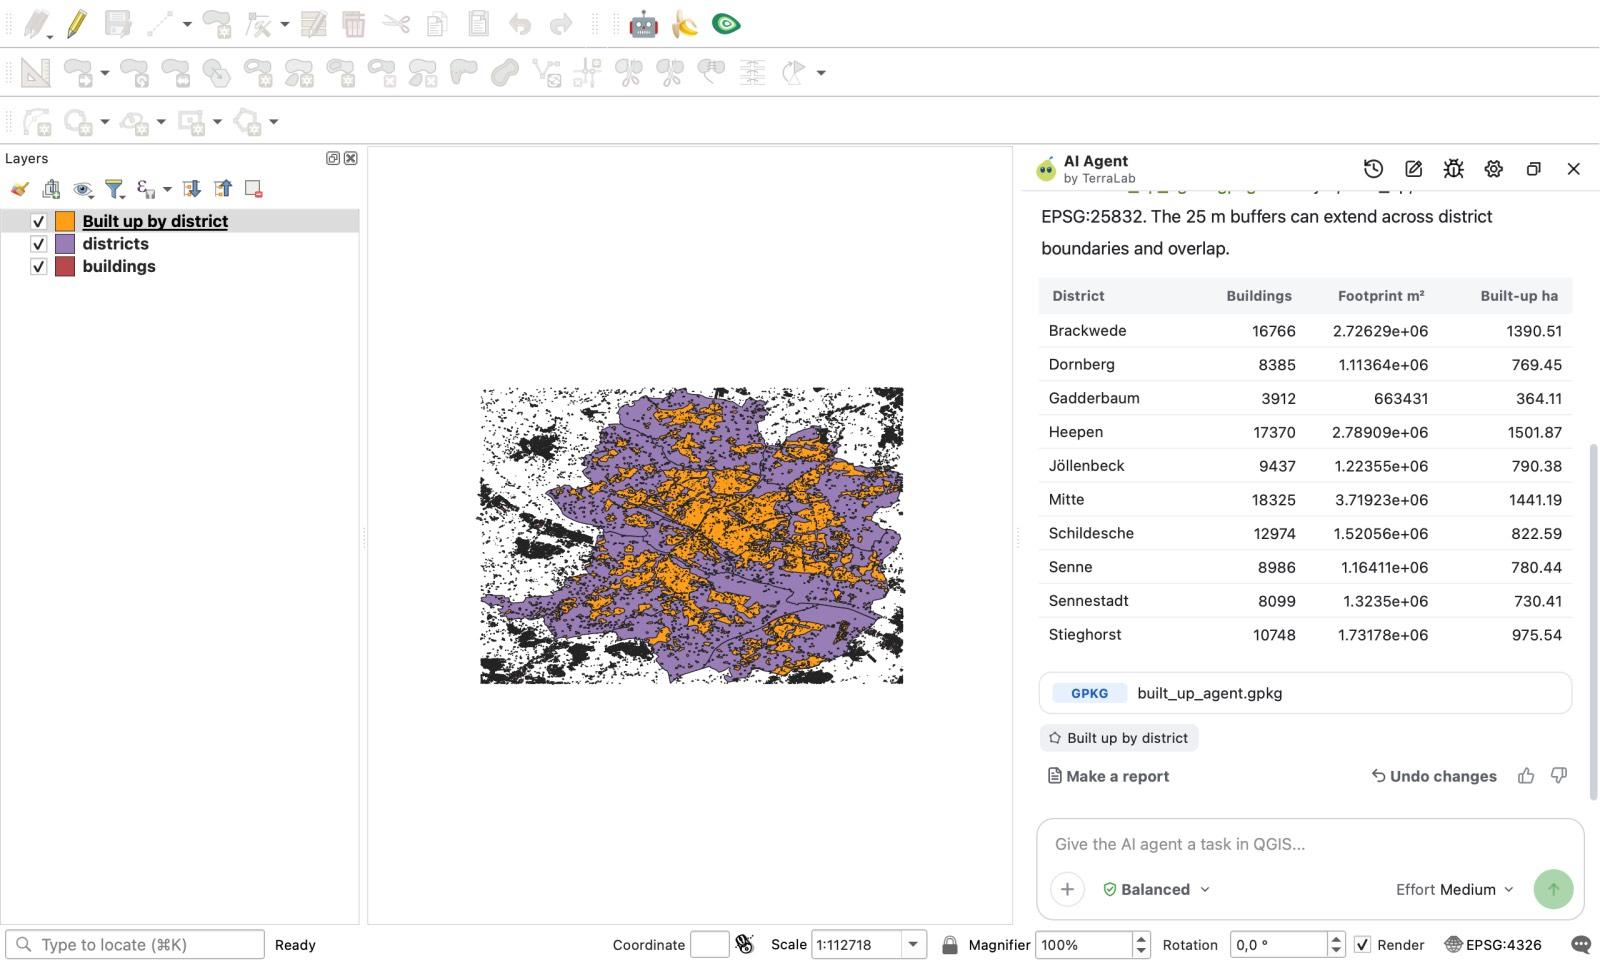
在 110 秒 内,代理完成了 27 次工具调用(12 run_processing、7 get_algorithm_help、4 execute_code、2 get_layer_info、1 export_layer、1 get_features),自行从一个内部 Processing 错误中恢复,没有弹出权限卡片,写好了 GeoPackage,并在聊天中列出 10 个区的表格。没有任何提示,它还在回答中指出:"The 25 m buffers can extend across district boundaries and overlap."(25 米缓冲可能跨越区界并相互重叠。)
接着,我把 muenster_buildings 和 muenster_districts 拖进项目,在同一个对话里输入了一条 46 个英文单词的追加消息:
Now do the same for Münster. I added two layers: "muenster_buildings" and "muenster_districts" (6 districts, the name is in the field "name"). Same fields and same 25 m buffer, in a new GeoPackage at [output folder]/built_up_agent_muenster.gpkg with the layer named built_up. Then show me the result table.
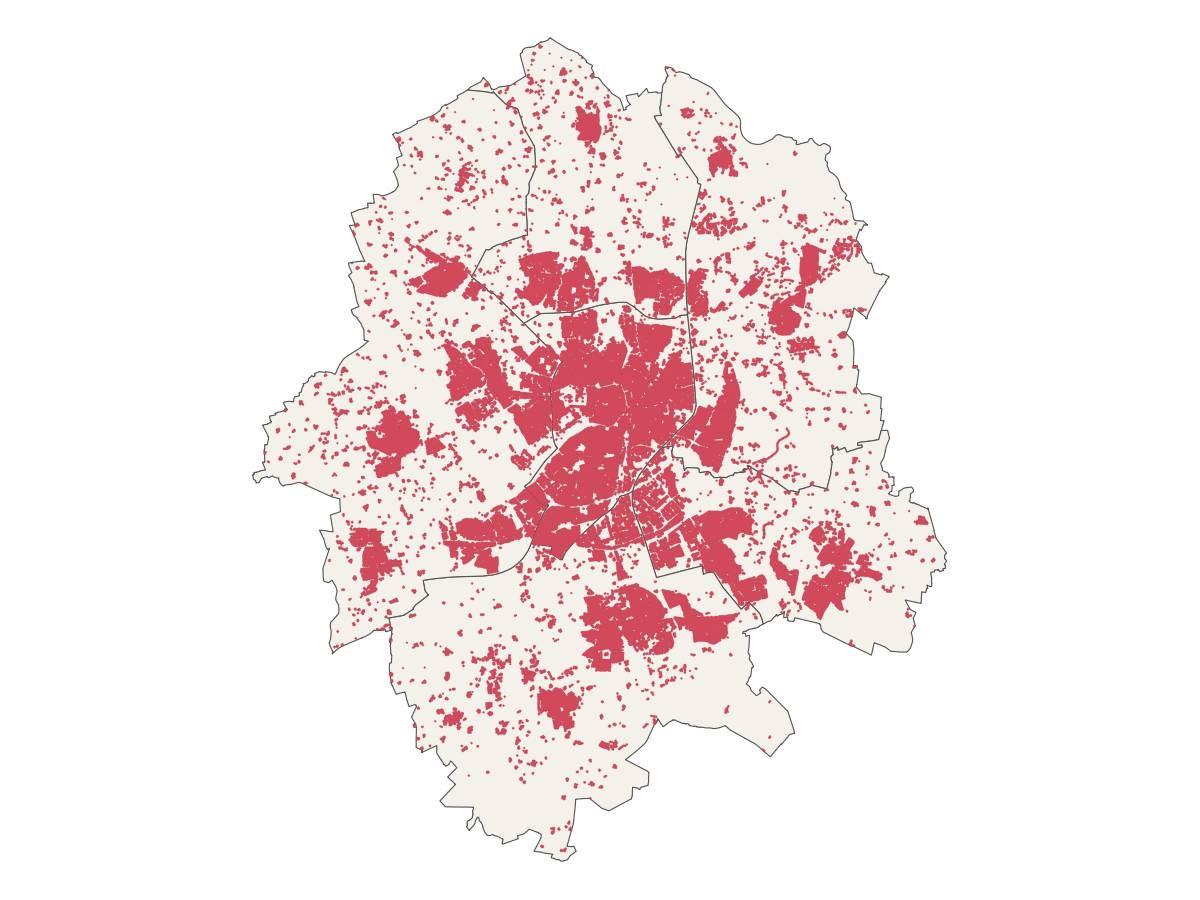
由于第一次的测试就在同一个对话里,代理在 60 秒 内完成了 Münster,共 15 次工具调用(11 run_processing、1 export_layer、1 get_features、1 zoom_to_layer、1 execute_code),没有任何错误。
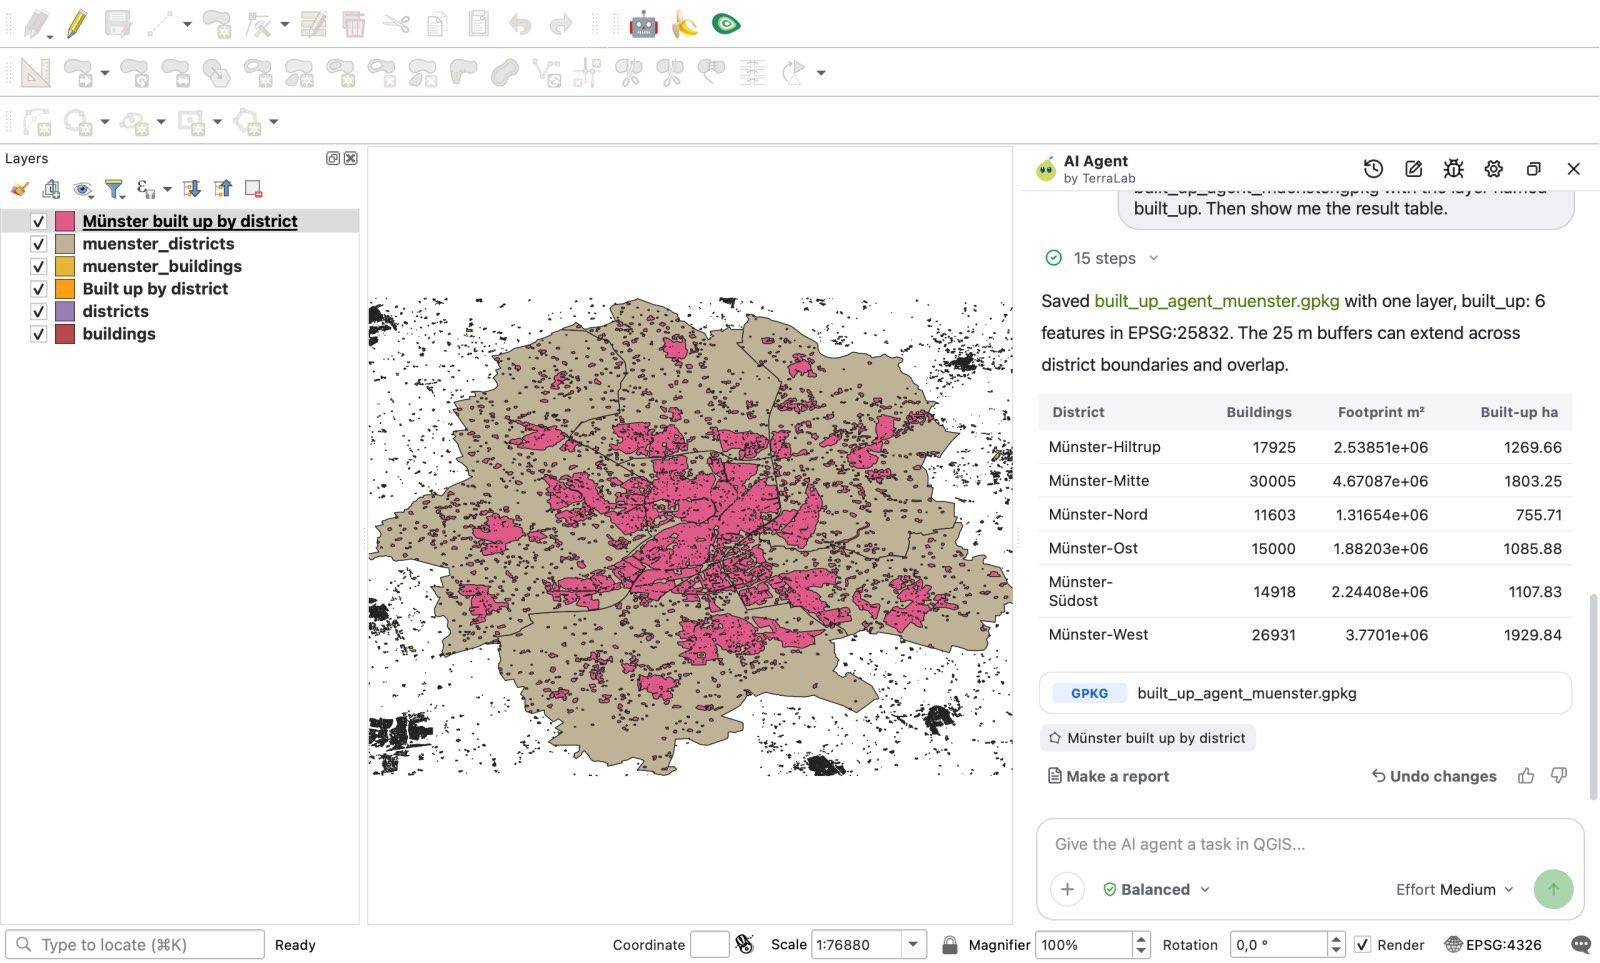
两座城市的每个建筑数量和轮廓面积都与参考值相差 0.00%。
局限在哪里?第一,代理的 built_up_ha 值比平面参考值高 0.07% 到 0.21%(例如 Brackwede 的结果是 1,390.51 ha,参考值为 1,388.31 ha;我们没有测量这个小偏差来自哪个内部步骤)。第二,导出的 GeoPackage 多保留了一个 _export_fid 列。第三,也是对自动化最重要的一点:代理每条消息都会重新规划步骤(Bielefeld 27 次工具调用,Münster 15 次),并且在打开的 QGIS 会话中执行,所以它不会留下可以用 cron 无人值守定时执行的 .model3 或 .py 文件。
该选哪种 QGIS 自动化方法?
不必认定某个工具是赢家,按你重复这项工作的频率来选方法:
- 把同一个工具原样用在 10 到 100 个文件上: 用 批处理 。它内置在每个 Processing 对话框里,不花钱,也不用写代码。一旦工作流要串起三四个不同的工具,就别再用它。
- 你或团队每个月都要跑一条多步骤工具链,或要在服务器上定时执行: 在 图形建模器 里搭建。你会得到一个
.model3文件,可以分享给不写 Python 的同事,也可以通过qgis_process从 shell 脚本或计划任务中无界面执行。 - 需要自定义循环、精确的平面计算或最快的执行速度: 写一个 PyQGIS 脚本 。我们的 38 行脚本在两座城市上都比建模器快 8 到 9 倍。
- 今天要把一个复杂任务做一两次,或在几个项目变体上各做一次: 用 QGIS 里的 AI 代理,比如 AI Agent(也可以看看我们更全面的 QGIS AI 专题)。你不用去找确切的工具名称,换到第二座城市只需一句话。免费版每月可用 5 个任务,力度为 Low;这些测试用的是 Medium,属于 Pro 版(每月 49 EUR,不含增值税,300 个任务)。
我们如何测量。 所有测试都在 2026 年 11 月 7 日完成,使用一台 Apple Silicon Mac(macOS 27.0.1,arm64),在隔离的 QGIS 3.44.15-Solothurn 会话(Python 3.12.11)中进行,AI Agent 版本 1.9.4(Medium 力度,Balanced 模式)。当天机器负载有波动,所以请把这些时间当作数量级来比较,而不是 CPU 基准测试。我们测量的是机器的实际执行时间和步骤数,不是 GIS 分析师从零拼出一个模型或写出一个脚本所花的人工时间。所有输入、.model3 文件、.py 脚本、参考检查脚本和原始 JSON 日志都保存在我们的实验存档中。
常见问题
如何在 QGIS 中自动化重复性的工作流?
根据任务重复的频率,主要有四种选择。一个工具用在许多文件上,在该工具的对话框里点击 Run as Batch Process 。需要定期重跑的多步骤工具链,在 Processing > Graphical Modeler 中把工具连起来,保存为 .model3 文件。需要循环和最快速度,在 QGIS Python 控制台中用 processing.run() 写 Python 脚本。只做一次或少数几次、不想连节点也不想写代码的分析,在 AI Agent 这类代理插件里用普通语言描述工作流即可。
QGIS 图形建模器和 Python(PyQGIS)该用哪个?
如果工作流是一条直线式的 Processing 算法链,并且你想要一个可视化的 .model3 文件,让团队里不会编程的人也能打开,或者想用 qgis_process 从命令行运行,就用图形建模器。如果需要遍历要素、把中间图层留在内存里(在我们的 Bielefeld 测试中,脚本用时 8.1 秒,模型 62.7 秒)、在代码中处理错误,或明确控制输出结构,就用 PyQGIS。
能把 QGIS 图形模型导出为 Python 脚本吗?
可以。图形建模器能把模型导出为 Python Processing 脚本(Export as Script Algorithm),之后你可以编辑它,加入循环、变量或自定义逻辑。本次对比没有测试导出功能。
QGIS 能不打开软件就按计划自动执行工作流吗?
可以。QGIS 自带一个名为 qgis_process 的命令行工具。你可以从 bash 脚本、Windows 任务计划程序或 cron 任务中,把任何原生算法或任何已保存的 .model3 文件交给它(例如 qgis_process run model3 --BUILDINGS=... --DISTRICTS=... --built_up=...),无需启动 QGIS 图形界面。在我们的 Bielefeld 测试中,模型通过 qgis_process 无界面运行用时 44.5 秒。