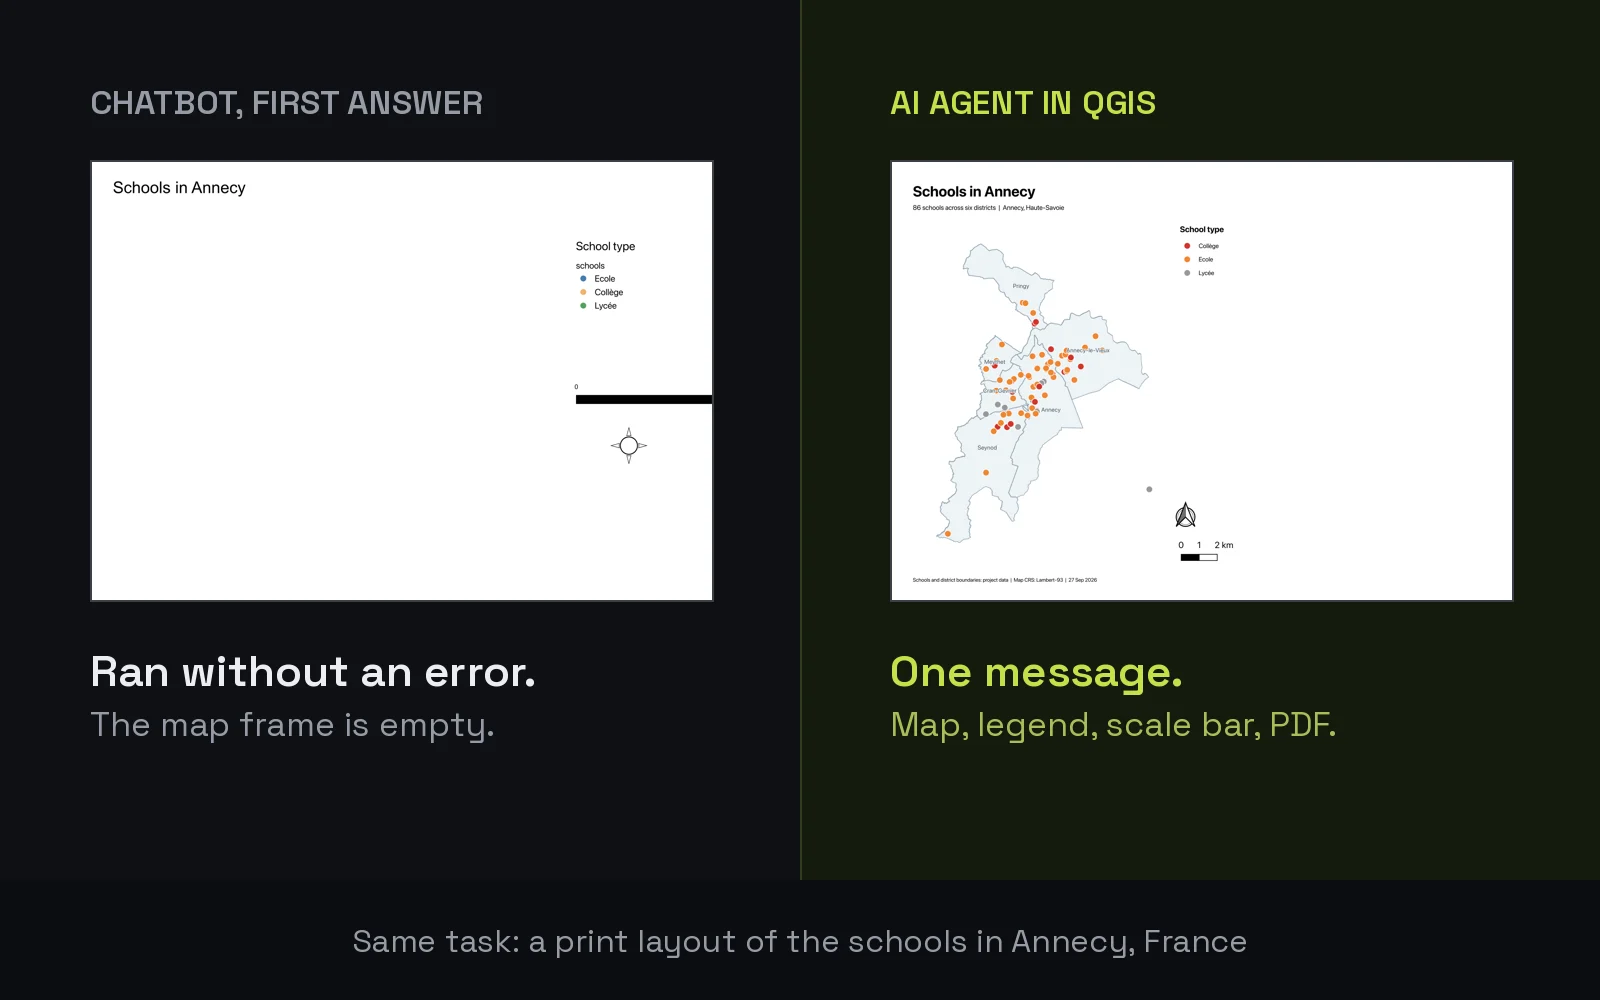
AI Agent QGIS 插件:最强大的 QGIS AI 智能体
发布于
TerraLab 的 AI Agent 是一款免费的 QGIS 插件,可以在 QGIS 内回答地理空间问题。在 Google Research 于 2026 年 10 月发布的两个地理空间基准测试 GeoKTools 和 GeoExpertQueries 上,它在 Low 强度(GPT-6 Luna)下,对 41 道保留题得分 43.8(满分 100)。对比之下,通过 nkarasiak 的 QGIS MCP 服务器在 Claude Code 中驱动 QGIS 的 Claude Sonnet 5.5 得分 24.9,通过 jjsantos01 的 QGIS MCP 服务器在 OpenAI 的 Codex 中运行的 GPT-6 Luna 得分 22.1,不使用任何工具、单独运行的 GPT-6 Luna 得分 21.0。这是我们在 QGIS 中测试的所有 AI 智能体里的最高分,测试于 2026 年 10 月 16 日至 20 日进行,由 Google 自己的评分代码打分。
您用平实的语言提问,例如洪水风险、出行时间或水资源压力。插件会找到数据,用 QGIS 运行分析,并把结果作为图层添加到您的工程中,同时注明数据来源。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
GeoKTools 和 GeoExpertQueries 上 0 到 100 的准确率,这是 Google Research 为地理空间智能体发布的基准测试(arXiv:2610.15750):41 道与我们的调优无关的保留题,由 Google 自己的评分代码打分,取 3 次运行的平均值。插件使用 Low 强度,即免费套餐的设置。
AI Agent 在 Google 的地理空间基准测试中得了多少分?
| AI Agent QGIS 插件(Low:GPT-6 Luna) | Claude Sonnet 5.5 + QGIS MCP(nkarasiak, Claude Code) | GPT-6 Luna + QGIS MCP(jjsantos01, Codex) | GPT-6 Luna 单独运行(无工具) | |
|---|---|---|---|---|
GeoKTools 30 道题 Google 的确定性离线评分器 确定性评分器 | 53.5Low 强度 | 33.3 | 39.5 | 44.2 |
GeoKTools 30 道题 Google 的报告协议:完全匹配,否则由 Gemini 3.8 Flash 评判 Google 的报告协议 | 36.9Low 强度 | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 道题 与工具无关的自动评分器,Gemini 3.8 Flash,3 次评判 自动评分器,3 次评判 | 62.6Low 强度 | 29.3 | 8.6 | 0.0 |
全部 41 道题 41 道题 两个基准测试,Google 的报告协议 Google 的报告协议 | 43.8Low 强度 | 24.9 | 22.1 | 21.0 |
得分为 0 到 100,每个系统取 3 次运行的平均值,所有评分器均为 Google 自己的、未作修改:确定性评分器、报告协议和 GeoExpertQueries 自动评分器。AI Agent 于 2026 年 10 月 20 日在 Low 强度(GPT-6 Luna)下运行;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) in Claude Code 于 10 月 18 日运行;GPT-6 Luna + QGIS MCP (jjsantos01) in Codex(OpenAI)于 10 月 16 日和 17 日运行;GPT-6 Luna alone 于 10 月 19 日运行。粗体表示每一行的最高分。
优势在逐题比较中同样成立。在 41 道题中,Low 强度的 AI Agent 有 26 道得分高于 Claude Sonnet 5.5 + QGIS MCP (nkarasiak),5 道低于;有 24 道高于 GPT-6 Luna + QGIS MCP (jjsantos01),7 道低于。它对 Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 的平均领先幅度为 19 分,95% 置信区间为 10 到 29 分。
- 更高
- 持平
- 更低
逐题比较:Low 强度的 AI Agent(GPT-6 Luna)对比 Claude Sonnet 5.5 + QGIS MCP (nkarasiak) in Claude Code,各自取 3 次运行的平均值。GeoKTools 使用 Google 的报告协议,GeoExpertQueries 使用自动评分器。
GeoKTools 和 GeoExpertQueries 是什么?
它们是 Google Research 随 Google Earth AI 地理空间推理智能体的论文一同发布的两个基准测试(arXiv:2610.15750,2026 年 10 月 11 日)。题目公开在 google-research/geospatial-reasoning-benchmarks 仓库中,采用 CC BY 4.0 许可;Google 的官方测试题保持私有。
- GeoKTools 提出事实性问题,答案需要一到四类地理空间数据:行政边界、统计数据、气象记录、地点数量。Google 的确定性评分器对数字允许 10% 的容差并给予部分得分;它的报告协议则要求完全匹配,或经评判者认可。
- GeoExpertQueries 提出分析师会遇到的开放性问题,涉及选址、自然灾害和公共卫生等领域。Google 的自动评分器对照专家编写的工作流程来评判每个回答。
AI 智能体在 QGIS 中能做什么?
它通过在 QGIS 内处理真实数据来回答关于地点的问题:查找数据集,运行出行时间、叠加分析或按区域统计等空间分析,并返回一张附有数据来源的地图。下面是三个示例,每个都是从空白的 QGIS 工程出发、在免费套餐所用的 Low 强度下拍摄的。第一个来自 Google 的论文。另外两个由我们按相同风格编写,三个都不在计分题目之内。
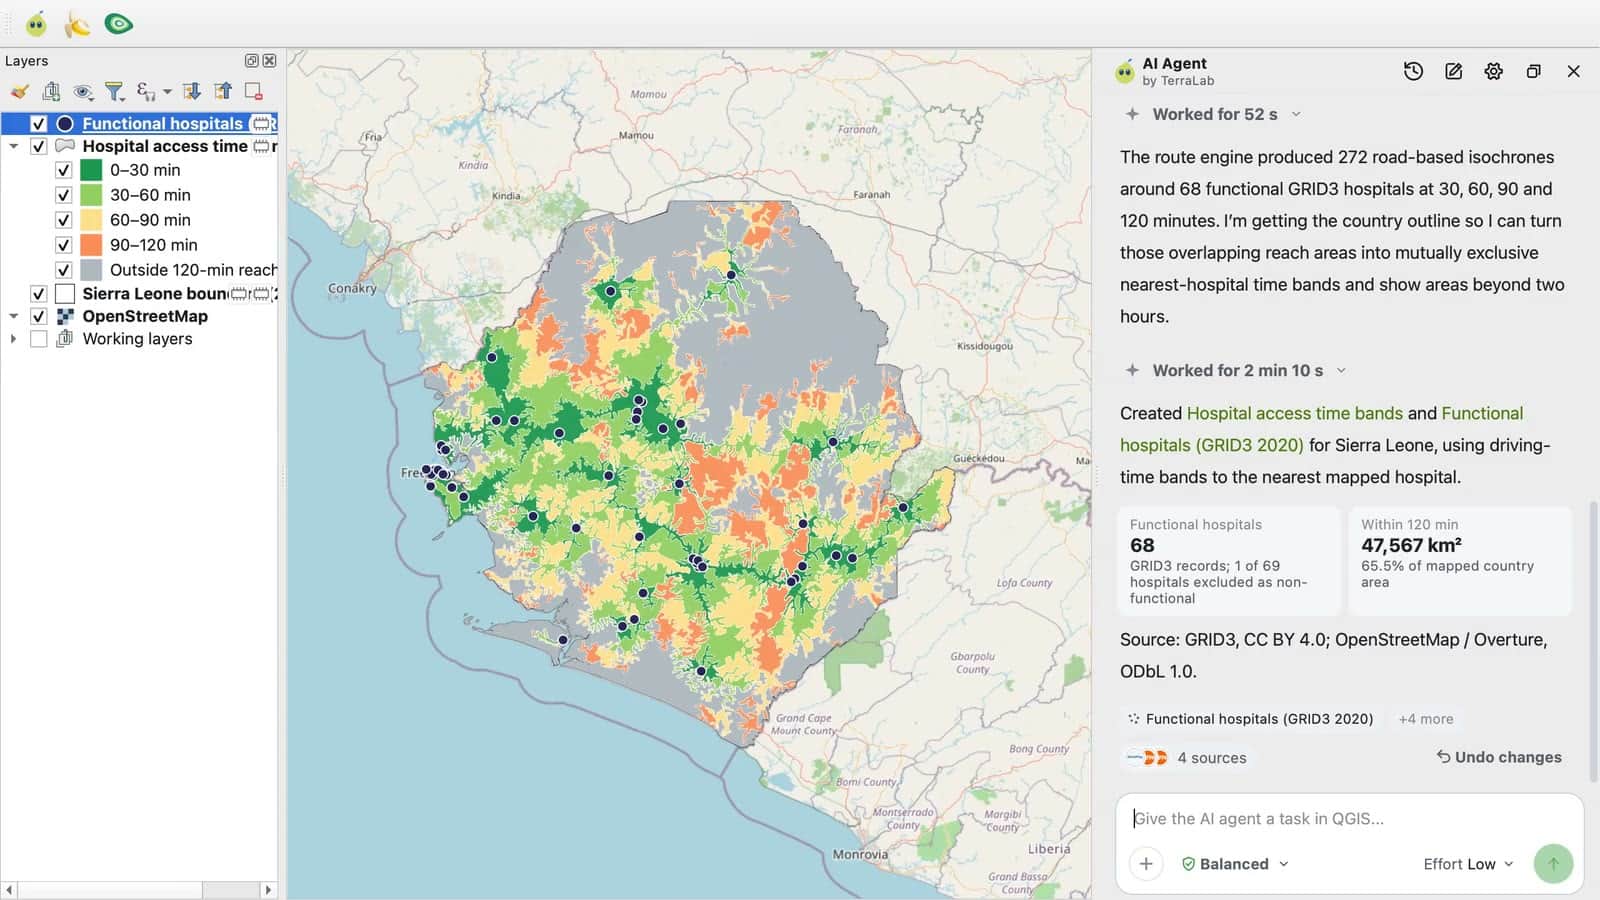
- 问题
- 请绘制一张地图,显示塞拉利昂境内任意地点的孕妇前往最近医院进行紧急分娩所需的出行时间。请使用出行时间,而不是直线距离。
- 答案
- 插件先询问人们如何出行、哪些医疗设施应计入。选择驾车出行,并以所有已绘制的医院作为替代,它以 30 分钟为一档绘制了到最近的 68 家医院的耗时:已绘制国土面积的 65.5% 位于两小时车程以内。耗时约 5 分钟。
- 难在哪里
- 它需要全国范围的道路出行时间,而不是直线距离,还需要对哪些设施应计入做出选择,而这是任何模型都无法凭记忆做出的。
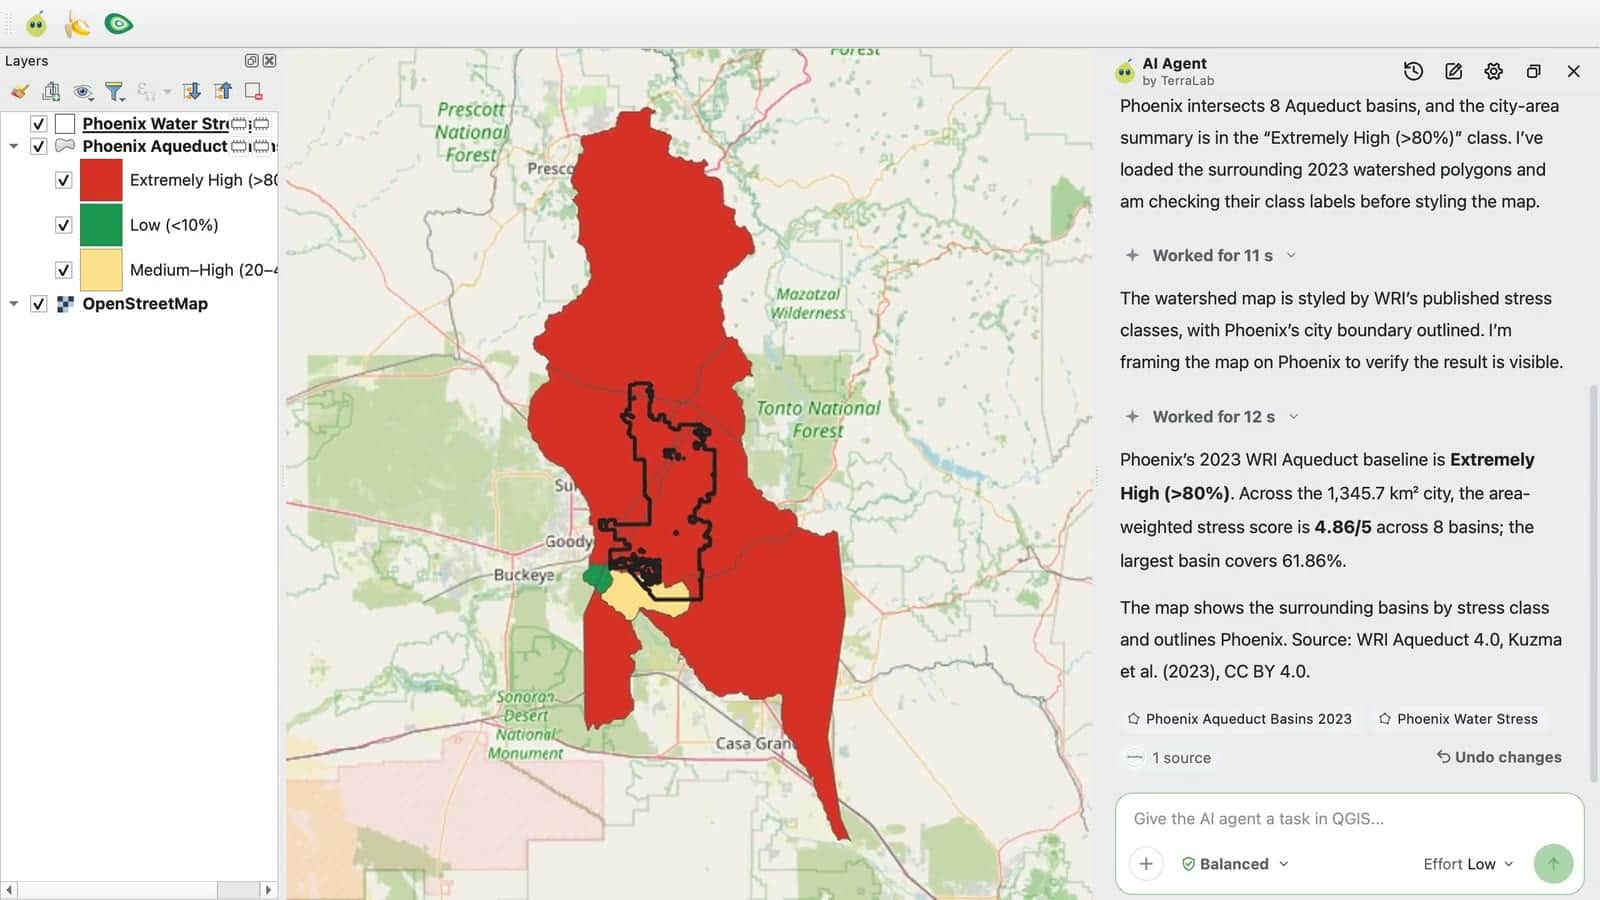
- 问题
- 亚利桑那州凤凰城周边的水资源压力有多大?请给出该地的 WRI Aqueduct 基线水资源压力,并在地图上显示。
- 答案
- Extremely High,高于 80%。穿过该市的 8 个 WRI Aqueduct 流域,按面积加权得出 4.86(满分 5),并注明了数据来源及其许可。耗时约 1 分钟。
- 难在哪里
- 答案必须来自一个指定的数据集,并综合该市所覆盖的每个流域,而不是来自模型对凤凰城的记忆。
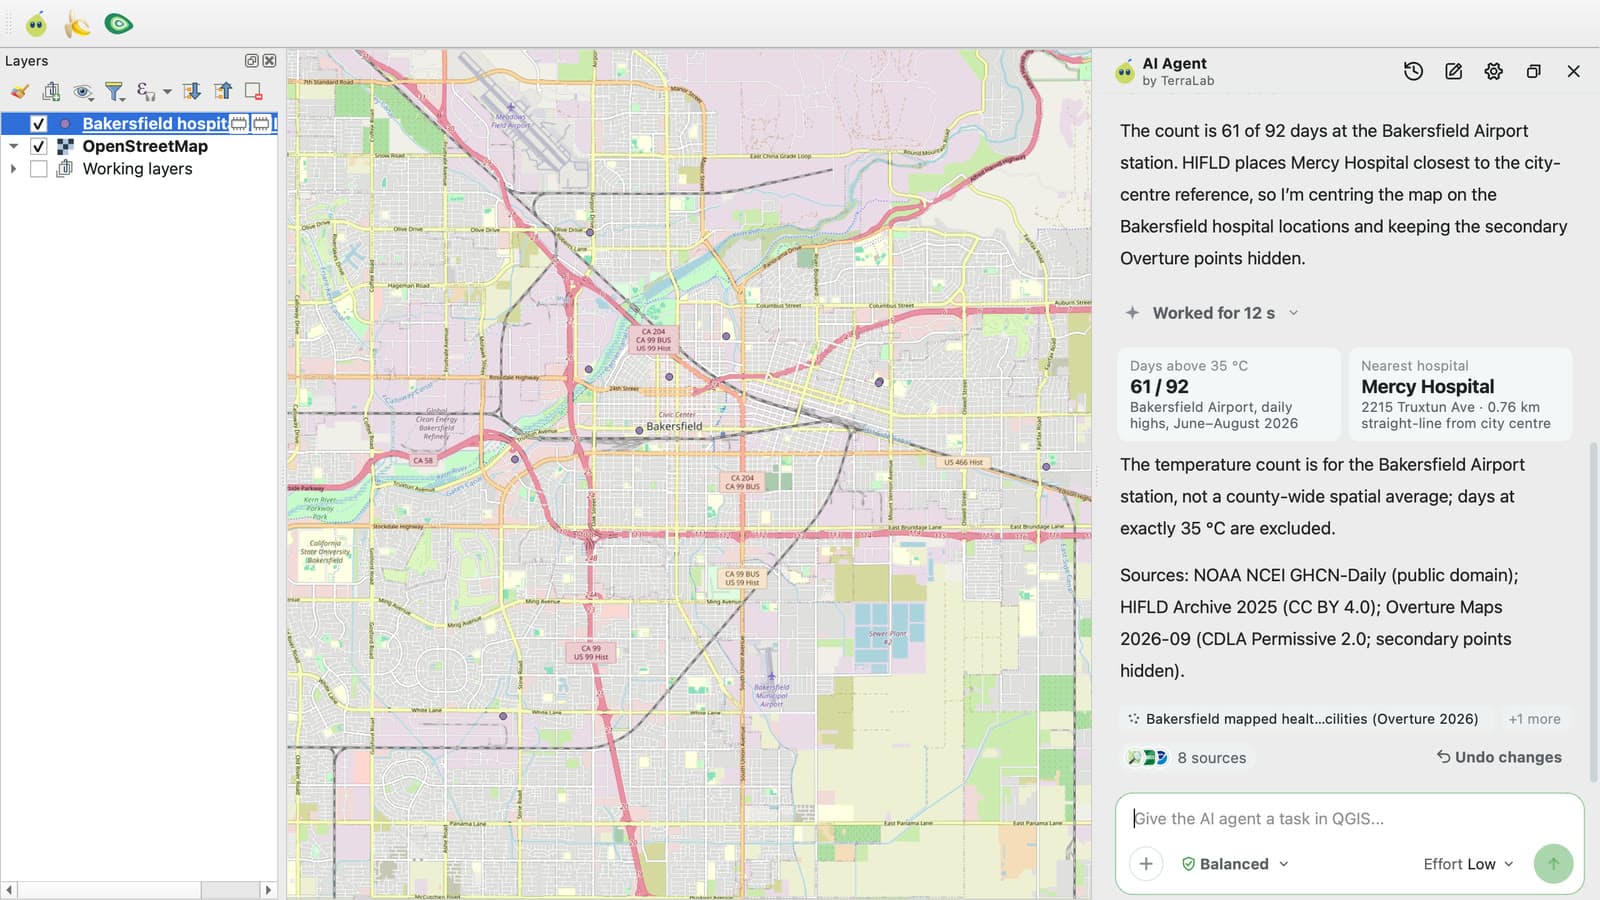
- 问题
- 加利福尼亚州克恩县去年夏天(2026 年 6 月至 8 月)有多少天气温超过 35 °C?另外,县治所在地贝克斯菲尔德最近的医院是哪一家?
- 答案
- 在贝克斯菲尔德机场气象站,92 天中有 61 天高于 35 °C,并注明这是单个站点的数据,而不是全县平均值。最近的医院是 Mercy Hospital,距市中心 0.76 公里。耗时约 2 分钟。
- 难在哪里
- 它要综合三类数据源:每日气象记录、医院名录和地点地图,而且那个夏天离现在太近,无法凭记忆回答。
QGIS AI 插件比搭配 QGIS MCP 服务器的 Claude 或 ChatGPT 更好吗?
在这些基准测试中,是的。QGIS MCP 服务器通过模型上下文协议(Model Context Protocol)把 Claude 或 ChatGPT 这类聊天模型连接到 QGIS,让模型可以调用 QGIS 的函数。这样模型能够操作 QGIS,但仍然要自己找数据、选择每一步,并检查自己的工作。没有任何连接的语言模型则只能凭记忆作答。
AI Agent QGIS 插件为模型提供了地理空间工作所需的一切:专为 GIS 打造的工具、可合法使用的授权数据,以及在回答前对每个结果的检查。它直接在 QGIS 内运行,因此模型是在真实图层上使用真实的 QGIS 工具,您也可以在工程中打开每一个结果。
最清楚的对比是同一个模型的三种用法。单独使用时,GPT-6 Luna 能记起一部分 GeoKTools 的答案,而在 GeoExpertQueries 的每个任务上得 0 分。在 OpenAI 的 Codex 中通过 jjsantos01 的 QGIS MCP 服务器连接 QGIS 后,得分大致相同。在插件的 Low 强度下,同一个模型在 GeoKTools 上得 53.5,在 GeoExpertQueries 上得 62.6。
- GPT-6 Luna 单独运行(无工具)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- AI Agent QGIS 插件(Low:GPT-6 Luna)
GeoKTools 使用 Google 的确定性评分器,GeoExpertQueries 使用其自动评分器。GPT-6 Luna + QGIS MCP 是在 10 月 16 日和 17 日,于 OpenAI 的 Codex 中使用 jjsantos01 的服务器运行的,而不是 Claude Sonnet 5.5 所用的 nkarasiak 服务器和 Claude Code。AI Agent 的 Low 强度运行的是 GPT-6 Luna。三种 GPT-6 Luna 的配置都使用了高推理。
插件在每个难度级别上都领先。GeoKTools 的每道题都需要多种数据。需要两种数据时,它的得分远高于其他所有系统。需要四种时,所有系统都很吃力,而插件依然领先。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- GPT-6 Luna 单独运行(无工具)
- AI Agent,实时数据(Low:GPT-6 Luna)
使用 Google 的报告协议打分,对象是 30 道与我们的调优无关的 GeoKTools 保留题:20 道需要两种数据类型,5 道需要三种,5 道需要四种。所有只需一种数据类型的题目都来自我们在拆分前研究过的模板,因此这一组被排除在外。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
使用 Google 的确定性评分器。每种类型有 3 到 5 道题,所以一道题就会让得分大幅变动。除预测淹没面积这一类(没有任何系统答得出来)外,AI Agent 在每种类型上都领先 Claude Sonnet 5.5 + QGIS MCP (nkarasiak)。在环形区域内的地点这一类上,GPT-6 Luna + QGIS MCP (jjsantos01) 领先 1.3 分。我们在拆分前研究过的两种类型,即某点周边的水资源压力和某区域的极值点,被排除在外。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
使用 Google 与工具无关的自动评分器。公共卫生只有 2 道题,所以一道题就会让得分大幅变动;AI Agent 和 Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 在这一领域同为 25.0,而 GPT-6 Luna alone 在每个领域都得 0 分。
AI Agent 在其他 GIS 基准测试中表现如何?
我们还在 Google 之外的两个公开基准测试上运行了 AI Agent,我们没有针对其中任何一个做过调优。每个答案都由我们自己的代码对照各基准的参考答案打分。没有其他智能体在相同条件下运行,所以这里没有正面对比。
GeoBenchX:160 个任务的 62.8%
GeoBenchX(arXiv:2503.18129)要求在开放数据上完成多步 GIS 工作:合并表格、处理图层,并绘制国家、城市和地区的地图。有些任务要求的内容是数据无法提供的,正确的做法是如实说明。AI Agent 在两次运行中平均通过了 160 个任务的 62.8%。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
由代码对照基准回放的参考解答打分,不使用 AI 评判。总分是两次运行的平均值,分别为 65.0% 和 60.6%;其他两行来自第一次运行。GeoBenchX 自己的结果和 Axis Spatial 的表格使用 AI 评判,且任务集不同,所以我们不把自己的得分与它们并列。
GS-QA2:245 道题得 61.1(满分 100)
GS-QA2 由加州大学河滨分校的 Shang 等人提出,询问关于美国各地的空间问题:最近的要素、方向或距离,地面的坡度、坡向或海拔。每个参考答案都来自固定的 OpenStreetMap 快照和高程模型。在使用同一份数据时,AI Agent 得 61.1(满分 100)。使用今天的实时数据时得 22.0,因为快照之后新增、改名或重新绘制的地点,与参考答案不再吻合。AI Agent 在 Low 强度下运行的模型 GPT-6 Luna 单独运行,得 15.1。
- AI Agent QGIS 插件(Low:GPT-6 Luna)
- AI Agent,实时数据(Low:GPT-6 Luna)
- GPT-6 Luna 单独运行(无工具)
得分为 0 到 100,取该基准 49 个题目模板的平均值,运行 3 次。由代码按论文的容差打分,不使用 AI 评判。Axis Spatial 在相同数据设置下发布了 GS-QA2 的得分,但抽取的题目不同,且使用私有的检查器,因此两者没有可比性。
其他面向 GIS 智能体的公开基准测试还有 GISAgentBench 和 GeoNatureAgent。我们没有在它们上运行过 AI Agent,所以本页不报告它们的得分。
我们是如何测试的?
- Google Research 随论文发布了 GeoKTools 和 GeoExpertQueries(arXiv:2610.15750)以及练习题;官方测试题保持私有。这是我们在公开题目上自行运行的结果,不是 Google 的排行榜。
- 我们用一半的公开题目改进智能体,并在另外 50 道题上测量,按题目模板划分。在拆分之前,我们探索基准测试时曾带着答案研究过两个模板。保留的 50 道题中有 9 道来自这两个模板,所以我们把它们排除在外:这里的每个得分都基于其余 41 道与我们的调优无关的保留题。
- 每个系统得到相同的题目、相同的指令和限制、一个空白的 QGIS 工程,以及 3 次尝试。每个答案都由 Google 自己的评分代码打分。
- 我们让插件在 Low 强度(GPT-6 Luna,免费套餐)和 High 强度(规划更深入的另一个模型,Pro 套餐)下运行。Low 在两个基准测试上得分都更高,所以展示的每个得分都是 Low。
- Claude Sonnet 5.5 于 10 月 18 日在 Claude Code 中运行,使用 nkarasiak 的 QGIS MCP 插件,版本 0.15.1,并关闭了它自带的 shell、网页和文件工具。GPT-6 Luna + QGIS MCP 于 10 月 16 日和 17 日在 OpenAI 的 Codex CLI 中运行,使用 jjsantos01 的 qgis_mcp 服务器。GPT-6 Luna alone 不使用任何工具直接作答。
技术细节
基准测试:GeoKTools 和 GeoExpertQueries 来自 google-research/geospatial-reasoning-benchmarks,提交 c21a6d95,数据采用 CC BY 4.0。公开的开发集(85 道 GeoKTools 题和 25 道 GeoExpertQueries 题)按题目模板分成两半;保留的一半有 39 道 GeoKTools 题和 11 道 GeoExpertQueries 题。在拆分之前,我们核对过两个 GeoKTools 模板的参考答案,即某区域的极值点和某点周边的水资源压力;它们的 9 道题落在保留的一半中,被排除在所有得分之外,剩下 30 道 GeoKTools 题和 11 道 GeoExpertQueries 题。每个系统得到 Google 的提示词前缀,每题最多 100 次模型调用和 30 分钟,共 3 次完整运行;失败或超时的运行记 0 分。评分器未作修改:GeoKTools 确定性评分器(数字 10% 容差,部分得分,文本使用 ROUGE-L);GeoKTools 报告协议(完全匹配,否则由 Gemini 3.8 Flash 评判);GeoExpertQueries 与工具无关的自动评分器(Gemini 3.8 Flash,每个答案 3 次评判)。95% 区间是对题目做配对自助法(bootstrap)得到的。运行情况:AI Agent 在 Low 强度(GPT-6 Luna,高推理)和 High 强度下于 2026 年 10 月 20 日运行;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) in Claude Code 于 10 月 18 日运行;GPT-6 Luna + QGIS MCP (jjsantos01) in Codex(OpenAI),高推理,于 10 月 16 日和 17 日运行;GPT-6 Luna alone,高推理,于 10 月 19 日运行。我们检查了每次试验的工具调用,看是否读取过基准测试仓库、其题目文件或论文,命中即记 0 分:插件没有命中,GPT-6 Luna + QGIS MCP 的运行有 2 次命中。失败、被拒绝或超时的试验记 0 分,并保留在平均值中(GPT-6 Luna + QGIS MCP (jjsantos01) 为 150 次中的 7 次;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 为 150 次中的 3 次,是模型对一道 GeoExpertQueries 题目拒绝回答;AI Agent 在 Low 强度下的 150 次中没有)。
GeoBenchX:Solirinai/GeoBenchX,提交 0edf6109,MIT 许可,202 个任务,见 arXiv:2503.18129。我们排除了已发布审计所排除的 23 个任务、3 道对照题,以及 16 个参考解答无法复现或要求参考解答并未计算的数字的任务,剩下 160 个。AI Agent 于 2026 年 10 月 20 日在 QGIS 中以 Low 强度对每个任务分别运行两次,任务数据放在空白工程旁的文件夹里:65.0%(95% 区间 56.9 到 72.5)和 60.6%。第一次运行中,它解决了 92 个有答案的任务中的 46 个,拒绝了 62 个无法解决的任务中的 55 个,并通过了 6 个两种做法都可接受的任务中的 3 个。由代码对照回放的参考解答打分,不使用 AI 评判:比较的是地图显示的数值、要素数量、答案所陈述的数字,或者对无法解决的任务不出地图。
GS-QA2:Zoe/GS-QA2,修订版 0ccf9453,作者 Shang 等人(加州大学河滨分校),ODbL 1.0,© OpenStreetMap contributors;ASTER GDEM 是 METI 和 NASA 的产品。245 道题,49 个模板各 5 道,抽取规则与 Axis Spatial 的表格相同,但题目不同。三种设置,各运行 3 次:AI Agent 在 Low 强度下使用该基准的 OpenStreetMap 表格和 ASTER 高程,裁剪到题目所涉区域,放在空白工程旁的文件夹里,提示词只说明数据在哪里(61.1,95% 区间 57.1 到 65.2);AI Agent 在 Low 强度下从空白工程出发使用实时数据(22.0,19.0 到 25.2);GPT-6 Luna alone,单次调用、不使用工具(15.1,12.2 到 18.1)。最终答案要对照每一行参考数据,按论文的容差检查:名称按词重叠,位置在 5 米以内,方位、坡向和坡度在 5° 以内,海拔在 10 米以内,距离、面积和数量在 5% 以内。
这些结果没有说明什么?
- 我们自己的运行,使用公开题目。 Google 的测试题保持私有。这些得分来自公开题目,由我们用 Google 的代码运行并打分。
- 41 道题,而不是 50 道。 我们的发布文章引用的是 52.9,即插件在全部 50 道保留题上按报告协议得到的分数。其中包含来自我们研究过的模板的 9 道题,所以本页的每个得分都排除了它们。
- 样本很小。 GeoExpertQueries 只有 11 道保留题,每种 GeoKTools 题型有 3 到 5 道,所以一道题就会让这些得分大幅变动。应当引用的是全部 41 道题的比较结果。
- 只有我们测试过的智能体。 我们比较了三种配置:在 Claude Code 中通过 nkarasiak 的 QGIS MCP 服务器运行的 Claude Sonnet 5.5,在 OpenAI 的 Codex 中通过 jjsantos01 的 QGIS MCP 服务器运行的 GPT-6 Luna,以及单独运行的 GPT-6 Luna。其他模型、其他 MCP 服务器,以及论文中 Google 自己的智能体,都不在这次比较之内。
- GeoBenchX 和 GS-QA2 没有正面对比。 这些基准测试已发布的得分使用其他任务集和其他评分方式,所以我们不拿 AI Agent 与它们排名。
如何安装 AI Agent QGIS 插件?
AI Agent QGIS 插件可在 QGIS 官方插件仓库免费获取,适用于 QGIS 3.28 及更高版本,包括 QGIS 4。在 QGIS 中,打开 Plugins,然后选择 Manage and Install Plugins,搜索 AI Agent by TerraLab,安装并登录。无需 API 密钥,也无需银行卡。
免费套餐包含每月 5 个 Low 强度的任务,这正是上面所有得分所用的设置。Medium 和 High 强度包含在 Pro 中。完整指南会带您完成第一个任务,QGIS 中的 AI 智能体是什么则解释了这个概念。
常见问题
QGIS 最好的 AI 智能体是什么?
在我们于 Google 地理空间基准测试上测试过的所有 QGIS AI 智能体中,TerraLab 的 AI Agent QGIS 插件得分最高:在 Low 强度(GPT-6 Luna)下,对 41 道保留题得分 43.8(满分 100),而在 Claude Code 中使用 nkarasiak 的 QGIS MCP 服务器的 Claude Sonnet 5.5 得分 24.9,在 OpenAI 的 Codex 中使用 jjsantos01 的 QGIS MCP 服务器的 GPT-6 Luna 得分 22.1。它是 QGIS 官方插件仓库中的免费插件。
哪种 AI 最适合 GIS 分析?
在 QGIS 内做分析,AI Agent QGIS 插件在 Google 的 GeoKTools 和 GeoExpertQueries 基准测试中是我们测试过的智能体里得分最高的(Low 强度下 43.8,满分 100,对比在 Claude Code 中搭配 QGIS MCP 服务器的 Claude Sonnet 5.5 的 24.9)。我们没有测试其他 GIS 软件的工具,例如 Esri 面向 ArcGIS 的 GeoAI 工具。
ChatGPT 能在 QGIS 中工作吗?
ChatGPT 单独使用时只能凭记忆作答,无法操作 QGIS。在 OpenAI 的 Codex 中通过 jjsantos01 的 QGIS MCP 服务器连接后,GPT-6 Luna 在 GeoKTools 上得 39.5,在 GeoExpertQueries 上得 8.6,与同一模型不使用工具时的得分(44.2 和 0)相近。在 AI Agent QGIS 插件的 Low 强度下,同一个模型得分为 53.5 和 62.6。
Claude 能与 QGIS 配合使用吗?
可以,通过 QGIS MCP 服务器,例如 nkarasiak 的 QGIS MCP 插件。在我们的测试中,在 Claude Code 里使用该服务器(版本 0.15.1)的 Claude Sonnet 5.5 在 GeoKTools 上得 33.3,在 GeoExpertQueries 上得 29.3;Low 强度(GPT-6 Luna)的 AI Agent QGIS 插件得分为 53.5 和 62.6,并在 41 道题中的 26 道上得分更高。
什么是 QGIS MCP 服务器?
它是一座桥梁,让 Claude 或 ChatGPT 这类聊天模型通过模型上下文协议(Model Context Protocol)调用 QGIS 的函数。这样模型就能操作 QGIS,但需要自己找数据并检查工作。我们的 QGIS MCP 指南对各种服务器做了比较。
Google 的地理空间推理基准测试是什么?
即 GeoKTools 和 GeoExpertQueries,由 Google Research 于 2026 年 10 月随其 Google Earth AI 地理空间推理智能体的论文一同发布(arXiv:2610.15750)。GeoKTools 提出需要一到四类地理空间数据的事实性问题;GeoExpertQueries 提出开放的分析师问题,并对照专家编写的工作流程打分。
有比较 GIS 领域 AI 智能体的基准测试吗?
有,而且不止一个。Google 的 GeoKTools 和 GeoExpertQueries、GeoBenchX、GS-QA2、GISAgentBench 以及 GeoNatureAgent,都在地理空间任务上测试智能体,各有自己的题目和评分方式,所以不同基准测试之间的得分不能相互比较。
AI Agent 在其他地理空间基准测试中表现如何?
在 GeoBenchX 这一多步 GIS 任务的公开基准测试中,它在两次运行中通过了 160 个任务的 62.8%。在 GS-QA2 这一对照固定地图快照检查的美国地点空间问题基准上,使用基准自带的数据时得 61.1(满分 100)。没有其他智能体在相同条件下运行。
AI Agent QGIS 插件免费吗?
免费。免费套餐包含每月 5 个 Low 强度的任务,这正是这里所有基准得分所用的设置,无需 API 密钥,也无需银行卡。Medium 和 High 强度包含在 Pro 中。