AI Agent QGIS 外掛:最強大的 QGIS AI 代理
發布於
AI Agent by TerraLab 是一款免費的 QGIS 外掛,可在 QGIS 內回答地理空間問題。在 Google Research 於 2026 年 10 月發布的兩項地理空間基準測試 GeoKTools 與 GeoExpertQueries 上,它以 Low 強度(GPT-6 Luna)在 41 道保留題上拿下 43.8 分(滿分 100)。對照組方面,Claude Sonnet 5.5 在 Claude Code 中透過 nkarasiak 的 QGIS MCP 伺服器操作 QGIS,得 24.9 分;GPT-6 Luna 在 OpenAI 的 Codex 中透過 jjsantos01 的 QGIS MCP 伺服器操作,得 22.1 分;不使用任何工具的 GPT-6 Luna 單獨作答,得 21.0 分。這是我們在 QGIS 中測試的所有 AI 代理裡最高的分數,執行日期為 2026 年 10 月 16 日至 20 日,由 Google 自己的評分程式碼評分。
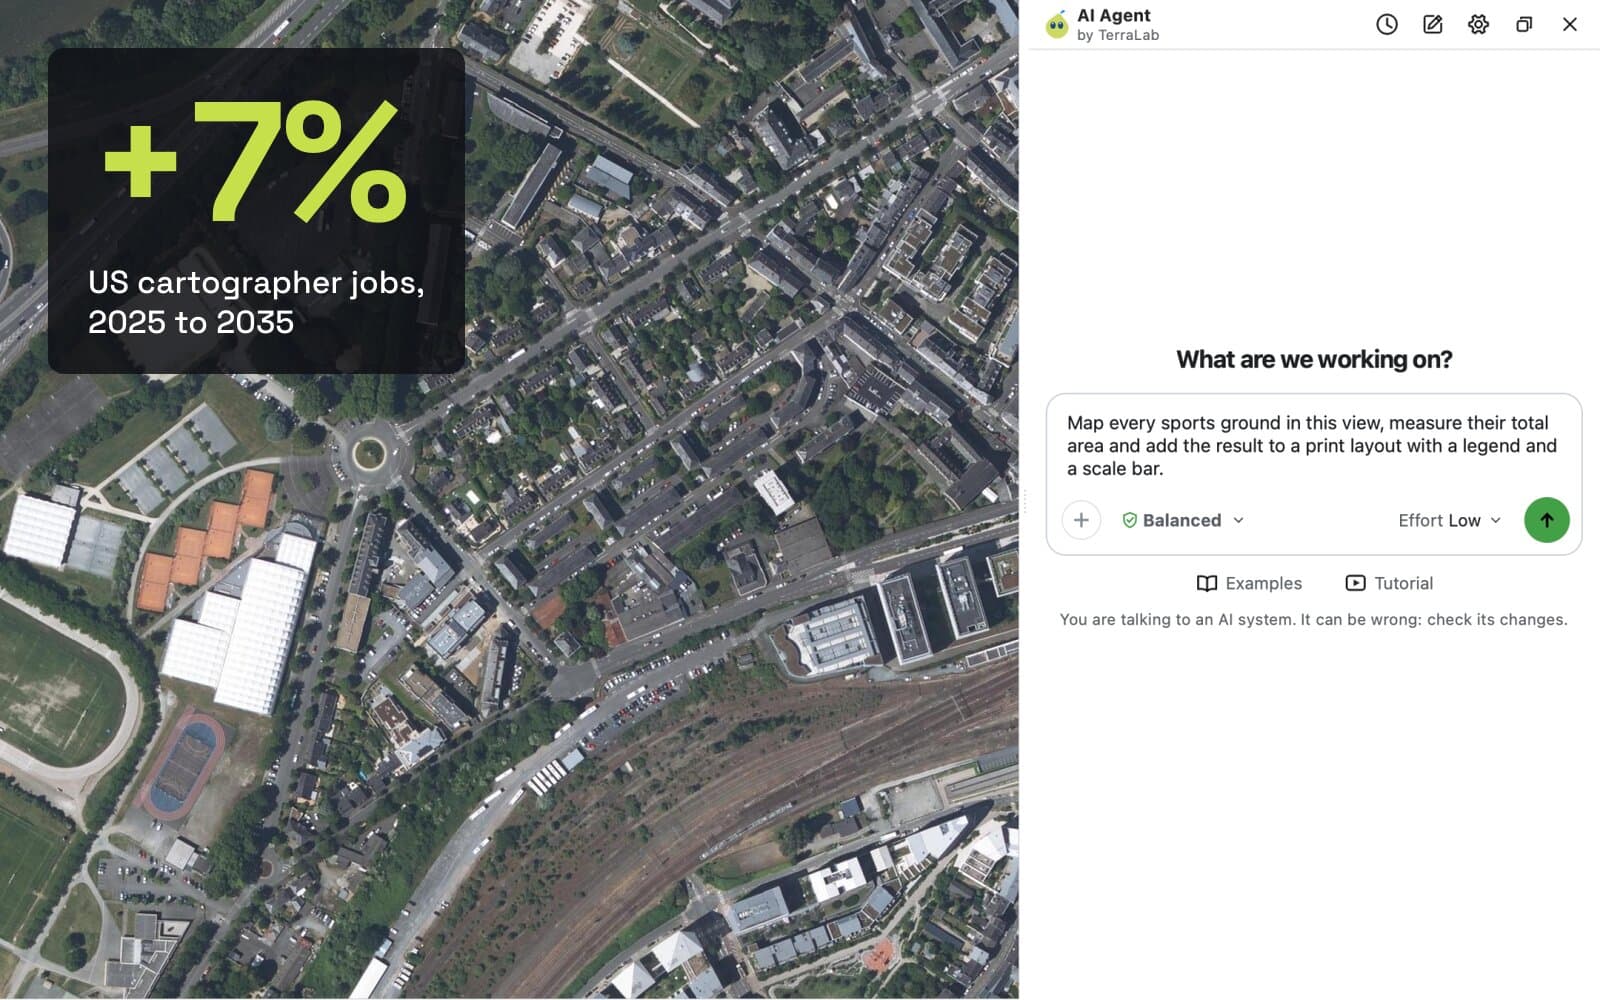
您用平實的語言提問,例如洪水風險、行車時間或水資源壓力。外掛會找出資料,用 QGIS 執行分析,並把結果以圖層加入您的專案,同時標明資料來源。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
GeoKTools 與 GeoExpertQueries 的準確率,從 0 到 100。這是 Google Research 為地理空間代理設計的基準測試(arXiv:2610.15750):41 道與我們的調校無關的保留題,由 Google 自己的評分程式碼評分,取 3 次執行的平均。外掛使用 Low 強度,也就是免費方案的設定。
AI Agent 在 Google 的地理空間基準測試上得了多少分?
| AI Agent QGIS 外掛(Low:GPT-6 Luna) | Claude Sonnet 5.5 + QGIS MCP(nkarasiak, Claude Code) | GPT-6 Luna + QGIS MCP(jjsantos01, Codex) | GPT-6 Luna alone(無工具) | |
|---|---|---|---|---|
GeoKTools 30 題 Google 的確定性離線評分器 確定性評分器 | 53.5Low 強度 | 33.3 | 39.5 | 44.2 |
GeoKTools 30 題 Google 的報告協定:完全吻合,否則由 Gemini 3.8 Flash 評審判定 Google 的報告協定 | 36.9Low 強度 | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 題 與工具無關的 autorater,Gemini 3.8 Flash,3 次評審執行 Autorater,3 次評審執行 | 62.6Low 強度 | 29.3 | 8.6 | 0.0 |
全部 41 題 41 題 兩項基準測試,Google 的報告協定 Google 的報告協定 | 43.8Low 強度 | 24.9 | 22.1 | 21.0 |
分數從 0 到 100,每個系統取 3 次執行的平均,所有評分器都是 Google 自己的,未經修改:確定性評分器、報告協定,以及 GeoExpertQueries 的 autorater。AI Agent 於 2026 年 10 月 20 日以 Low 強度(GPT-6 Luna)執行;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) in Claude Code 於 10 月 18 日執行;GPT-6 Luna + QGIS MCP (jjsantos01) in OpenAI's Codex 於 10 月 16 日與 17 日執行;GPT-6 Luna alone 於 10 月 19 日執行。粗體標示每列的最佳分數。
領先在逐題比較中依然成立。在 41 道題中,Low 強度的 AI Agent 有 26 題高於 Claude Sonnet 5.5 + QGIS MCP (nkarasiak),5 題低於;有 24 題高於 GPT-6 Luna + QGIS MCP (jjsantos01),7 題低於。它相對 Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 的平均領先為 19 分,95% 信賴區間為 10 到 29 分。
- 較高
- 平手
- 較低
每一題都拿 AI Agent at Low effort (GPT-6 Luna) 對上 Claude Code 中的 Claude Sonnet 5.5 + QGIS MCP (nkarasiak),兩者各取 3 次執行的平均。GeoKTools 採用 Google 的報告協定,GeoExpertQueries 採用 autorater。
GeoKTools 與 GeoExpertQueries 是什麼?
這是 Google Research 隨 Google Earth AI 地理空間推理代理的論文一同發布的兩項基準測試(arXiv:2610.15750,2026 年 10 月 11 日)。題目公開於 google-research/geospatial-reasoning-benchmarks 儲存庫,採用 CC BY 4.0 授權;Google 的正式測試題則不公開。
- GeoKTools 提出事實性問題,答案需要一到四種地理空間資料:行政邊界、統計數字、氣象紀錄、地點數量。Google 的確定性評分器會給部分分數,數字容許 10% 的誤差;它的報告協定則要求完全吻合,或由評審判定通過。
- GeoExpertQueries 提出分析師會遇到的開放式問題,涵蓋選址、自然災害與公共衛生等領域。Google 的 autorater 會依專家撰寫的工作流程為每個答案評分。
AI 代理在 QGIS 裡能做什麼?
它用 QGIS 內的真實資料回答關於地點的問題:找出資料集,執行行車時間、疊合或各區域統計等空間分析,並回傳附有資料來源的地圖。以下是三個範例,每一個都從空的 QGIS 專案開始、使用 Low 強度(免費方案的設定)拍攝。第一個出自 Google 的論文,另外兩個是我們以相同風格自行撰寫的,三個都不在計分的題目之中。
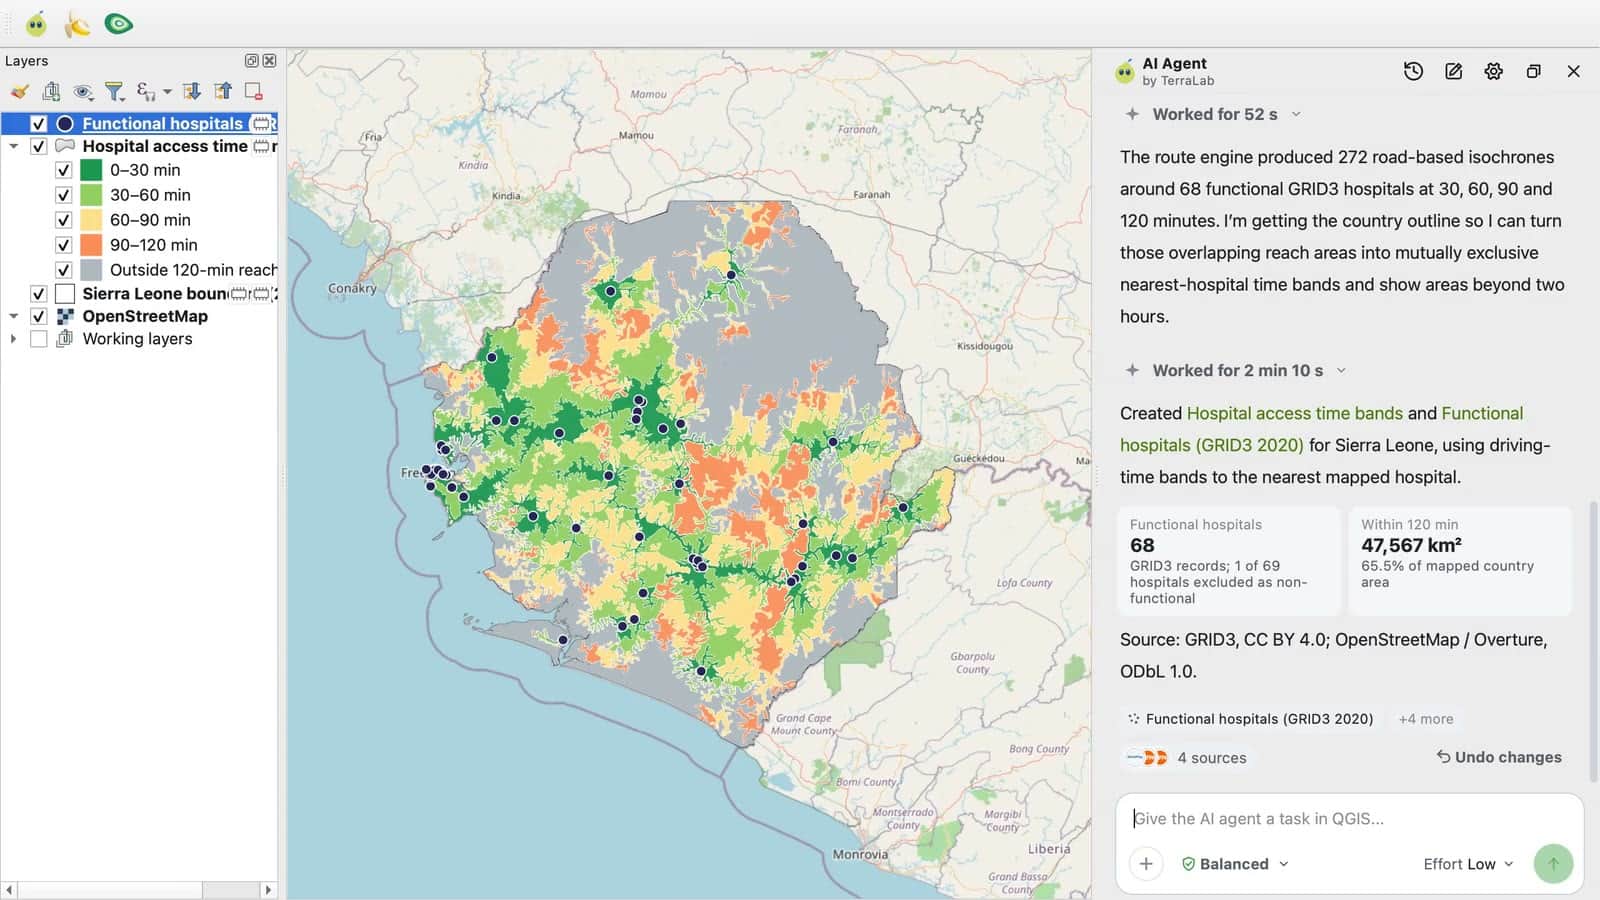
- 問題
- 請繪製獅子山境內任何地點的孕婦,前往最近醫院進行緊急生產所需的行車時間。使用行車時間,而不是直線距離。
- 答案
- 外掛先詢問人們如何移動,以及哪些設施應列入計算。以開車為準,並把每一間已繪製的醫院都當作可前往的設施,它依 30 分鐘為一級,繪出前往最近一間(共 68 間醫院)的時間:65.5% 的已繪製國土在兩小時內可達。約 5 分鐘。
- 難在哪裡
- 這需要整個國家的道路行車時間,而不是直線距離,還要決定哪些設施算數,這是任何模型都無法憑記憶做出的選擇。
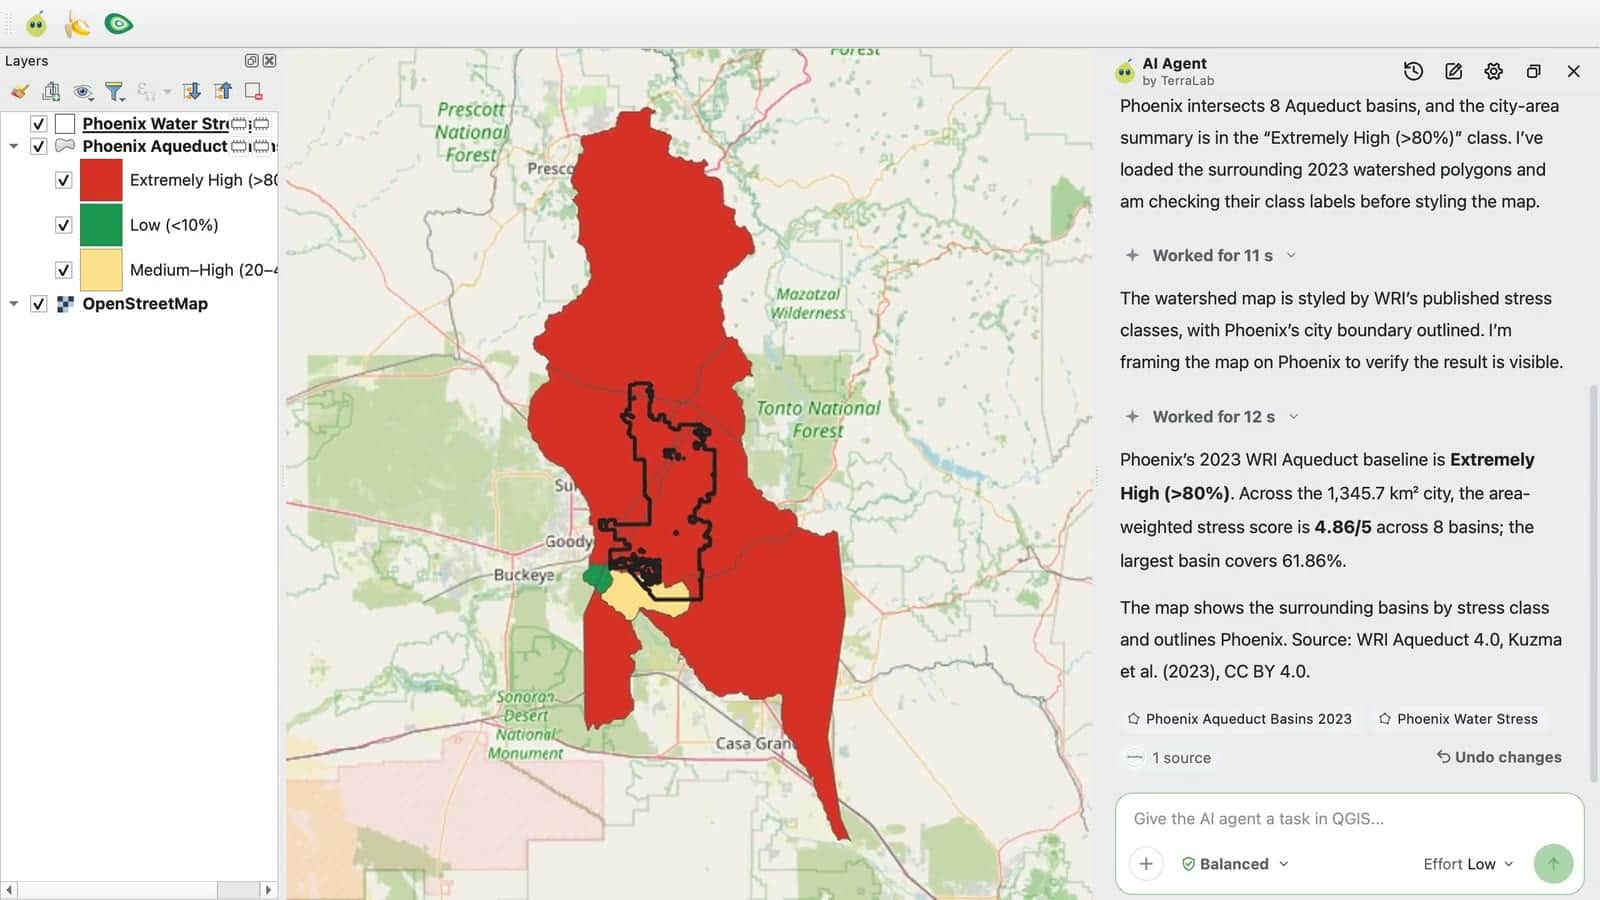
- 問題
- 亞利桑那州鳳凰城周邊的水資源壓力有多大?請給出該處的 WRI Aqueduct 基準水資源壓力,並顯示在地圖上。
- 答案
- 極高(Extremely High),超過 80%。穿過該市的 8 個 WRI Aqueduct 流域,面積加權後得 4.86 分(滿分 5),並標明資料來源與授權。約 1 分鐘。
- 難在哪裡
- 答案必須來自一個明確指名的資料集,並結合該市所跨越的每個流域,而不是模型對鳳凰城的記憶。
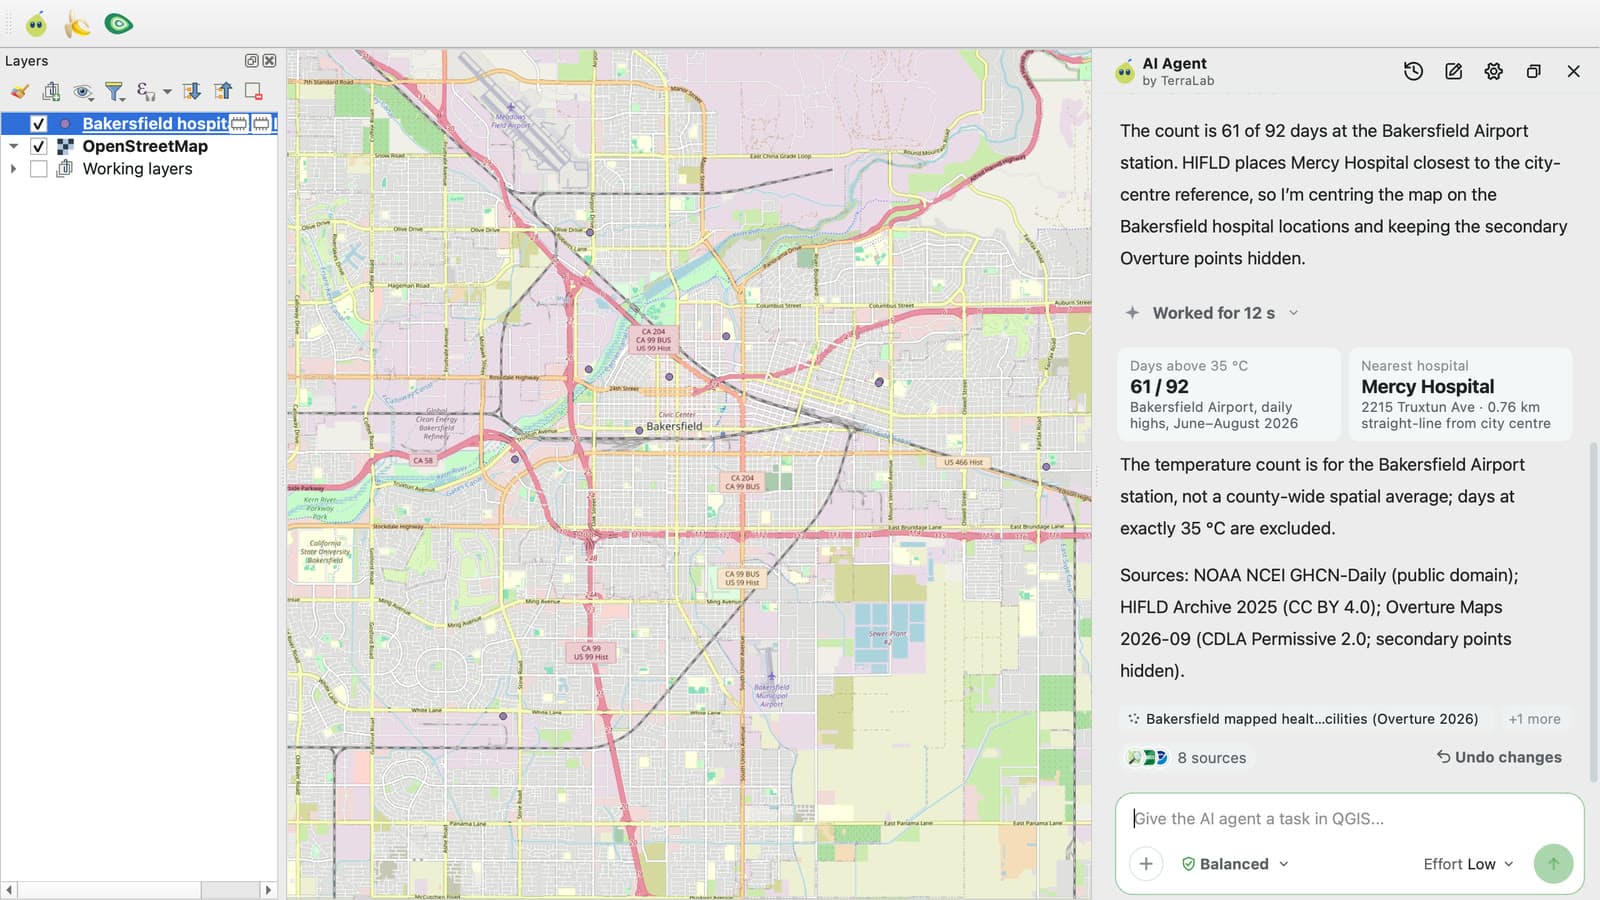
- 問題
- 加州克恩縣去年夏天(2026 年 6 月至 8 月)有多少天超過 35 °C?縣治貝克斯菲爾德最近的醫院是哪一間?
- 答案
- 貝克斯菲爾德機場測站在 92 天中有 61 天超過 35 °C,並註明這只是單一測站,不是全縣平均。最近的醫院是 Mercy Hospital,距市中心 0.76 公里。約 2 分鐘。
- 難在哪裡
- 它要結合三種來源:每日氣象紀錄、醫院名冊與地點地圖,而且是一個太新、無法憑記憶回答的夏天。
QGIS AI 外掛比搭配 QGIS MCP 伺服器的 Claude 或 ChatGPT 更好嗎?
在這些基準測試上,是的。QGIS MCP 伺服器透過 Model Context Protocol,把 Claude 或 ChatGPT 這類聊天模型連到 QGIS,讓模型可以呼叫 QGIS 的功能。模型因此能操作 QGIS,但仍然得自己找資料、決定每一步並檢查自己的成果。沒有連線的語言模型,則只能憑記憶回答。
AI Agent QGIS 外掛為模型提供地理空間工作所需的一切:為 GIS 打造的工具、獲准使用的授權資料,以及在回答前對每個結果的檢查。它直接在 QGIS 內運作,所以模型是用真正的 QGIS 工具在真實圖層上動作,您也可以在專案中打開每一個結果。
最清楚的對照是同一個模型的三種用法。GPT-6 Luna 單獨作答時,能憑記憶答對一些 GeoKTools 題目,GeoExpertQueries 的每個任務都得 0 分。在 OpenAI 的 Codex 中透過 jjsantos01 QGIS MCP 伺服器連到 QGIS 時,分數大致相同。放進 Low 強度的外掛內,同一個模型在 GeoKTools 得 53.5 分,在 GeoExpertQueries 得 62.6 分。
- GPT-6 Luna alone(無工具)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
GeoKTools 採用 Google 的確定性評分器,GeoExpertQueries 採用它的 autorater。GPT-6 Luna + QGIS MCP 使用的是 OpenAI 的 Codex 中的 jjsantos01 伺服器,於 10 月 16 日與 17 日執行,而不是 Claude Sonnet 5.5 所用的 nkarasiak 伺服器與 Claude Code。AI Agent 的 Low 強度執行的是 GPT-6 Luna。三種 GPT-6 Luna 設定都使用 high 推理。
在每一種難度下,外掛都領先。每道 GeoKTools 題目都需要好幾種資料。需要兩種時,它的得分遠高於其他所有系統。需要四種時,所有系統都吃力,外掛仍然領先。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
- GPT-6 Luna alone(無工具)
- AI Agent,即時資料(Low:GPT-6 Luna)
採用 Google 的報告協定,評分範圍是與我們的調校無關的 30 道 GeoKTools 保留題:20 題需要兩種資料類型,5 題需要三種,5 題需要四種。只需要一種的題目,全都來自我們在分割前研究過的範本,所以這一組不列入。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
Google 的確定性評分器。每種題型有 3 到 5 題,所以一題就會大幅改變分數。除了預測淹水面積(沒有任何系統答得出來)之外,AI Agent 在每種題型上都領先 Claude Sonnet 5.5 + QGIS MCP (nkarasiak)。在環狀範圍內的地點這一型,GPT-6 Luna + QGIS MCP (jjsantos01) 領先 1.3 分。我們在分割前研究過的兩種題型,也就是某點周邊的水資源壓力與區域的極端點,不列入。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
- Claude Sonnet 5.5 + QGIS MCP (nkarasiak, Claude Code)
- GPT-6 Luna + QGIS MCP (jjsantos01, Codex)
Google 與工具無關的 autorater。公共衛生只有 2 題,所以一題就會大幅改變分數;AI Agent 與 Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 在這裡同為 25.0 分,而 GPT-6 Luna 單獨作答在每個領域都是 0 分。
AI Agent 在其他 GIS 基準測試上表現如何?
我們也讓 AI Agent 跑了 Google 以外的兩項公開基準測試,AI Agent 沒有為任何一項做過調校。每個答案都由我們自己的程式碼對照各基準測試的參考答案評分。沒有其他代理在相同條件下執行,所以這裡沒有正面對決。
GeoBenchX:160 項任務通過 62.8%
GeoBenchX(arXiv:2503.18129)要求用開放資料完成多步驟的 GIS 工作:合併表格、處理圖層,並繪製國家、城市與區域地圖。有些任務要的東西資料根本給不出來,正確的做法是明說做不到。AI Agent 在兩次執行平均下,通過了 160 項任務中的 62.8%。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
由程式碼對照基準測試重播的參考解答評分,不使用 AI 評審。整體分數是兩次執行的平均,分別為 65.0% 與 60.6%;其他兩列取自第一次執行。GeoBenchX 自己的結果與 Axis Spatial 的表格都由 AI 評審評分,且任務組合不同,所以我們不把自己的分數與它們並排。
GS-QA2:245 道題得 61.1 分(滿分 100)
GS-QA2 由加州大學河濱分校的 Shang 等人製作,詢問關於美國各地點的空間問題:最近的地物、方向或距離、地面的坡度、坡向或高程。每個參考答案都來自固定的 OpenStreetMap 快照與高程模型。在相同資料下,AI Agent 得 61.1 分(滿分 100)。使用今天的即時資料則得 22.0 分,因為快照之後新增、改名或重新繪製的地點,已不再與參考答案吻合。GPT-6 Luna 單獨作答(也就是 AI Agent 在 Low 強度下所執行的模型)得 15.1 分。
- AI Agent QGIS 外掛(Low:GPT-6 Luna)
- AI Agent,即時資料(Low:GPT-6 Luna)
- GPT-6 Luna alone(無工具)
分數從 0 到 100,取該基準測試 49 個題目範本的平均,3 次執行。由程式碼依論文的容許誤差評分,不使用 AI 評審。Axis Spatial 在相同資料設定下公布了 GS-QA2 的分數,但題目抽樣不同,且使用私有的檢查程式,所以兩者不能直接比較。
其他針對 GIS 代理的公開基準測試還有 GISAgentBench 與 GeoNatureAgent。我們沒有讓 AI Agent 跑這兩項,所以本頁不報告它們的分數。
我們是怎麼測試的?
- Google Research 隨論文(arXiv:2610.15750)發布了 GeoKTools 與 GeoExpertQueries 及練習題;正式測試題則不公開。這是我們用公開題目自己跑的結果,不是 Google 的排行榜。
- 我們用公開題目的一半來改進代理,並在另外 50 題上量測,依題目範本分割。在分割之前,我們探索基準測試時,曾連同答案研究過兩個範本。50 題中有 9 題來自這兩個範本,所以我們不列入:這裡的每個分數都是在其餘 41 題上取得,也就是與我們的調校無關的保留題。
- 每個系統拿到相同的題目、相同的指示與限制、一個空的 QGIS 專案,以及 3 次嘗試。每個答案都由 Google 自己的評分程式碼評分。
- 我們讓外掛以 Low 強度(免費方案上的 GPT-6 Luna)和 High 強度(在 Pro 上,使用規劃更深入的另一個模型)執行。Low 在兩項基準測試上的分數都較高,所以顯示的每個分數都是 Low。
- Claude Sonnet 5.5 於 10 月 18 日在 Claude Code 中執行,使用 nkarasiak 的 QGIS MCP 外掛,版本 0.15.1,並關閉它自己的 shell、網路與檔案工具。GPT-6 Luna + QGIS MCP 於 10 月 16 日與 17 日在 OpenAI 的 Codex CLI 中執行,使用 jjsantos01 的 qgis_mcp 伺服器。GPT-6 Luna alone 則不使用任何工具作答。
技術細節
基準測試:GeoKTools 與 GeoExpertQueries 取自 google-research/geospatial-reasoning-benchmarks,commit c21a6d95,資料採用 CC BY 4.0。公開的 dev 切分(85 題 GeoKTools、25 題 GeoExpertQueries)依題目範本切成兩半;保留的那一半有 39 題 GeoKTools 與 11 題 GeoExpertQueries。分割之前,我們曾檢查過兩個 GeoKTools 範本的參考答案,即區域的極端點與某點周邊的水資源壓力;它們的 9 道題落在保留的那一半,不列入任何分數,因此剩下 30 題 GeoKTools 與 11 題 GeoExpertQueries。每個系統都拿到 Google 的提示詞前綴,每題最多 100 次模型呼叫與 30 分鐘,並完整執行 3 次;失敗或逾時的執行得 0 分。評分器皆未經修改:GeoKTools 確定性評分器(數字容許 10% 誤差、部分給分、文字採 ROUGE-L);GeoKTools 報告協定(完全吻合,否則由 Gemini 3.8 Flash 評審判定);GeoExpertQueries 與工具無關的 autorater(Gemini 3.8 Flash,每個答案 3 次評審執行)。95% 區間為依題目進行的配對 bootstrap。執行:AI Agent at Low effort (GPT-6 Luna, high reasoning) 與 High 強度於 2026 年 10 月 20 日;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) in Claude Code 於 10 月 18 日;GPT-6 Luna + QGIS MCP (jjsantos01) in OpenAI's Codex,high reasoning,於 10 月 16 日與 17 日;GPT-6 Luna alone,high reasoning,於 10 月 19 日。我們檢查了每次嘗試的工具呼叫,看是否讀取過基準測試儲存庫、題目檔案或論文,一旦命中就記 0 分:外掛沒有任何一次,GPT-6 Luna + QGIS MCP 的執行有 2 次。失敗、被拒絕或逾時的嘗試記 0 分,並保留在平均之中(GPT-6 Luna + QGIS MCP (jjsantos01) 為 150 次中的 7 次;Claude Sonnet 5.5 + QGIS MCP (nkarasiak) 為 150 次中的 3 次,是模型對某一道 GeoExpertQueries 題目的拒絕;AI Agent 在 Low 強度下的 150 次中為 0 次)。
GeoBenchX:Solirinai/GeoBenchX,commit 0edf6109,MIT 授權,202 項任務,論文為 arXiv:2503.18129。我們排除了已公開審查所剔除的 23 項任務、3 道對照題,以及 16 項參考解答無法重現或要求參考解答未計算之數字的任務,剩下 160 項。AI Agent 於 2026 年 10 月 20 日在 QGIS 中以 Low 強度分兩次獨立執行每項任務,任務資料放在空專案旁的資料夾:65.0%(95% 區間 56.9 到 72.5)與 60.6%。第一次執行中,它解出了 92 項有答案的任務中的 46 項,在 62 項無法解決的任務中拒絕了 55 項,並在 6 項兩種答法皆可的任務中通過 3 項。由程式碼對照重播的參考解答評分,不使用 AI 評審:地圖上顯示的數值、圖徵數量、答案所陳述的數字,或對於無法解決的任務則是完全不出圖。
GS-QA2:Zoe/GS-QA2,revision 0ccf9453,作者為 Shang 等人(加州大學河濱分校),ODbL 1.0,© OpenStreetMap contributors;ASTER GDEM 是 METI 與 NASA 的產品。245 道題,49 個範本各 5 題,抽樣規則與 Axis Spatial 的表格相同,但題目不同。三種設定,各執行 3 次:AI Agent 以 Low 強度,使用該基準測試的 OpenStreetMap 表格與 ASTER 高程(裁切到題目的範圍),放在空專案旁的資料夾,提示詞只說明資料在哪裡(61.1,95% 區間 57.1 到 65.2);AI Agent 以 Low 強度從空專案出發,使用即時資料(22.0,19.0 到 25.2);GPT-6 Luna alone,一次不使用工具的呼叫(15.1,12.2 到 18.1)。最終答案會依論文的容許誤差,對照每一列參考答案檢查:名稱以詞彙重疊比對,位置誤差在 5 公尺內,方位、坡向與坡度在 5° 內,高程在 10 公尺內,距離、面積與數量在 5% 內。
這些結果沒有顯示什麼?
- 我們的執行,使用公開題目。 Google 不公開它的測試題。這些分數來自公開題目,由我們用 Google 的程式碼執行並評分。
- 是 41 題,不是 50 題。 我們的發布貼文引用的是 52.9,也就是外掛在報告協定下於全部 50 道保留題上的分數。其中包含來自我們研究過之範本的 9 題,所以本頁的每個分數都不含這些題目。
- 樣本很小。 GeoExpertQueries 只有 11 道保留題,每種 GeoKTools 題型只有 3 到 5 題,所以一題就會大幅改變這些分數。應該引用的是全部 41 題的比較。
- 只有我們測試過的代理。 我們比較了三種設定:在 Claude Code 中透過 nkarasiak QGIS MCP 伺服器操作的 Claude Sonnet 5.5、在 OpenAI 的 Codex 中透過 jjsantos01 QGIS MCP 伺服器操作的 GPT-6 Luna,以及 GPT-6 Luna 單獨作答。其他模型、其他 MCP 伺服器,以及論文中 Google 自己的代理,都不在這次比較內。
- GeoBenchX 與 GS-QA2 沒有正面對決。 這兩項基準測試已公布的分數使用不同的任務組合與不同的評分器,所以我們不拿 AI Agent 與它們排名。
如何安裝 AI Agent QGIS 外掛?
AI Agent QGIS 外掛可在 QGIS 官方外掛儲存庫免費取得,支援 QGIS 3.28 及更新版本,包含 QGIS 4。在 QGIS 中,開啟 Plugins,再開啟 Manage and Install Plugins,搜尋 AI Agent by TerraLab,安裝後登入即可。不需要 API 金鑰,也不需要信用卡。
免費方案包含每月 5 項任務,使用 Low 強度,也就是上面每個分數所用的設定。Medium 與 High 強度屬於 Pro。完整指南會帶您走過第一項任務,QGIS 中的 AI 代理是什麼則說明這個概念。
常見問題
QGIS 最好的 AI 代理是哪一個?
在 Google 的地理空間基準測試中,我們在 QGIS 測試過的所有 AI 代理裡,TerraLab 的 AI Agent QGIS 外掛得分最高:以 Low 強度(GPT-6 Luna)在 41 道保留題上拿下 43.8 分(滿分 100),而在 Claude Code 中搭配 nkarasiak QGIS MCP 伺服器的 Claude Sonnet 5.5 為 24.9 分,在 OpenAI 的 Codex 中搭配 jjsantos01 QGIS MCP 伺服器的 GPT-6 Luna 為 22.1 分。它是 QGIS 官方外掛儲存庫上的免費外掛。
哪一種 AI 最適合 GIS 分析?
在 QGIS 內做分析,AI Agent QGIS 外掛是我們測試的代理中分數最高的(在 Google 的 GeoKTools 與 GeoExpertQueries 基準測試中,Low 強度得 43.8 分,滿分 100,而在 Claude Code 中搭配 QGIS MCP 伺服器的 Claude Sonnet 5.5 為 24.9 分)。我們沒有測試其他 GIS 軟體的工具,例如 Esri 用於 ArcGIS 的 GeoAI 工具。
ChatGPT 可以在 QGIS 中運作嗎?
ChatGPT 單獨使用時憑記憶回答,無法操作 QGIS。在 OpenAI 的 Codex 中透過 jjsantos01 QGIS MCP 伺服器連線時,GPT-6 Luna 在 GeoKTools 得 39.5 分,在 GeoExpertQueries 得 8.6 分,與同一個模型不使用工具時的分數(44.2 與 0)差不多。放進 Low 強度的 AI Agent QGIS 外掛內,同一個模型得 53.5 與 62.6 分。
Claude 可以搭配 QGIS 使用嗎?
可以,透過 QGIS MCP 伺服器,例如 nkarasiak 的 QGIS MCP 外掛。在我們的測試中,在 Claude Code 中搭配該伺服器(版本 0.15.1)的 Claude Sonnet 5.5,在 GeoKTools 得 33.3 分,在 GeoExpertQueries 得 29.3 分;Low 強度(GPT-6 Luna)的 AI Agent QGIS 外掛則得 53.5 與 62.6 分,並在 41 題中有 26 題得分更高。
QGIS MCP 伺服器是什麼?
這是一座橋,讓 Claude 或 ChatGPT 這類聊天模型透過 Model Context Protocol 呼叫 QGIS 的功能。模型因此能操作 QGIS,但得自己找資料並檢查成果。我們的 QGIS MCP 指南比較了各種伺服器。
Google 的地理空間推理基準測試是什麼?
GeoKTools 與 GeoExpertQueries,由 Google Research 於 2026 年 10 月隨 Google Earth AI 地理空間推理代理的論文一同發布(arXiv:2610.15750)。GeoKTools 提出需要一到四種地理空間資料的事實性問題;GeoExpertQueries 提出開放式的分析師問題,依專家撰寫的工作流程評分。
有比較 GIS 用 AI 代理的基準測試嗎?
有,而且不只一個。Google 的 GeoKTools 與 GeoExpertQueries、GeoBenchX、GS-QA2、GISAgentBench 與 GeoNatureAgent,都用地理空間任務測試代理,各有自己的題目與評分器,所以不同基準測試之間的分數不能互相比較。
AI Agent 在其他地理空間基準測試上表現如何?
在 GeoBenchX(多步驟 GIS 任務的公開基準測試)上,兩次執行通過了 160 項任務中的 62.8%。在 GS-QA2(針對美國地點、對照固定地圖快照檢查的空間問題)上,使用該基準測試自己的資料得 61.1 分(滿分 100)。沒有其他代理在相同條件下執行。
AI Agent QGIS 外掛是免費的嗎?
是的。免費方案包含每月 5 項任務,使用 Low 強度,也就是這裡每個基準測試分數所用的設定,不需要 API 金鑰,也不需要信用卡。Medium 與 High 強度屬於 Pro。