Plugin QGIS AI Agent : l'agent IA le plus performant pour QGIS
Publié le
AI Agent de TerraLab est un plugin QGIS gratuit qui répond à des questions géospatiales directement dans QGIS. Sur GeoKTools et GeoExpertQueries, les deux benchmarks géospatiaux publiés par Google Research en octobre 2026, il obtient 43,8 sur 100 sur 41 questions mises de côté, contre 24,9 pour Claude Sonnet 5.5 avec un serveur QGIS MCP, 22,1 pour GPT-6 Luna avec un serveur QGIS MCP et 21,0 pour GPT-6 Luna seul. C’est le meilleur score de tous les agents IA que nous avons testés dans QGIS, lors d’essais menés du 16 au 20 octobre 2026 et notés par le code de notation de Google lui-même.
Vous posez une question en termes simples, sur le risque d’inondation, les temps de trajet ou le stress hydrique. Le plugin trouve les données, lance l’analyse avec QGIS et ajoute le résultat à votre projet sous forme de couches, avec ses sources citées.
- Plugin AI Agent pour QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Précision de 0 à 100 sur GeoKTools et GeoExpertQueries, les benchmarks de Google Research pour les agents géospatiaux (arXiv:2610.15750) : les 41 questions mises de côté sans lien avec nos réglages, notées par le code de notation de Google lui-même, moyenne de 3 essais. Le plugin en effort Low, le réglage du plan gratuit.
Quel score AI Agent a-t-il obtenu sur les benchmarks géospatiaux de Google ?
| Plugin AI Agent pour QGIS | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna seul | |
|---|---|---|---|---|
GeoKTools 30 questions Scoreur hors ligne déterministe de Google Scoreur déterministe | 53.5Effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 questions Protocole du rapport de Google : correspondance exacte, sinon juge Gemini 3.8 Flash Protocole du rapport de Google | 36.9Effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 questions Autorater indépendant des outils, Gemini 3.8 Flash, 3 passages de juge Autorater, 3 passages de juge | 62.6Effort Low | 29.3 | 8.6 | 0.0 |
Les 41 questions 41 questions Les deux benchmarks, protocole du rapport de Google Protocole du rapport de Google | 43.8Effort Low | 24.9 | 22.1 | 21.0 |
Scores de 0 à 100, moyenne de 3 essais par système, chaque scoreur étant celui de Google, sans modification : le scoreur déterministe, le protocole du rapport et l’autorater de GeoExpertQueries. AI Agent a tourné en effort Low le 20 octobre 2026, Claude Sonnet 5.5 avec un serveur QGIS MCP le 18 octobre, GPT-6 Luna avec un serveur QGIS MCP les 16 et 17 octobre, et GPT-6 Luna seul le 19 octobre. Le gras marque le meilleur score de chaque ligne.
L’avance tient question par question. Sur les 41 questions, AI Agent obtient un meilleur score que Claude Sonnet 5.5 avec un serveur QGIS MCP sur 26 et un moins bon sur 5, et un meilleur score que GPT-6 Luna avec un serveur QGIS MCP sur 24 et un moins bon sur 7. Son avance moyenne sur Claude est de 19 points, entre 10 et 29 avec un intervalle de confiance à 95 %.
- Plus haut
- Égalité
- Plus bas
Pour chaque question, la moyenne du plugin sur 3 essais comparée à celle de Claude. Tout en effort Low.
Que sont GeoKTools et GeoExpertQueries ?
Ce sont les deux benchmarks publiés par Google Research avec son article sur le Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 octobre 2026). Les questions sont publiques dans le dépôt google-research/geospatial-reasoning-benchmarks, sous licence CC BY 4.0 ; Google garde ses questions de test officielles privées.
- GeoKTools pose des questions factuelles dont les réponses demandent un à quatre types de données géospatiales : une limite administrative, une statistique, un relevé météo, un nombre de lieux. Le scoreur déterministe de Google accorde un crédit partiel avec une tolérance de 10 % sur les nombres ; son protocole du rapport exige une correspondance exacte ou l’accord d’un juge.
- GeoExpertQueries pose des problèmes ouverts comme ceux d’un analyste, dans des domaines tels que le choix de sites, les risques naturels et la santé publique. L’autorater de Google note chaque réponse par rapport à des workflows rédigés par des experts.
Que peut faire un agent IA dans QGIS ?
Il répond à des questions sur des lieux en travaillant sur de vraies données dans QGIS : il trouve des jeux de données, lance des analyses spatiales comme des temps de trajet, des superpositions ou des statistiques par zone, et renvoie une carte avec ses sources. Trois exemples, chacun filmé à partir d’un projet QGIS vide en effort Low, le réglage du plan gratuit. Le premier vient de l’article de Google. Nous avons écrit les deux autres dans le même style, et aucun ne figure parmi les questions notées.
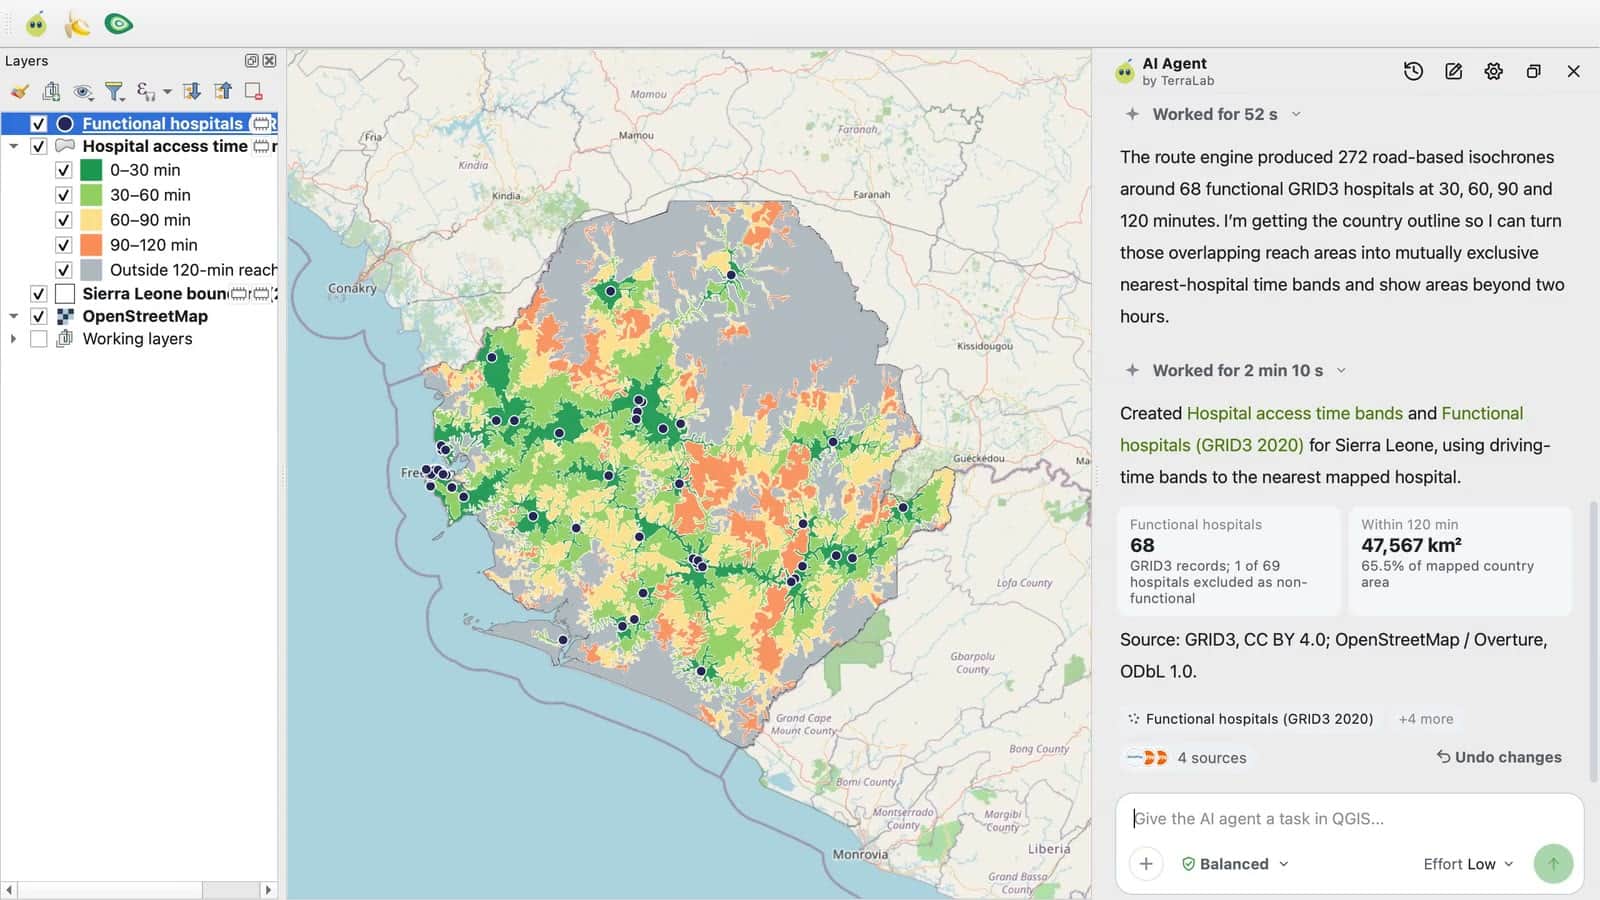
- Question
- Cartographiez le temps de trajet d’une femme enceinte jusqu’à l’hôpital le plus proche pour un accouchement d’urgence, depuis n’importe quel point de la Sierra Leone. Utilisez le temps de trajet, pas la distance à vol d’oiseau.
- Réponse
- Le plugin a d’abord demandé comment les gens se déplacent et quels établissements doivent compter. En voiture, en retenant tous les hôpitaux cartographiés, il a cartographié le temps jusqu’au plus proche des 68 hôpitaux par tranches de 30 minutes : 65,5 % du pays cartographié se trouve à moins de deux heures. Environ 5 minutes.
- Pourquoi c'est difficile
- Il faut un temps de trajet routier sur tout un pays, pas une distance à vol d’oiseau, et un choix sur les établissements à compter qu’aucun modèle ne peut faire de mémoire.
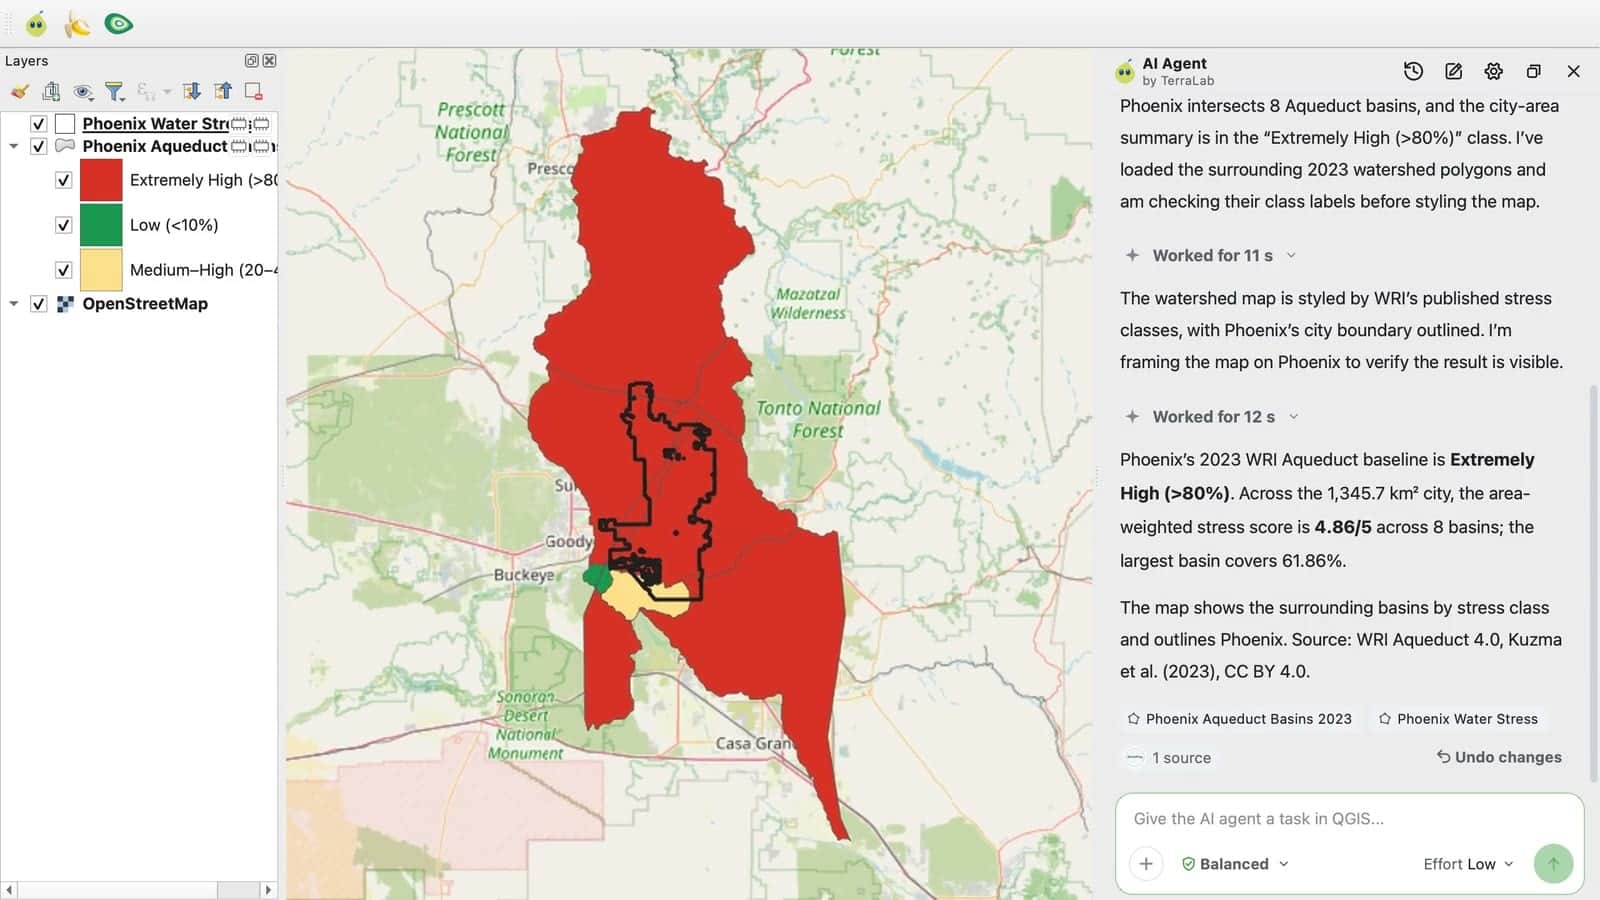
- Question
- Quel est le niveau de stress hydrique autour de Phoenix, en Arizona ? Donnez le stress hydrique de référence de WRI Aqueduct à cet endroit et montrez-le sur la carte.
- Réponse
- Extrêmement élevé, au-dessus de 80 %. Les 8 bassins WRI Aqueduct qui traversent la ville donnent un score pondéré par la surface de 4,86 sur 5, avec la source et sa licence citées. Environ une minute.
- Pourquoi c'est difficile
- La réponse doit venir d’un seul jeu de données nommé, combiné sur tous les bassins que recouvre la ville, et non de ce qu’un modèle retient de Phoenix.
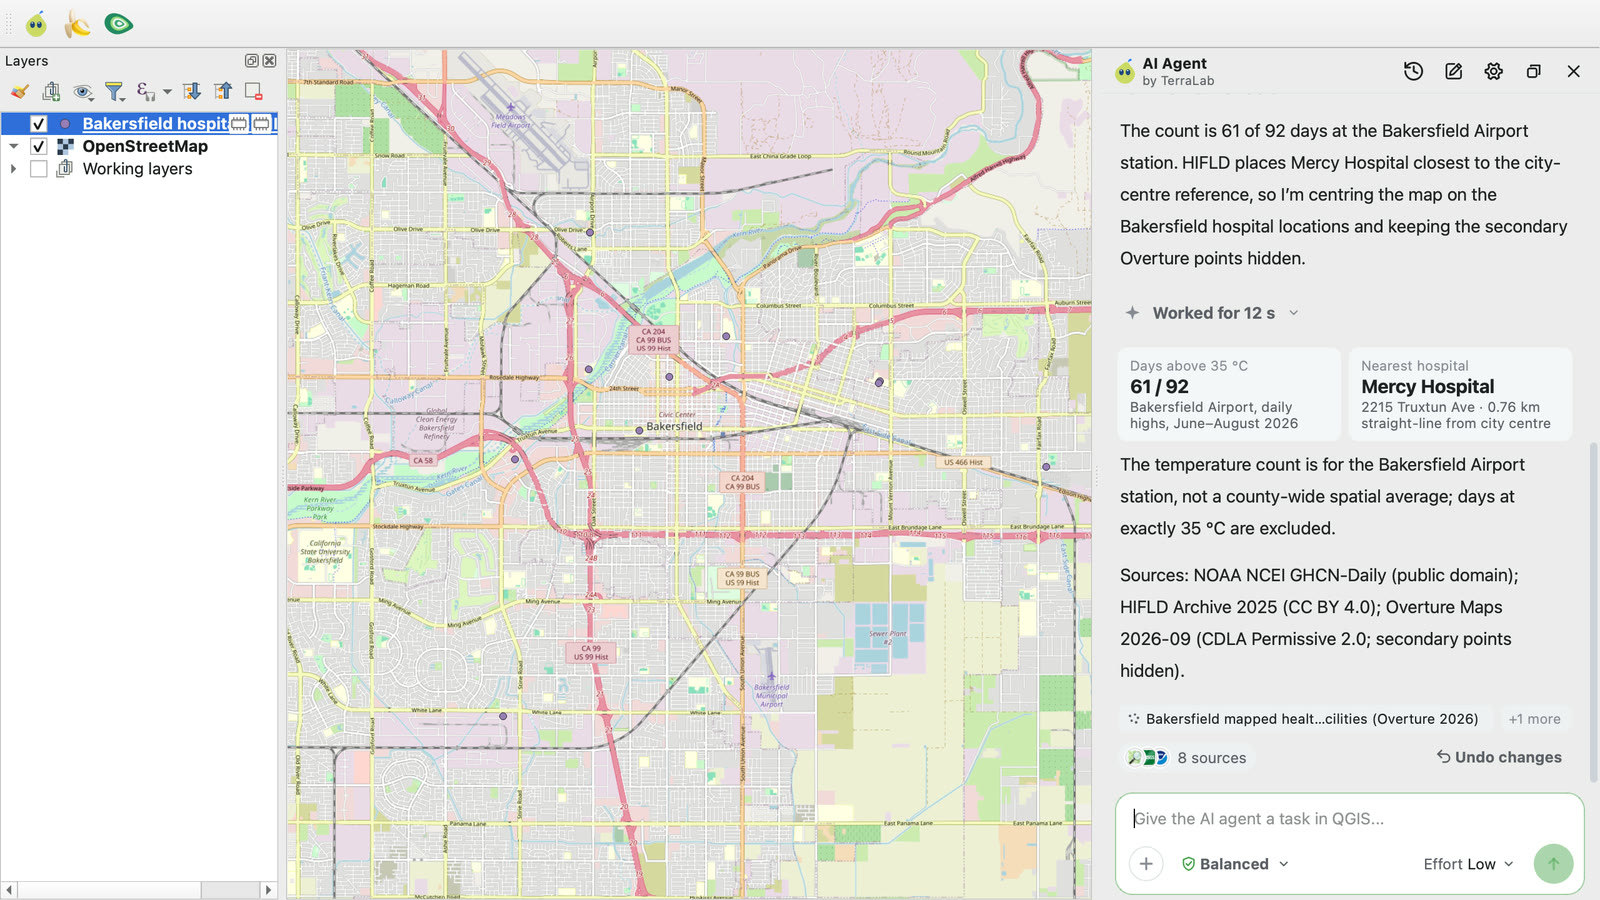
- Question
- Combien de jours ont dépassé 35 °C dans le comté de Kern, en Californie, l’été dernier (de juin à août 2026) ? Et quel est l’hôpital le plus proche de Bakersfield, le chef-lieu du comté ?
- Réponse
- 61 jours sur 92 au-dessus de 35 °C à la station de l’aéroport de Bakersfield, avec la précision qu’il s’agit d’une seule station, pas d’une moyenne du comté. L’hôpital le plus proche est le Mercy Hospital, à 0,76 km du centre-ville. Environ 2 minutes.
- Pourquoi c'est difficile
- Il croise trois sources, des relevés météo quotidiens, un registre d’hôpitaux et une carte de lieux, pour un été trop récent pour répondre de mémoire.
Un plugin d’IA pour QGIS est-il meilleur que Claude ou ChatGPT avec un serveur QGIS MCP ?
Sur ces benchmarks, oui. Un serveur QGIS MCP relie un modèle de chat comme Claude ou ChatGPT à QGIS grâce au Model Context Protocol, si bien que le modèle peut appeler des fonctions de QGIS. Le modèle peut alors piloter QGIS, mais il doit encore trouver les données, choisir chaque étape et vérifier son propre travail. Un modèle de langage sans connexion répond de mémoire.
Le plugin QGIS AI Agent donne au modèle ce dont il a besoin pour le travail géospatial : des outils conçus pour le SIG, des données sous licence qu’il a le droit d’utiliser, et une vérification de chaque résultat avant de répondre. Il fonctionne directement dans QGIS, si bien que le modèle agit sur de vraies couches avec de vrais outils QGIS, et vous pouvez ouvrir chaque résultat dans votre projet.
La comparaison la plus claire est un seul modèle, de trois façons. Seul, GPT-6 Luna se souvient de certaines réponses de GeoKTools et obtient 0 à toutes les tâches de GeoExpertQueries. Connecté à QGIS par un serveur MCP générique, il obtient à peu près la même chose. Dans le plugin en effort Low, le même modèle obtient 53,5 sur GeoKTools et 62,6 sur GeoExpertQueries.
- GPT-6 Luna seul
- GPT-6 Luna + QGIS MCP
- Plugin AI Agent pour QGIS
GeoKTools avec le scoreur déterministe de Google, GeoExpertQueries avec son autorater. L’essai QGIS MCP a utilisé un autre serveur et un autre client que l’essai Claude (voir « Comment avons-nous testé ? »). L’effort Low du plugin fait tourner GPT-6 Luna.
Le plugin est en tête à tous les niveaux de difficulté. Chaque question de GeoKTools demande plusieurs types de données. Avec deux types, il obtient un score nettement supérieur à tous les autres systèmes. Avec quatre, tous les systèmes peinent, et le plugin reste devant.
- Plugin AI Agent pour QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna seul
- AI Agent, données en direct
Notées avec le protocole du rapport de Google, sur les 30 questions GeoKTools mises de côté sans lien avec nos réglages : 20 demandent deux types de données, 5 en demandent trois et 5 en demandent quatre. Chaque question demandant un seul type venait d’un modèle de question que nous avions étudié avant la séparation, ce groupe est donc exclu.
- Plugin AI Agent pour QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Scoreur déterministe de Google. Chaque type compte de 3 à 5 questions, donc une seule question fait beaucoup bouger son score. Le plugin devance Claude sur tous les types sauf la prévision de surface inondée, à laquelle aucun système ne répond. GPT-6 Luna avec un QGIS MCP a un point d’avance sur les lieux dans un anneau. Les deux types étudiés avant la séparation, le stress hydrique autour d’un point et le point extrême d’une zone, sont exclus.
- Plugin AI Agent pour QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Autorater de Google, indépendant des outils. La santé publique ne compte que 2 questions, donc une seule fait beaucoup bouger son score ; le plugin et Claude sont à égalité, et GPT-6 Luna seul a obtenu 0 dans tous les domaines.
Comment AI Agent se comporte-t-il sur d’autres benchmarks SIG ?
Nous avons aussi lancé AI Agent sur deux benchmarks publics extérieurs à Google, sans rien régler dans AI Agent pour l’un ou l’autre. Notre propre code a noté chaque réponse par rapport aux réponses de référence de chaque benchmark. Aucun autre agent n’a tourné dans les mêmes conditions, il n’y a donc pas de comparaison directe ici.
GeoBenchX : 62,8 % de 160 tâches
GeoBenchX (arXiv:2503.18129) demande un travail SIG en plusieurs étapes sur des données ouvertes : fusionner des tables, traiter des couches et cartographier des pays, des villes et des régions. Certaines tâches demandent quelque chose que les données ne peuvent pas fournir, et la bonne réponse est de le dire. AI Agent a réussi 62,8 % des 160 tâches en moyenne sur deux essais.
- Plugin AI Agent pour QGIS
Noté par du code par rapport aux solutions de référence rejouées du benchmark, sans juge IA. Le score global est la moyenne de deux essais, 65,0 % et 60,6 % ; les deux autres lignes viennent du premier essai. Les résultats propres de GeoBenchX et le tableau d’Axis Spatial sont notés par un juge IA sur un autre ensemble de tâches, nous ne plaçons donc pas notre score à côté des leurs.
GS-QA2 : 61,1 sur 100 sur 245 questions
GS-QA2, par Shang et al. à UC Riverside, pose des questions spatiales sur des lieux des États-Unis : l’élément le plus proche, une direction ou une distance, la pente, l’exposition ou l’altitude du terrain. Chaque réponse de référence vient d’un instantané figé d’OpenStreetMap et d’un modèle d’élévation. Avec ces mêmes données, AI Agent obtient 61,1 sur 100. Sur les données en direct d’aujourd’hui, il obtient 22,0, car les lieux ajoutés, renommés ou redessinés depuis l’instantané ne correspondent plus à la référence. GPT-6 Luna seul, le modèle qu’AI Agent fait tourner en effort Low, obtient 15,1.
- Plugin AI Agent pour QGIS
- AI Agent, données en direct
- GPT-6 Luna seul
Score de 0 à 100, moyenne sur les 49 modèles de questions du benchmark, 3 essais. Noté par du code avec les tolérances de l’article, sans juge IA. Axis Spatial publie des scores GS-QA2 avec les mêmes données, mais sur un autre tirage de questions et avec un vérificateur privé, ils ne sont donc pas comparables.
D’autres benchmarks publics existent pour les agents SIG, dont GISAgentBench et GeoNatureAgent. Nous n’avons pas lancé AI Agent dessus, cette page ne rapporte donc aucun score pour eux.
Comment avons-nous testé ?
- Google Research a publié GeoKTools et GeoExpertQueries avec son article (arXiv:2610.15750), ainsi que des questions d’entraînement ; il garde ses questions de test officielles privées. Ce sont nos propres essais sur les questions publiques, pas un classement de Google.
- Nous avons amélioré l’agent sur la moitié des questions publiques et l’avons mesuré sur les 50 autres, réparties par modèle de question. Avant cette séparation, en explorant le benchmark, nous avions étudié deux modèles de questions avec leurs réponses. Neuf des 50 questions en viennent, nous les avons donc écartées : tous les scores ici portent sur les 41 autres, les questions mises de côté sans lien avec nos réglages.
- Chaque système a reçu les mêmes questions, les mêmes consignes et limites, un projet QGIS vide et 3 essais. Le code de notation de Google a noté chaque réponse.
- Nous avons lancé le plugin en effort Low (GPT-6 Luna, sur le plan gratuit) et en effort High (un autre modèle qui planifie plus en profondeur, sur Pro). Low a obtenu un meilleur score sur les deux benchmarks, donc tous les scores affichés sont en Low.
- Claude Sonnet 5.5 a tourné dans Claude Code avec le plugin QGIS MCP de nkarasiak, version 0.15.1, ses propres outils shell, web et fichiers désactivés, le 18 octobre. GPT-6 Luna + QGIS MCP a tourné dans le Codex CLI d’OpenAI avec le serveur qgis_mcp de jjsantos01, les 16 et 17 octobre. GPT-6 Luna seul a répondu sans outils.
Détails techniques
Benchmarks : GeoKTools et GeoExpertQueries issus de google-research/geospatial-reasoning-benchmarks, commit c21a6d95, données sous CC BY 4.0. Le jeu de développement public (85 questions GeoKTools, 25 GeoExpertQueries) a été coupé en deux par modèle de question ; la moitié mise de côté compte 39 questions GeoKTools et 11 GeoExpertQueries. Avant la séparation, nous avions vérifié les réponses de référence de deux modèles GeoKTools, le point extrême d’une zone et le stress hydrique autour d’un point ; leurs 9 questions sont tombées dans la moitié mise de côté et sont exclues de tous les scores, ce qui laisse 30 questions GeoKTools et 11 GeoExpertQueries. Chaque système a reçu le préfixe de prompt de Google, au plus 100 appels de modèle et 30 minutes par question, et 3 essais complets ; un essai échoué ou expiré obtient 0. Scoreurs, inchangés : scoreur déterministe GeoKTools (tolérance de 10 % sur les nombres, crédit partiel, ROUGE-L sur le texte) ; protocole du rapport GeoKTools (correspondance exacte, sinon un juge Gemini 3.8 Flash) ; autorater GeoExpertQueries indépendant des outils (Gemini 3.8 Flash, 3 passages de juge par réponse). L’intervalle à 95 % est un bootstrap apparié sur les questions. Essais : le plugin en effort Low et High le 20 octobre 2026 ; Claude + QGIS MCP le 18 octobre ; GPT-6 Luna seul le 19 octobre. Les appels d’outils de chaque essai ont été vérifiés pour repérer toute lecture du dépôt du benchmark, de son fichier de questions ou de l’article, et une détection donne 0 : le plugin n’en a eu aucune, les essais GPT-6 Luna + QGIS MCP en ont eu 2. Les essais échoués, refusés ou expirés obtiennent 0 et restent dans les moyennes (7 sur 150 pour GPT-6 Luna + QGIS MCP, aucun des 150 du plugin en Low).
GeoBenchX : Solirinai/GeoBenchX au commit 0edf6109, licence MIT, 202 tâches, décrit dans arXiv:2503.18129. Nous avons écarté 23 tâches exclues par un audit publié, 3 questions de contrôle et 16 dont la solution de référence ne se reproduit pas ou demande un chiffre que la référence ne calcule pas, ce qui laisse 160. AI Agent a lancé chaque tâche en deux essais séparés en effort Low le 20 octobre 2026, dans QGIS, avec les données de la tâche dans un dossier à côté d’un projet vide : 65,0 % (intervalle à 95 % de 56,9 à 72,5) et 60,6 %. Au premier essai, il a résolu 46 des 92 tâches qui ont une réponse, refusé 55 des 62 qui ne peuvent pas être résolues et réussi 3 des 6 qui acceptent l’un ou l’autre. Noté par du code, sans juge IA, par rapport à la solution de référence rejouée : les valeurs que la carte affiche, le nombre d’entités, le nombre que la réponse énonce, ou aucune carte pour les tâches qui ne peuvent pas être résolues.
GS-QA2 : Zoe/GS-QA2 à la révision 0ccf9453, par Shang et al. (UC Riverside), ODbL 1.0, © contributeurs d’OpenStreetMap ; ASTER GDEM est un produit du METI et de la NASA. 245 questions, 5 pour chacun des 49 modèles de questions, tirées avec la même règle que le tableau d’Axis Spatial mais pas les mêmes questions. Trois configurations, 3 essais chacune : AI Agent en effort Low avec les tables OpenStreetMap et l’altitude ASTER du benchmark, découpées sur les zones des questions, dans un dossier à côté d’un projet vide, le prompt indiquant seulement où se trouvent les données (61,1, intervalle à 95 % de 57,1 à 65,2) ; AI Agent en effort Low depuis un projet vide sur les données en direct (22,0, de 19,0 à 25,2) ; GPT-6 Luna seul, un appel sans outils (15,1, de 12,2 à 18,1). La réponse finale est comparée à chaque ligne de référence avec les tolérances de l’article : noms par recouvrement de tokens, positions à 5 m, cap, exposition et pente à 5°, altitude à 10 m, distances, surfaces et comptages à 5 %.
Que ne montrent pas ces résultats ?
- Nos essais, sur des questions publiques. Google garde ses questions de test privées. Ces scores viennent des questions publiques, lancées et notées par nous avec le code de Google.
- 41 questions, pas 50. Nos articles d’annonce citent 52,9, le score du plugin avec le protocole du rapport sur les 50 questions mises de côté. Ce score inclut les 9 questions issues de modèles que nous avions étudiés, donc tous les scores de cette page les écartent.
- Petits échantillons. GeoExpertQueries compte 11 questions mises de côté, et chaque type de question de GeoKTools en compte de 3 à 5, donc une seule question fait beaucoup bouger ces scores. C’est la comparaison sur les 41 questions qu’il faut citer.
- Seulement les agents que nous avons testés. Nous avons comparé trois configurations : Claude Sonnet 5.5 et GPT-6 Luna, chacun via un serveur QGIS MCP de la communauté, et GPT-6 Luna seul. Les autres modèles, les autres serveurs MCP et l’agent propre de Google décrit dans l’article ne font pas partie de cette comparaison.
- Pas de comparaison directe sur GeoBenchX ou GS-QA2. Les scores publiés sur ces benchmarks utilisent d’autres ensembles de tâches et d’autres notateurs, nous ne classons donc pas AI Agent par rapport à eux.
Comment installer le plugin QGIS AI Agent ?
Le plugin QGIS AI Agent est gratuit sur le dépôt officiel des plugins QGIS, pour QGIS 3.28 et versions ultérieures, QGIS 4 compris. Dans QGIS, ouvrez Plugins, puis Manage and Install Plugins, cherchez AI Agent by TerraLab, installez-le et connectez-vous. Il ne faut aucune clé API ni carte bancaire.
Le plan gratuit comprend 5 tâches par mois en effort Low, le réglage derrière tous les scores ci-dessus. Les efforts Medium et High viennent avec Pro. Le guide complet présente une première tâche, et ce qu’est un agent IA dans QGIS explique l’idée.
FAQ
Quel est le meilleur agent IA pour QGIS ?
Parmi tous les agents IA que nous avons testés dans QGIS sur les benchmarks géospatiaux de Google, le plugin QGIS AI Agent de TerraLab a obtenu le meilleur score : 43,8 sur 100 sur 41 questions mises de côté, contre 24,9 pour Claude Sonnet 5.5 avec un serveur QGIS MCP et 22,1 pour GPT-6 Luna avec un serveur QGIS MCP. C’est un plugin gratuit sur le dépôt officiel des plugins QGIS.
Quelle IA est la meilleure pour l’analyse SIG ?
Pour l’analyse dans QGIS, le plugin QGIS AI Agent a obtenu le meilleur score des agents que nous avons testés sur les benchmarks GeoKTools et GeoExpertQueries de Google. Nous n’avons pas testé les outils pour d’autres logiciels SIG, comme les outils GeoAI d’Esri pour ArcGIS.
ChatGPT peut-il fonctionner dans QGIS ?
ChatGPT seul répond de mémoire et ne peut pas piloter QGIS. Connecté par un serveur QGIS MCP dans Codex d’OpenAI, GPT-6 Luna a obtenu 39,5 sur GeoKTools et 8,6 sur GeoExpertQueries, à peu près ce que le même modèle obtient sans outils. Dans le plugin QGIS AI Agent, le même modèle a obtenu 53,5 et 62,6.
Claude peut-il fonctionner avec QGIS ?
Oui, grâce à un serveur QGIS MCP comme le plugin QGIS MCP de nkarasiak. Dans notre test, Claude Sonnet 5.5 avec ce serveur a obtenu 33,3 sur GeoKTools et 29,3 sur GeoExpertQueries ; le plugin QGIS AI Agent a obtenu 53,5 et 62,6, et un meilleur score sur 26 des 41 questions.
Qu’est-ce qu’un serveur QGIS MCP ?
Un pont qui permet à un modèle de chat comme Claude ou ChatGPT d’appeler des fonctions de QGIS grâce au Model Context Protocol. Le modèle peut alors piloter QGIS, mais il doit trouver les données et vérifier son travail seul. Notre guide de QGIS MCP compare les serveurs.
Que sont les benchmarks de raisonnement géospatial de Google ?
GeoKTools et GeoExpertQueries, publiés par Google Research en octobre 2026 avec son article sur le Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). GeoKTools pose des questions factuelles qui demandent un à quatre types de données géospatiales ; GeoExpertQueries pose des problèmes ouverts d’analyste, notés par rapport à des workflows rédigés par des experts.
Existe-t-il un benchmark qui compare les agents IA pour le SIG ?
Oui, plusieurs. GeoKTools et GeoExpertQueries de Google, GeoBenchX, GS-QA2, GISAgentBench et GeoNatureAgent testent tous des agents sur des tâches géospatiales, chacun avec ses propres questions et son propre notateur, si bien que leurs scores ne se comparent pas d’un benchmark à l’autre.
Comment AI Agent se comporte-t-il sur les autres benchmarks géospatiaux ?
Sur GeoBenchX, un benchmark public de tâches SIG en plusieurs étapes, il a réussi 62,8 % des 160 tâches sur deux essais. Sur GS-QA2, des questions spatiales sur des lieux des États-Unis vérifiées par rapport à un instantané figé de la carte, il a obtenu 61,1 sur 100 avec les données propres au benchmark. Aucun autre agent n’a tourné dans les mêmes conditions.
Le plugin QGIS AI Agent est-il gratuit ?
Oui. Le plan gratuit comprend 5 tâches par mois en effort Low, le réglage derrière tous les scores de benchmark ici, sans clé API ni carte bancaire. Les efforts Medium et High viennent avec Pro.