Plugin AI Agent per QGIS: l'agente IA più potente per QGIS
Pubblicato il
AI Agent di TerraLab è un plugin gratuito per QGIS che risponde a domande geospaziali dentro QGIS. Su GeoKTools e GeoExpertQueries, i due benchmark geospaziali pubblicati da Google Research a ottobre 2026, ha ottenuto 43,8 su 100 su 41 domande tenute fuori, contro 24,9 di Claude Sonnet 5.5 con un server QGIS MCP, 22,1 di GPT-6 Luna con un server QGIS MCP e 21,0 di GPT-6 Luna da solo. È il punteggio più alto fra tutti gli agenti IA che abbiamo testato in QGIS, in esecuzioni dal 16 al 20 ottobre 2026 valutate con il codice di valutazione di Google.
Fai una domanda a parole tue, sul rischio di alluvione, sui tempi di percorrenza o sullo stress idrico. Il plugin trova i dati, esegue l'analisi con QGIS e aggiunge il risultato al tuo progetto sotto forma di layer, con le fonti indicate.
- Plugin AI Agent per QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Accuratezza da 0 a 100 su GeoKTools e GeoExpertQueries, i benchmark di Google Research per gli agenti geospaziali (arXiv:2610.15750): le 41 domande tenute fuori, senza legame con la nostra messa a punto, valutate con il codice di valutazione di Google, media di 3 esecuzioni. Il plugin con effort Low, l'impostazione del piano gratuito.
Che punteggio ha ottenuto AI Agent sui benchmark geospaziali di Google?
| Plugin AI Agent per QGIS | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna da solo | |
|---|---|---|---|---|
GeoKTools 30 domande Scorer deterministico offline di Google Scorer deterministico | 53.5Effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 domande Protocollo di report di Google: corrispondenza esatta, altrimenti giudice Gemini 3.8 Flash Protocollo di report di Google | 36.9Effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 domande Autorater indipendente dagli strumenti, Gemini 3.8 Flash, 3 esecuzioni del giudice Autorater, 3 esecuzioni del giudice | 62.6Effort Low | 29.3 | 8.6 | 0.0 |
Tutte le 41 domande 41 domande Entrambi i benchmark, protocollo di report di Google Protocollo di report di Google | 43.8Effort Low | 24.9 | 22.1 | 21.0 |
Punteggi da 0 a 100, media di 3 esecuzioni per sistema, con ogni scorer di Google, invariato: lo scorer deterministico, il protocollo di report e l'autorater di GeoExpertQueries. AI Agent è stato eseguito con effort Low il 20 ottobre 2026, Claude Sonnet 5.5 con un server QGIS MCP il 18 ottobre, GPT-6 Luna con un server QGIS MCP il 16 e il 17 ottobre e GPT-6 Luna da solo il 19 ottobre. Il grassetto segna il punteggio migliore di ogni riga.
Il vantaggio regge domanda per domanda. Su 41 domande, AI Agent ha ottenuto un punteggio più alto di Claude Sonnet 5.5 con un server QGIS MCP su 26 e più basso su 5, e più alto di GPT-6 Luna con un server QGIS MCP su 24 e più basso su 7. Il suo vantaggio medio su Claude è di 19 punti, fra 10 e 29 con una confidenza del 95%.
- Più alto
- Pari
- Più basso
Per ogni domanda, la media del plugin su 3 esecuzioni confrontata con quella di Claude. Tutto con effort Low.
Cosa sono GeoKTools e GeoExpertQueries?
Sono i due benchmark che Google Research ha pubblicato con il suo articolo sul Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750, 11 ottobre 2026). Le domande sono pubbliche nel repository google-research/geospatial-reasoning-benchmarks, con licenza CC BY 4.0; Google tiene private le sue domande di test ufficiali.
- GeoKTools pone domande fattuali le cui risposte richiedono da uno a quattro tipi di dati geospaziali: un confine, una statistica, un dato meteo, un conteggio di luoghi. Lo scorer deterministico di Google assegna un punteggio parziale con una tolleranza del 10% sui numeri; il suo protocollo di report richiede una corrispondenza esatta o l'approvazione di un giudice.
- GeoExpertQueries pone problemi aperti come quelli che toccherebbero a un analista, in ambiti come la scelta dei siti, i rischi naturali e la sanità pubblica. L'autorater di Google valuta ogni risposta rispetto a flussi di lavoro scritti da esperti.
Cosa può fare un agente IA in QGIS?
Risponde a domande sui luoghi lavorando su dati reali dentro QGIS: trova i dataset, esegue analisi spaziali come tempi di percorrenza, sovrapposizioni o statistiche per area, e restituisce una mappa con le sue fonti. Tre esempi, ognuno filmato partendo da un progetto QGIS vuoto con effort Low, l'impostazione del piano gratuito. Il primo viene dall'articolo di Google. Gli altri due li abbiamo scritti nello stesso stile, e nessuno dei tre è tra le domande valutate.
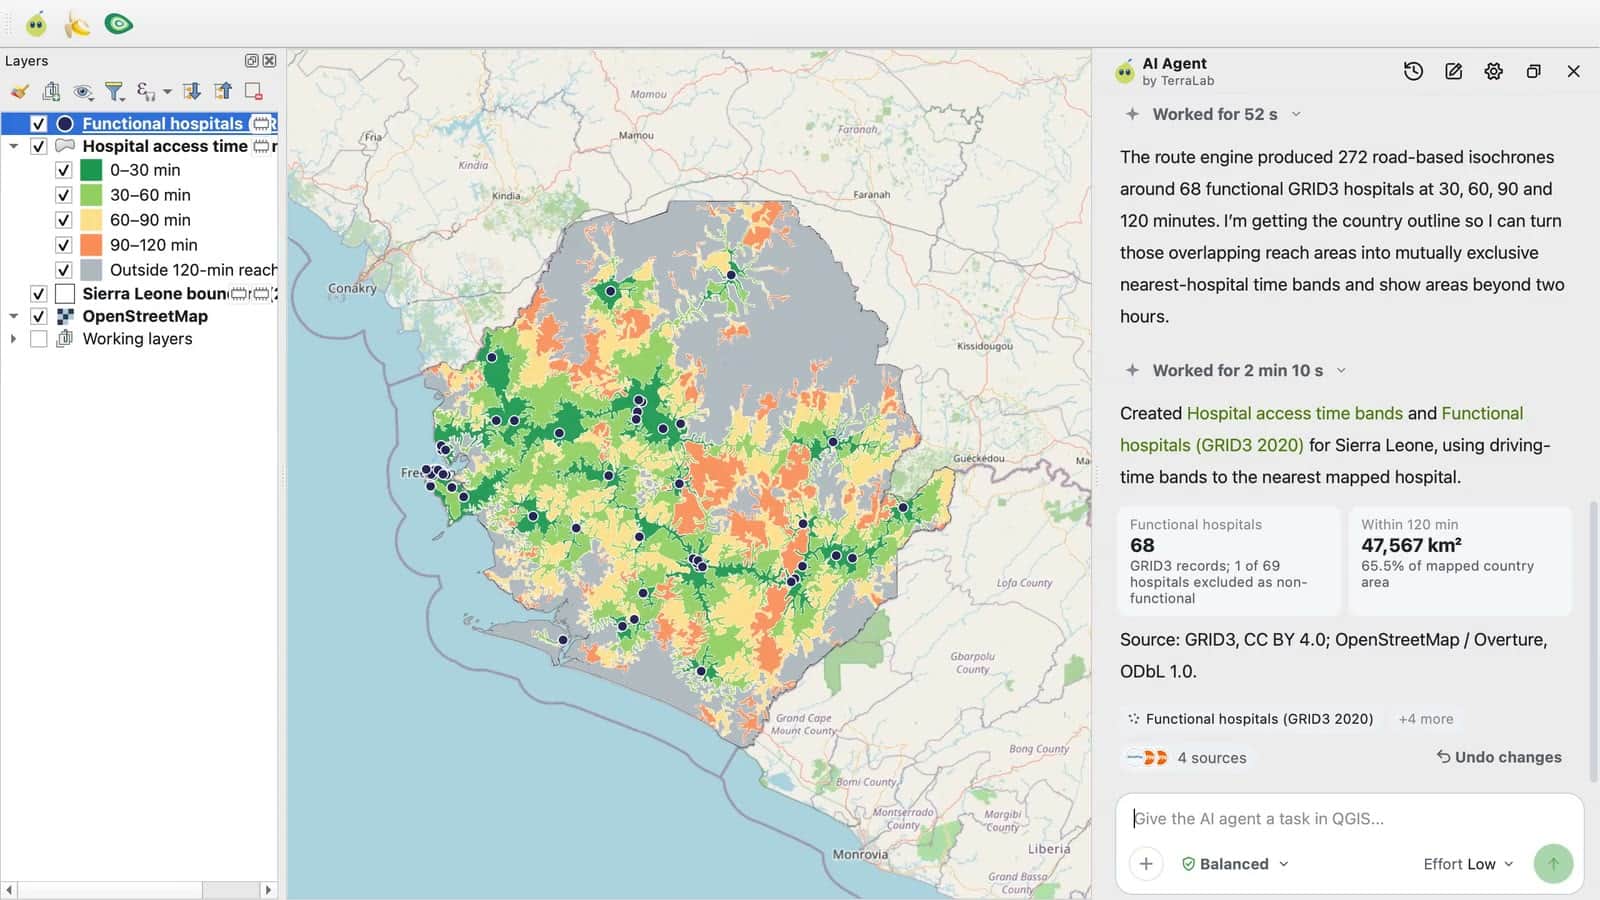
- Domanda
- Mappa il tempo di viaggio di una donna incinta per raggiungere l'ospedale più vicino per un parto d'emergenza, da qualsiasi punto della Sierra Leone. Usa il tempo di viaggio, non la distanza in linea d'aria.
- Risposta
- Il plugin ha prima chiesto come si spostano le persone e quali strutture devono contare. Con l'auto, e ogni ospedale mappato come riferimento, ha mappato il tempo fino al più vicino dei 68 ospedali in fasce da 30 minuti: il 65,5% del territorio mappato si trova entro due ore. Circa 5 minuti.
- Perché è difficile
- Serve il tempo di viaggio su strada in tutto un paese, non la distanza in linea d'aria, e una scelta su quali strutture contare che nessun modello può fare a memoria.
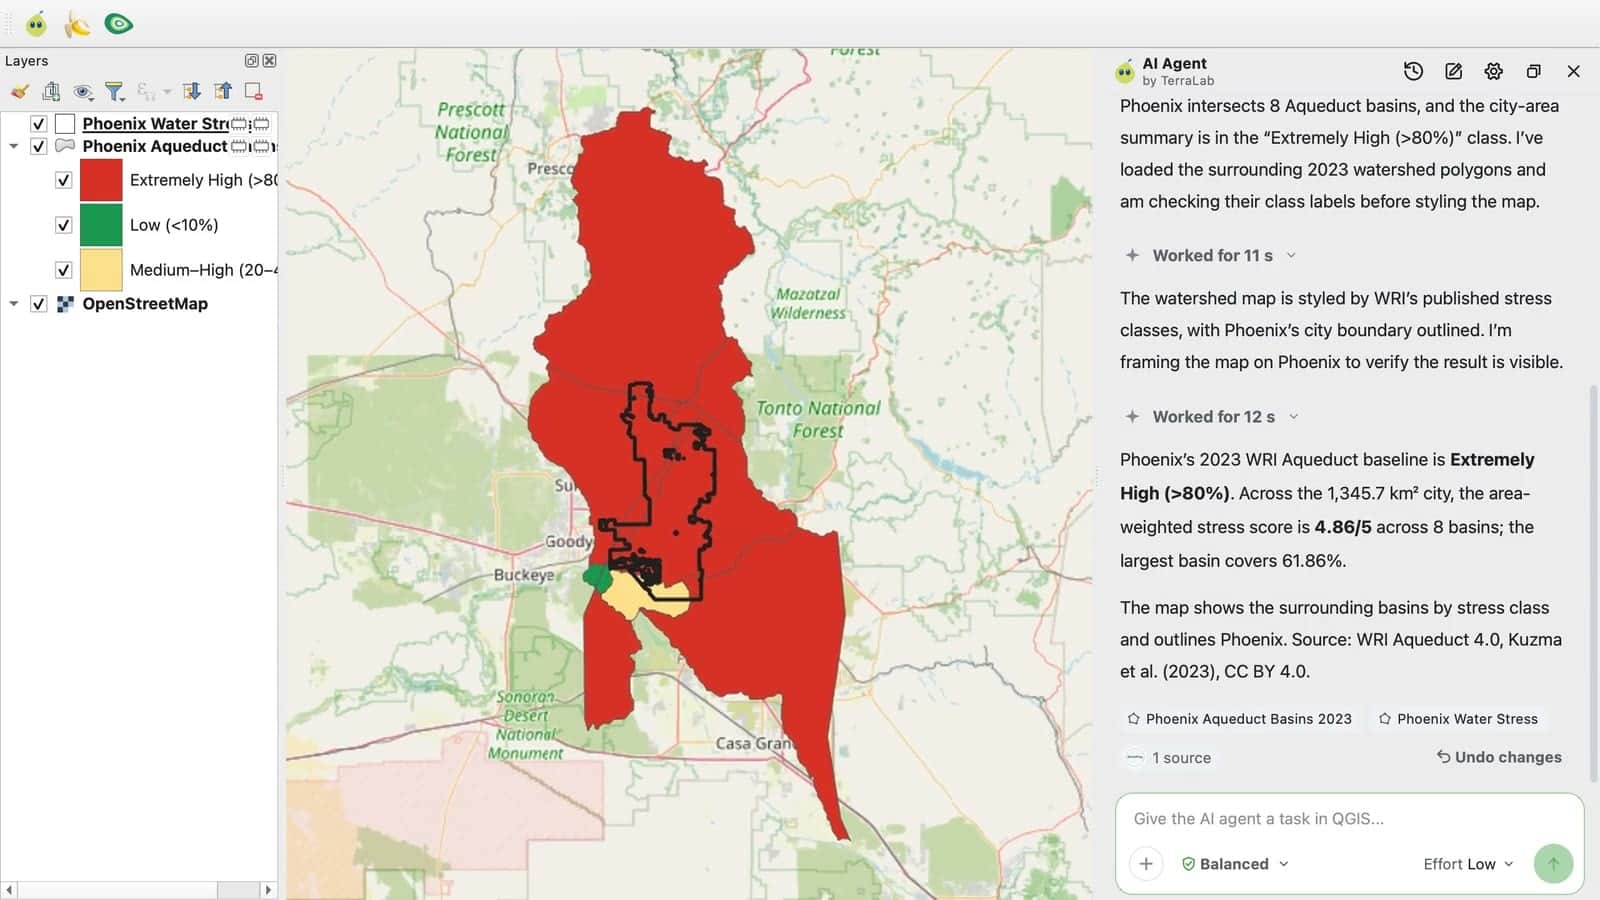
- Domanda
- Quanto è sotto stress idrico la zona intorno a Phoenix, in Arizona? Dammi lo stress idrico di base di WRI Aqueduct e mostralo sulla mappa.
- Risposta
- Extremely High, sopra l'80%. Gli 8 bacini di WRI Aqueduct che attraversano la città danno un punteggio ponderato per area di 4,86 su 5, con la fonte e la sua licenza indicate. Circa un minuto.
- Perché è difficile
- La risposta deve venire da un solo dataset indicato per nome, combinato su ogni bacino che la città sovrappone, non da ciò che un modello ricorda di Phoenix.
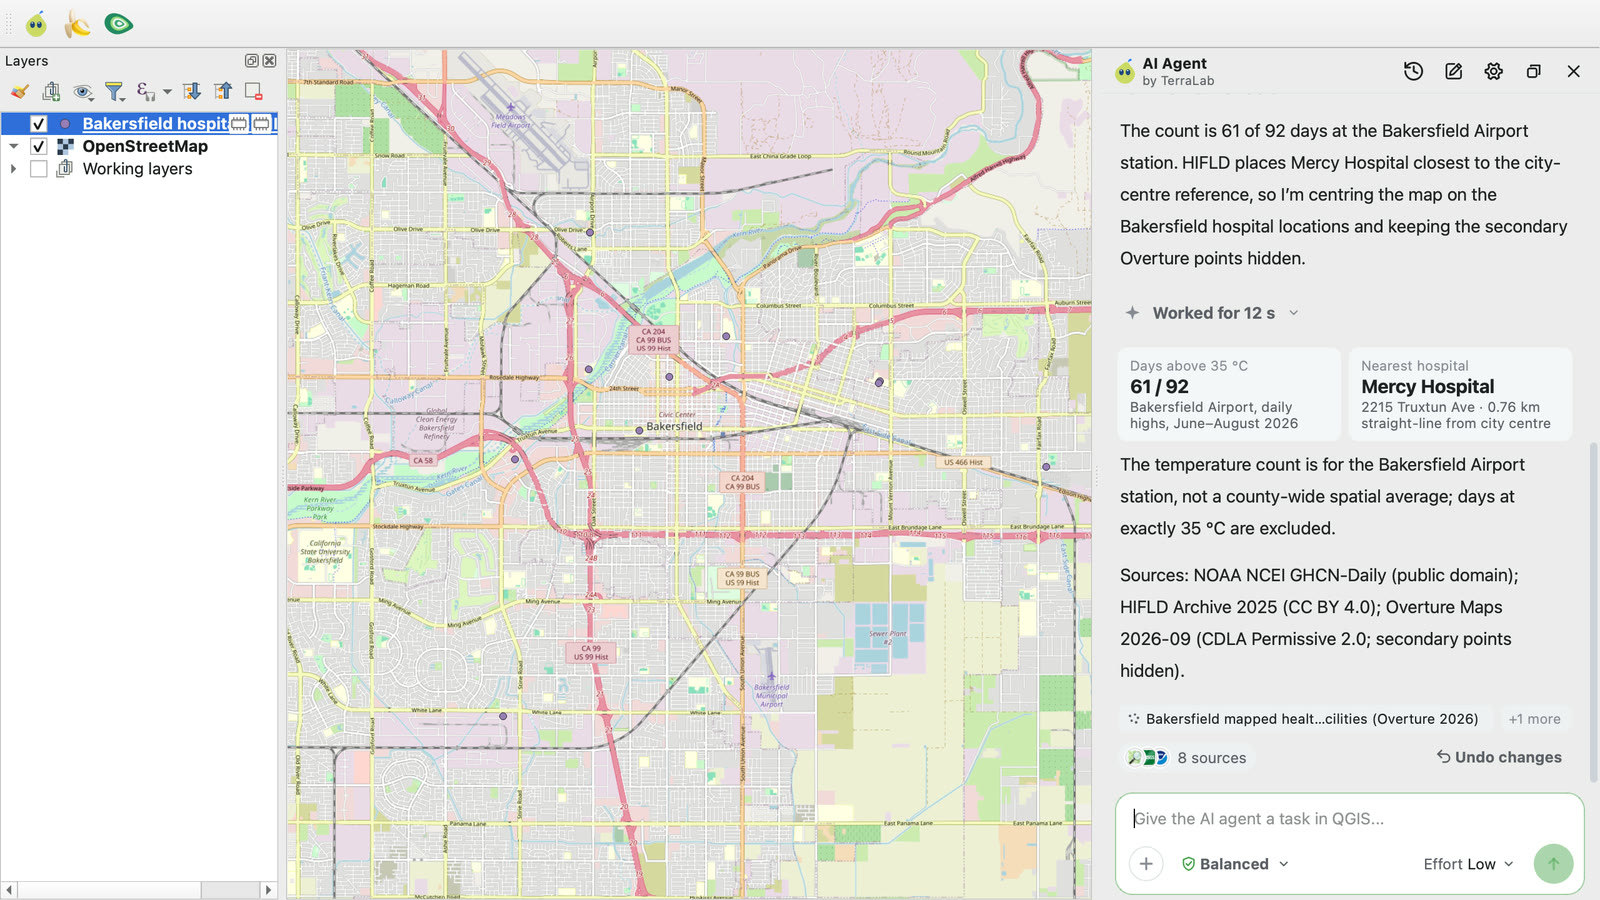
- Domanda
- Quanti giorni hanno superato i 35 °C nella contea di Kern, in California, la scorsa estate (da giugno ad agosto 2026)? E qual è l'ospedale più vicino a Bakersfield, il capoluogo della contea?
- Risposta
- 61 giorni su 92 sopra i 35 °C alla stazione dell'aeroporto di Bakersfield, con una nota che precisa che è una sola stazione, non una media della contea. L'ospedale più vicino è il Mercy Hospital, a 0,76 km dal centro della città. Circa 2 minuti.
- Perché è difficile
- Mette insieme tre fonti, i dati meteo giornalieri, un registro degli ospedali e una mappa dei luoghi, per un'estate troppo recente per rispondere a memoria.
Un plugin IA per QGIS è meglio di Claude o ChatGPT con un server QGIS MCP?
Su questi benchmark, sì. Un server QGIS MCP collega un modello di chat come Claude o ChatGPT a QGIS tramite il Model Context Protocol, così il modello può chiamare le funzioni di QGIS. Il modello può quindi usare QGIS, ma deve comunque trovare i dati, scegliere ogni passaggio e controllare il proprio lavoro. Un modello linguistico senza alcun collegamento risponde a memoria.
Il plugin AI Agent per QGIS dà al modello ciò che serve per il lavoro geospaziale: strumenti pensati per il GIS, dati con licenza che può usare e un controllo su ogni risultato prima di rispondere. Funziona direttamente dentro QGIS, quindi il modello agisce su layer reali con strumenti QGIS reali, e puoi aprire ogni risultato nel tuo progetto.
Il confronto più chiaro è un solo modello, in tre modi. Da solo, GPT-6 Luna ricorda alcune risposte di GeoKTools e ottiene 0 in ogni compito di GeoExpertQueries. Collegato a QGIS tramite un server MCP generico, ottiene più o meno lo stesso. Dentro il plugin con effort Low, lo stesso modello ottiene 53,5 su GeoKTools e 62,6 su GeoExpertQueries.
- GPT-6 Luna da solo
- GPT-6 Luna + QGIS MCP
- Plugin AI Agent per QGIS
GeoKTools con lo scorer deterministico di Google, GeoExpertQueries con il suo autorater. L'esecuzione con QGIS MCP ha usato un server e un client diversi da quelli dell'esecuzione con Claude (vedi Come abbiamo fatto i test). L'effort Low del plugin esegue GPT-6 Luna.
Il plugin è in testa a ogni livello di difficoltà. Ogni domanda di GeoKTools richiede più tipi di dati. Con due tipi, ottiene un punteggio ben superiore a ogni altro sistema. Con quattro, tutti i sistemi faticano, e il plugin resta in testa.
- Plugin AI Agent per QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna da solo
- AI Agent, dati reali
Valutato con il protocollo di report di Google, sulle 30 domande di GeoKTools tenute fuori, senza legame con la nostra messa a punto: 20 richiedono due tipi di dati, 5 ne richiedono tre e 5 ne richiedono quattro. Ogni domanda che ne richiedeva uno veniva da un modello di domanda che avevamo studiato prima della divisione, quindi quel gruppo è escluso.
- Plugin AI Agent per QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Scorer deterministico di Google. Ogni tipo ha da 3 a 5 domande, quindi una sola domanda sposta molto il suo punteggio. Il plugin supera Claude in ogni tipo tranne le aree allagate previste, a cui nessun sistema risponde. GPT-6 Luna con QGIS MCP è avanti di un punto sui luoghi in un anello. I due tipi che avevamo studiato prima della divisione, lo stress idrico intorno a un punto e il punto estremo di un'area, sono esclusi.
- Plugin AI Agent per QGIS
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Autorater di Google, indipendente dagli strumenti. La sanità pubblica ha solo 2 domande, quindi una sola domanda sposta molto il suo punteggio; il plugin e Claude pareggiano, e GPT-6 Luna da solo ha ottenuto 0 in ogni ambito.
Come va AI Agent sugli altri benchmark GIS?
Abbiamo eseguito AI Agent anche su due benchmark pubblici non di Google, senza ottimizzare nulla di AI Agent per nessuno dei due. Il nostro codice ha valutato ogni risposta rispetto alle risposte di riferimento di ciascun benchmark. Nessun altro agente è stato eseguito nelle stesse condizioni, quindi qui non c'è un confronto diretto.
GeoBenchX: 62,8% di 160 compiti
GeoBenchX (arXiv:2503.18129) chiede lavoro GIS in più passaggi su dati aperti: unire tabelle, elaborare layer e mappare paesi, città e regioni. Alcuni compiti chiedono qualcosa che i dati non possono dare, e la risposta giusta è dirlo. AI Agent ha superato il 62,8% di 160 compiti, in media su due esecuzioni.
- Plugin AI Agent per QGIS
Valutato dal codice rispetto alle soluzioni di riferimento rieseguite del benchmark, senza giudice IA. Il punteggio complessivo è la media di due esecuzioni, 65,0% e 60,6%; le altre due righe vengono dalla prima esecuzione. I risultati di GeoBenchX e la tabella di Axis Spatial valutano con un giudice IA su un insieme diverso di compiti, quindi non mettiamo il nostro punteggio accanto ai loro.
GS-QA2: 61,1 su 100 su 245 domande
GS-QA2, di Shang et al. dell'UC Riverside, pone domande spaziali sui luoghi degli Stati Uniti: l'elemento più vicino, una direzione o una distanza, la pendenza, l'esposizione o la quota del terreno. Ogni risposta di riferimento viene da un'istantanea fissa di OpenStreetMap e da un modello di elevazione. Con quegli stessi dati, AI Agent ottiene 61,1 su 100. Sui dati live di oggi ottiene 22,0, perché i luoghi aggiunti, rinominati o ridisegnati dopo l'istantanea non corrispondono più al riferimento. GPT-6 Luna da solo, il modello che AI Agent esegue con effort Low, ottiene 15,1.
- Plugin AI Agent per QGIS
- AI Agent, dati reali
- GPT-6 Luna da solo
Punteggio da 0 a 100, media sui 49 modelli di domanda del benchmark, 3 esecuzioni. Valutato dal codice con le tolleranze dell'articolo, senza giudice IA. Axis Spatial pubblica i punteggi di GS-QA2 con la stessa impostazione dei dati, ma su un'altra estrazione di domande e con un controllore privato, quindi non sono confrontabili alla pari.
Altri benchmark pubblici per gli agenti GIS sono GISAgentBench e GeoNatureAgent. Non abbiamo eseguito AI Agent su di essi, quindi questa pagina non riporta alcun punteggio.
Come abbiamo fatto i test?
- Google Research ha pubblicato GeoKTools e GeoExpertQueries con il suo articolo (arXiv:2610.15750), insieme a domande di prova; tiene private le sue domande di test ufficiali. Questa è un'esecuzione nostra sulle domande pubbliche, non una classifica di Google.
- Abbiamo migliorato l'agente su metà delle domande pubbliche e lo abbiamo misurato sulle altre 50, divise per modello di domanda. Prima di quella divisione, mentre esploravamo il benchmark, avevamo studiato due modelli di domanda con le loro risposte. Nove delle 50 domande vengono da lì, quindi le abbiamo escluse: ogni punteggio qui riguarda le altre 41, le domande tenute fuori, senza legame con la nostra messa a punto.
- Ogni sistema ha ricevuto le stesse domande, le stesse istruzioni e gli stessi limiti, un progetto QGIS vuoto e 3 tentativi. Il codice di valutazione di Google ha valutato ogni risposta.
- Abbiamo eseguito il plugin con effort Low (GPT-6 Luna, sul piano gratuito) e con effort High (un modello diverso che pianifica più a fondo, con Pro). Low ha ottenuto un punteggio più alto su entrambi i benchmark, quindi ogni punteggio mostrato è Low.
- Claude Sonnet 5.5 è stato eseguito in Claude Code con il plugin QGIS MCP di nkarasiak, versione 0.15.1, con i suoi strumenti di shell, web e file disattivati, il 18 ottobre. GPT-6 Luna + QGIS MCP è stato eseguito nel Codex CLI di OpenAI con il server qgis_mcp di jjsantos01, il 16 e il 17 ottobre. GPT-6 Luna da solo ha risposto senza strumenti.
Dettagli tecnici
Benchmark: GeoKTools e GeoExpertQueries da google-research/geospatial-reasoning-benchmarks, commit c21a6d95, dati con licenza CC BY 4.0. Lo split pubblico di sviluppo (85 domande di GeoKTools, 25 di GeoExpertQueries) è stato diviso in due per modello di domanda; la metà tenuta fuori ha 39 domande di GeoKTools e 11 di GeoExpertQueries. Prima della divisione avevamo controllato le risposte di riferimento di due modelli di GeoKTools, punto estremo di un'area e stress idrico intorno a un punto; le loro 9 domande sono finite nella metà tenuta fuori e sono escluse da ogni punteggio, il che lascia 30 domande di GeoKTools e 11 di GeoExpertQueries. Ogni sistema ha ricevuto il prefisso di prompt di Google, al massimo 100 chiamate al modello e 30 minuti per domanda, e 3 esecuzioni complete; un'esecuzione fallita o scaduta vale 0. Scorer, invariati: lo scorer deterministico di GeoKTools (tolleranza del 10% sui numeri, punteggio parziale, ROUGE-L sul testo); il protocollo di report di GeoKTools (corrispondenza esatta, altrimenti un giudice Gemini 3.8 Flash); l'autorater di GeoExpertQueries indipendente dagli strumenti (Gemini 3.8 Flash, 3 esecuzioni del giudice per risposta). L'intervallo al 95% è un bootstrap accoppiato sulle domande. Esecuzioni: il plugin con effort Low e High il 20 ottobre 2026; Claude + QGIS MCP il 18 ottobre; GPT-6 Luna da solo il 19 ottobre. Le chiamate agli strumenti di ogni prova sono state controllate per letture del repository del benchmark, del suo file di domande o dell'articolo, e un riscontro vale 0: il plugin non ne ha avuti, le esecuzioni di GPT-6 Luna + QGIS MCP ne hanno avuti 2. Le prove fallite, rifiutate o scadute valgono 0 e restano nelle medie (7 su 150 per GPT-6 Luna + QGIS MCP, nessuna delle 150 del plugin con effort Low).
GeoBenchX: Solirinai/GeoBenchX al commit 0edf6109, licenza MIT, 202 compiti, descritto in arXiv:2503.18129. Abbiamo escluso 23 compiti esclusi da un audit pubblicato, 3 domande di controllo e 16 la cui soluzione di riferimento non si riproduce o chiede una cifra che il riferimento non calcola, lasciandone 160. AI Agent ha eseguito ogni compito in due esecuzioni separate con effort Low il 20 ottobre 2026, in QGIS, con i dati del compito in una cartella accanto a un progetto vuoto: 65,0% (intervallo al 95% da 56,9 a 72,5) e 60,6%. Nella prima esecuzione ha risolto 46 dei 92 compiti che hanno una risposta, ha rifiutato 55 dei 62 che non si possono risolvere e ha superato 3 dei 6 che accettano entrambe le cose. Valutato dal codice, senza giudice IA, rispetto alla soluzione di riferimento rieseguita: i valori che la mappa mostra, i conteggi di feature, il numero che la risposta indica, o nessuna mappa per i compiti che non si possono risolvere.
GS-QA2: Zoe/GS-QA2 alla revisione 0ccf9453, di Shang et al. (UC Riverside), ODbL 1.0, © OpenStreetMap contributors; ASTER GDEM è un prodotto di METI e NASA. 245 domande, 5 per ciascuno dei 49 modelli di domanda, estratte con la stessa regola della tabella di Axis Spatial ma non le stesse domande. Tre impostazioni, 3 esecuzioni ciascuna: AI Agent con effort Low con le tabelle OpenStreetMap e l'elevazione ASTER del benchmark, ritagliate sulle aree delle domande, in una cartella accanto a un progetto vuoto, con il prompt che dice solo dove sono i dati (61,1, intervallo al 95% da 57,1 a 65,2); AI Agent con effort Low da un progetto vuoto sui dati live (22,0, da 19,0 a 25,2); GPT-6 Luna da solo, una chiamata senza strumenti (15,1, da 12,2 a 18,1). La risposta finale è controllata rispetto a ogni riga di riferimento con le tolleranze dell'articolo: nomi per sovrapposizione di token, posizioni entro 5 m, direzione, esposizione e pendenza entro 5°, quota entro 10 m, distanze, aree e conteggi entro il 5%.
Cosa non mostrano questi risultati?
- Un'esecuzione nostra, su domande pubbliche. Google tiene private le sue domande di test. Questi punteggi vengono dalle domande pubbliche, eseguite e valutate da noi con il codice di Google.
- 41 domande, non 50. I nostri post di annuncio riportano 52,9, il punteggio del plugin con il protocollo di report su tutte le 50 domande tenute fuori. Include le 9 dei modelli di domanda che avevamo studiato, quindi ogni punteggio di questa pagina le esclude.
- Campioni piccoli. GeoExpertQueries ha 11 domande tenute fuori e ogni tipo di domanda di GeoKTools ne ha da 3 a 5, quindi una sola domanda sposta molto quei punteggi. Il confronto su tutte le 41 domande è quello da citare.
- Solo gli agenti che abbiamo testato. Abbiamo confrontato tre configurazioni: Claude Sonnet 5.5 e GPT-6 Luna, ciascuno tramite un solo server QGIS MCP della community, e GPT-6 Luna da solo. Altri modelli, altri server MCP e l'agente di Google descritto nell'articolo non sono in questo confronto.
- Nessun confronto diretto su GeoBenchX o GS-QA2. I punteggi pubblicati su quei benchmark usano altri insiemi di compiti e altri valutatori, quindi non mettiamo AI Agent in classifica rispetto a essi.
Come si installa il plugin AI Agent per QGIS?
Il plugin AI Agent per QGIS è gratuito nel repository ufficiale dei plugin di QGIS, per QGIS 3.28 e successivi, QGIS 4 compreso. In QGIS apri Plugins, poi Manage and Install Plugins, cerca AI Agent by TerraLab, installalo e accedi. Non servono chiavi API né carta.
Il piano gratuito include 5 attività al mese con effort Low, l'impostazione dietro ogni punteggio qui sopra. Gli effort Medium e High sono inclusi in Pro. La guida completa illustra una prima attività, e cos'è un agente IA in QGIS spiega l'idea.
Domande frequenti
Qual è il miglior agente IA per QGIS?
Fra tutti gli agenti IA che abbiamo testato in QGIS sui benchmark geospaziali di Google, il plugin AI Agent per QGIS di TerraLab ha ottenuto il punteggio più alto: 43,8 su 100 su 41 domande tenute fuori, contro 24,9 di Claude Sonnet 5.5 con un server QGIS MCP e 22,1 di GPT-6 Luna con un server QGIS MCP. È un plugin gratuito nel repository ufficiale dei plugin di QGIS.
Quale IA è la migliore per l'analisi GIS?
Per l'analisi dentro QGIS, il plugin AI Agent per QGIS ha ottenuto il punteggio più alto fra gli agenti che abbiamo testato sui benchmark GeoKTools e GeoExpertQueries di Google. Non abbiamo testato strumenti per altri software GIS, come gli strumenti GeoAI di Esri per ArcGIS.
ChatGPT può lavorare in QGIS?
ChatGPT da solo risponde a memoria e non può usare QGIS. Collegato tramite un server QGIS MCP in Codex di OpenAI, GPT-6 Luna ha ottenuto 39,5 su GeoKTools e 8,6 su GeoExpertQueries, più o meno quanto lo stesso modello senza strumenti. Dentro il plugin AI Agent per QGIS, lo stesso modello ha ottenuto 53,5 e 62,6.
Claude può lavorare con QGIS?
Sì, tramite un server QGIS MCP come il plugin QGIS MCP di nkarasiak. Nel nostro test, Claude Sonnet 5.5 con quel server ha ottenuto 33,3 su GeoKTools e 29,3 su GeoExpertQueries; il plugin AI Agent per QGIS ha ottenuto 53,5 e 62,6, e un punteggio più alto su 26 delle 41 domande.
Cos'è un server QGIS MCP?
Un ponte che permette a un modello di chat come Claude o ChatGPT di chiamare le funzioni di QGIS tramite il Model Context Protocol. Il modello può quindi usare QGIS, ma deve trovare i dati e controllare il proprio lavoro da solo. La nostra guida a QGIS MCP confronta i server.
Cosa sono i benchmark di ragionamento geospaziale di Google?
GeoKTools e GeoExpertQueries, pubblicati da Google Research a ottobre 2026 con il suo articolo sul Google Earth AI Geospatial Reasoning Agent (arXiv:2610.15750). GeoKTools pone domande fattuali che richiedono da uno a quattro tipi di dati geospaziali; GeoExpertQueries pone problemi aperti da analista, valutati rispetto a flussi di lavoro scritti da esperti.
Esiste un benchmark che confronta gli agenti IA per il GIS?
Sì, diversi. GeoKTools e GeoExpertQueries di Google, GeoBenchX, GS-QA2, GISAgentBench e GeoNatureAgent mettono tutti alla prova gli agenti su compiti geospaziali, ognuno con le proprie domande e il proprio valutatore, quindi i loro punteggi non sono confrontabili tra un benchmark e l'altro.
Come se la cava AI Agent sugli altri benchmark geospaziali?
Su GeoBenchX, un benchmark pubblico di compiti GIS in più passaggi, ha superato il 62,8% di 160 compiti in due esecuzioni. Su GS-QA2, domande spaziali sui luoghi degli Stati Uniti verificate rispetto a un'istantanea fissa della mappa, ha ottenuto 61,1 su 100 con i dati del benchmark. Nessun altro agente è stato eseguito nelle stesse condizioni.
Il plugin AI Agent per QGIS è gratuito?
Sì. Il piano gratuito include 5 attività al mese con effort Low, l'impostazione dietro ogni punteggio di benchmark qui riportato, senza chiave API né carta. Gli effort Medium e High sono inclusi in Pro.