AI Agent QGIS-Plugin: der leistungsstärkste KI-Agent für QGIS
Veröffentlicht am
AI Agent von TerraLab ist ein kostenloses QGIS-Plugin, das geografische Fragen direkt in QGIS beantwortet. Auf GeoKTools und GeoExpertQueries, den beiden Geo-Benchmarks, die Google Research im Oktober 2026 veröffentlicht hat, erreichte es 43,8 von 100 bei 41 zurückgehaltenen Fragen, gegenüber 24,9 für Claude Sonnet 5.5 mit einem QGIS-MCP-Server, 22,1 für GPT-6 Luna mit einem QGIS-MCP-Server und 21,0 für GPT-6 Luna allein. Das ist der höchste Wert aller KI-Agenten, die wir in QGIS getestet haben, in Läufen vom 16. bis 20. Oktober 2026, bewertet mit dem Scoring-Code von Google selbst.
Sie stellen eine Frage in einfachen Worten, etwa zu Hochwasserrisiko, Fahrzeiten oder Wasserstress. Das Plugin findet die Daten, führt die Analyse mit QGIS aus und fügt das Ergebnis als Layer mit genannten Quellen zu Ihrem Projekt hinzu.
- AI Agent QGIS-Plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Genauigkeit von 0 bis 100 auf GeoKTools und GeoExpertQueries, den Benchmarks von Google Research für Geo-Agenten (arXiv:2610.15750): die 41 zurückgehaltenen Fragen ohne Bezug zu unserem Tuning, bewertet mit Googles eigenem Scoring-Code, Mittel aus 3 Läufen. Das Plugin mit Effort Low, der Einstellung im kostenlosen Tarif.
Wie hat AI Agent in den Geo-Benchmarks von Google abgeschnitten?
| AI Agent QGIS-Plugin | Claude + QGIS MCP | GPT-6 Luna + QGIS MCP | GPT-6 Luna allein | |
|---|---|---|---|---|
GeoKTools 30 Fragen Deterministischer Offline-Scorer von Google Deterministischer Scorer | 53.5Effort Low | 33.3 | 39.5 | 44.2 |
GeoKTools 30 Fragen Report-Protokoll von Google: exakte Übereinstimmung, sonst Gemini 3.8 Flash als Richter Report-Protokoll von Google | 36.9Effort Low | 23.3 | 27.0 | 28.7 |
GeoExpertQueries 11 Fragen Tool-unabhängiger Autorater, Gemini 3.8 Flash, 3 Richterläufe Autorater, 3 Richterläufe | 62.6Effort Low | 29.3 | 8.6 | 0.0 |
Alle 41 Fragen 41 Fragen Beide Benchmarks, Report-Protokoll von Google Report-Protokoll von Google | 43.8Effort Low | 24.9 | 22.1 | 21.0 |
Werte von 0 bis 100, Mittel aus 3 Läufen pro System, jeder Scorer von Google und unverändert: der deterministische Scorer, das Report-Protokoll und der Autorater von GeoExpertQueries. AI Agent lief am 20. Oktober 2026 mit Effort Low, Claude Sonnet 5.5 mit einem QGIS-MCP-Server am 18. Oktober, GPT-6 Luna mit einem QGIS-MCP-Server am 16. und 17. Oktober und GPT-6 Luna allein am 19. Oktober. Fett markiert den besten Wert in jeder Zeile.
Der Vorsprung gilt Frage für Frage. Von den 41 Fragen erzielte AI Agent bei 26 einen höheren und bei 5 einen niedrigeren Wert als Claude Sonnet 5.5 mit einem QGIS-MCP-Server, und bei 24 einen höheren und bei 7 einen niedrigeren als GPT-6 Luna mit einem QGIS-MCP-Server. Der durchschnittliche Vorsprung vor Claude beträgt 19 Punkte, mit 95 % Konfidenz zwischen 10 und 29.
- Höher
- Gleich
- Niedriger
Für jede Frage der Durchschnitt des Plugins aus 3 Läufen im Vergleich zu dem von Claude. Alle mit Effort Low.
Was sind GeoKTools und GeoExpertQueries?
Es sind die beiden Benchmarks, die Google Research zusammen mit seinem Paper zum Google Earth AI Geospatial Reasoning Agent veröffentlicht hat (arXiv:2610.15750, 11. Oktober 2026). Die Fragen sind im Repository google-research/geospatial-reasoning-benchmarks unter CC BY 4.0 öffentlich; Google hält seine offiziellen Testfragen zurück.
- GeoKTools stellt Sachfragen, deren Antworten ein bis vier Arten von Geodaten brauchen: eine Grenze, eine Statistik, eine Wetteraufzeichnung, eine Zahl von Orten. Googles deterministischer Scorer gibt Teilpunkte mit 10 % Toleranz bei Zahlen; sein Report-Protokoll verlangt eine exakte Übereinstimmung oder die Zustimmung eines Richters.
- GeoExpertQueries stellt offene Probleme, wie sie einem Analysten begegnen, in Bereichen wie Standortwahl, Naturgefahren und öffentlicher Gesundheit. Googles Autorater bewertet jede Antwort anhand von Arbeitsabläufen, die Fachleute geschrieben haben.
Was kann ein KI-Agent in QGIS?
Er beantwortet Fragen zu Orten, indem er in QGIS mit echten Daten arbeitet: Er findet Datensätze, führt räumliche Analysen wie Fahrzeiten, Überlagerungen oder Statistiken pro Gebiet aus und liefert eine Karte mit ihren Quellen. Drei Beispiele, jedes aus einem leeren QGIS-Projekt mit Effort Low gefilmt, der Einstellung im kostenlosen Tarif. Das erste stammt aus Googles Paper. Die anderen beiden haben wir im gleichen Stil geschrieben, und keines gehört zu den bewerteten Fragen.
- Frage
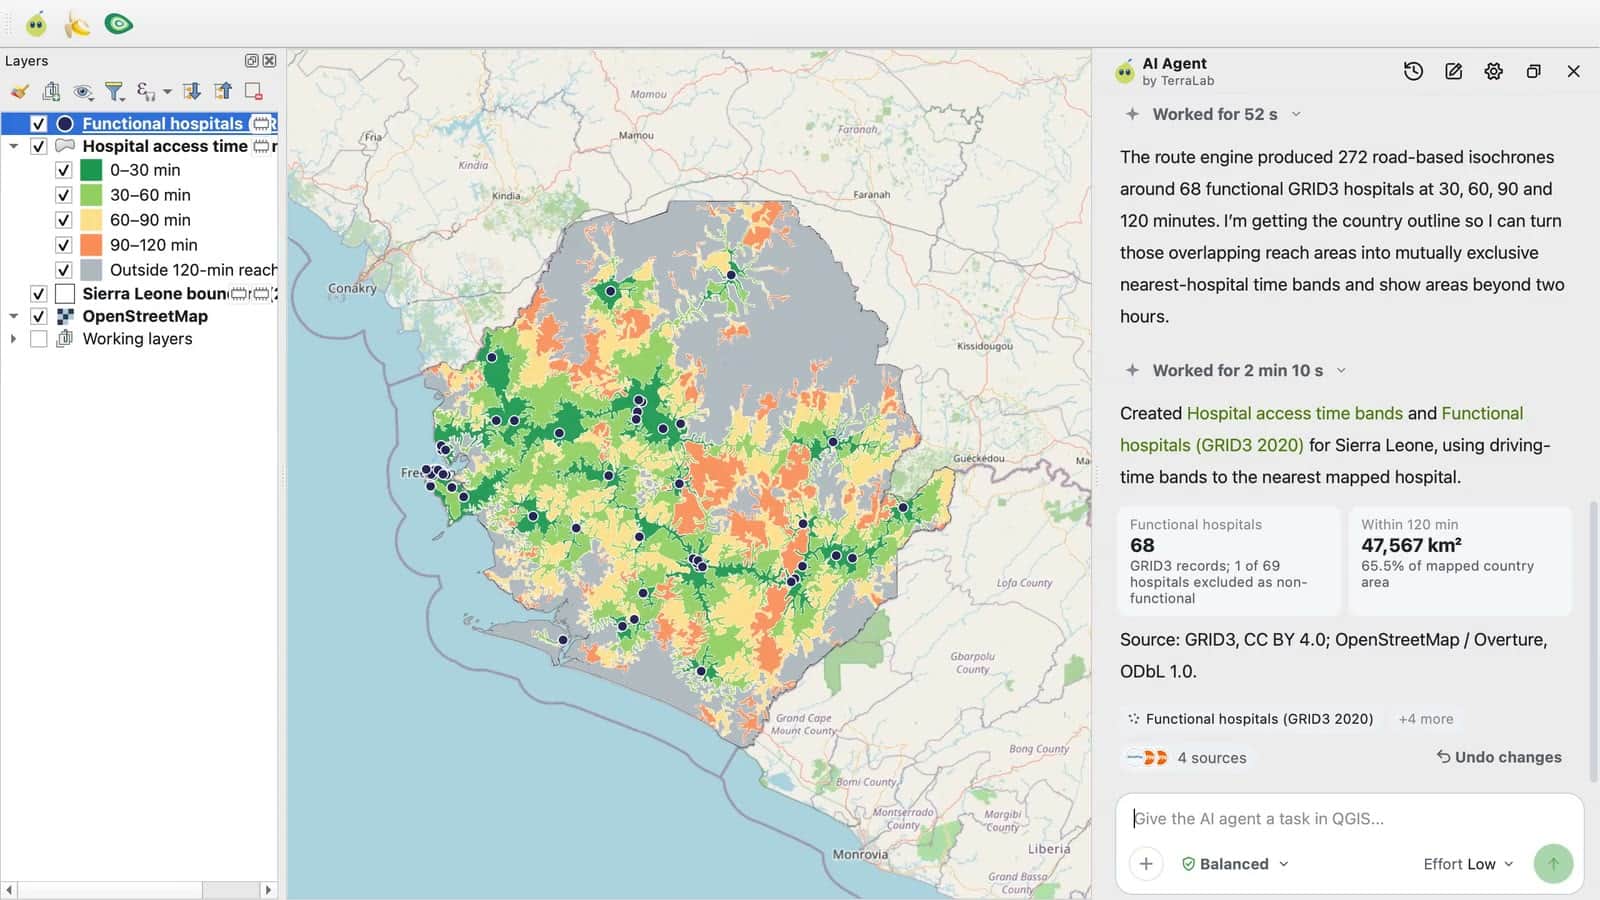
- Kartiere die Fahrzeit, die eine schwangere Frau von jedem Ort in Sierra Leone bis zum nächsten Krankenhaus für eine Notfallgeburt braucht. Nutze die Fahrzeit, nicht die Luftlinie.
- Antwort
- Das Plugin fragte zuerst, wie sich die Menschen fortbewegen und welche Einrichtungen zählen sollen. Mit Auto als Verkehrsmittel und jedem kartierten Krankenhaus als Ersatz kartierte es die Zeit bis zum nächsten von 68 Krankenhäusern in 30-Minuten-Stufen: 65,5 % des kartierten Landes liegen innerhalb von zwei Stunden. Etwa 5 Minuten.
- Warum es schwer ist
- Es braucht die Fahrzeit auf der Straße im ganzen Land, nicht die Luftlinie, und eine Entscheidung, welche Einrichtungen zählen, die kein Modell aus dem Gedächtnis treffen kann.
- Frage
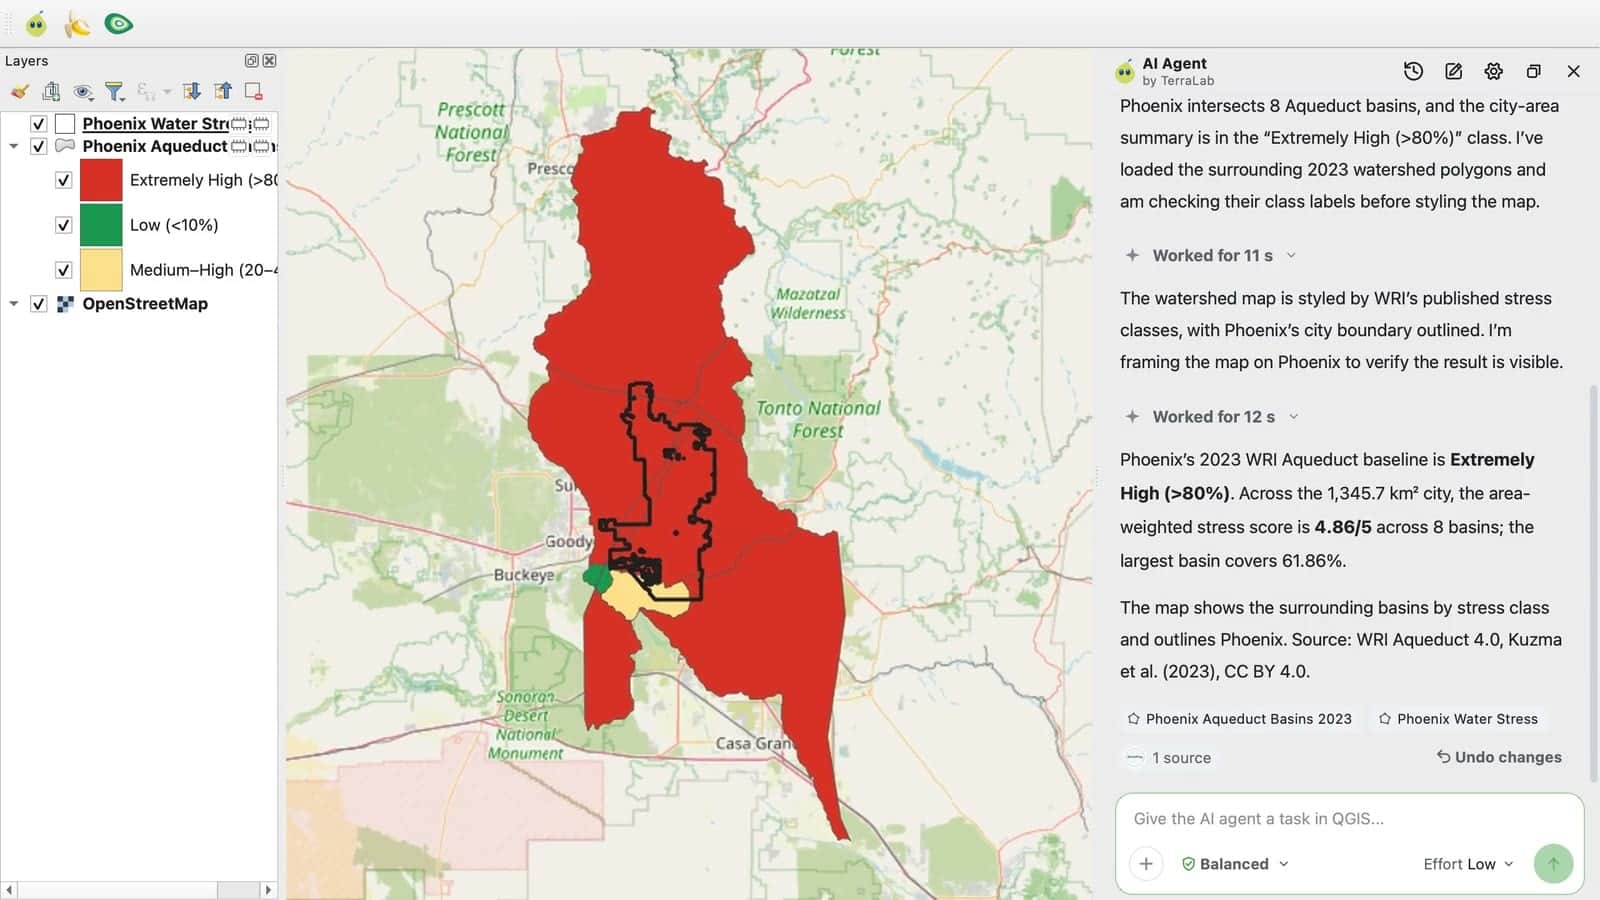
- Wie hoch ist der Wasserstress im Raum Phoenix, Arizona? Nenne den Baseline Water Stress von WRI Aqueduct dort und zeige ihn auf der Karte.
- Antwort
- Extremely High, über 80 %. Die 8 WRI-Aqueduct-Einzugsgebiete, die durch die Stadt verlaufen, ergeben einen flächengewichteten Wert von 4,86 von 5, mit genannter Quelle und Lizenz. Etwa eine Minute.
- Warum es schwer ist
- Die Antwort muss aus einem benannten Datensatz stammen, kombiniert über jedes Einzugsgebiet, das die Stadt überlappt, und nicht aus dem, woran sich ein Modell zu Phoenix erinnert.
- Frage
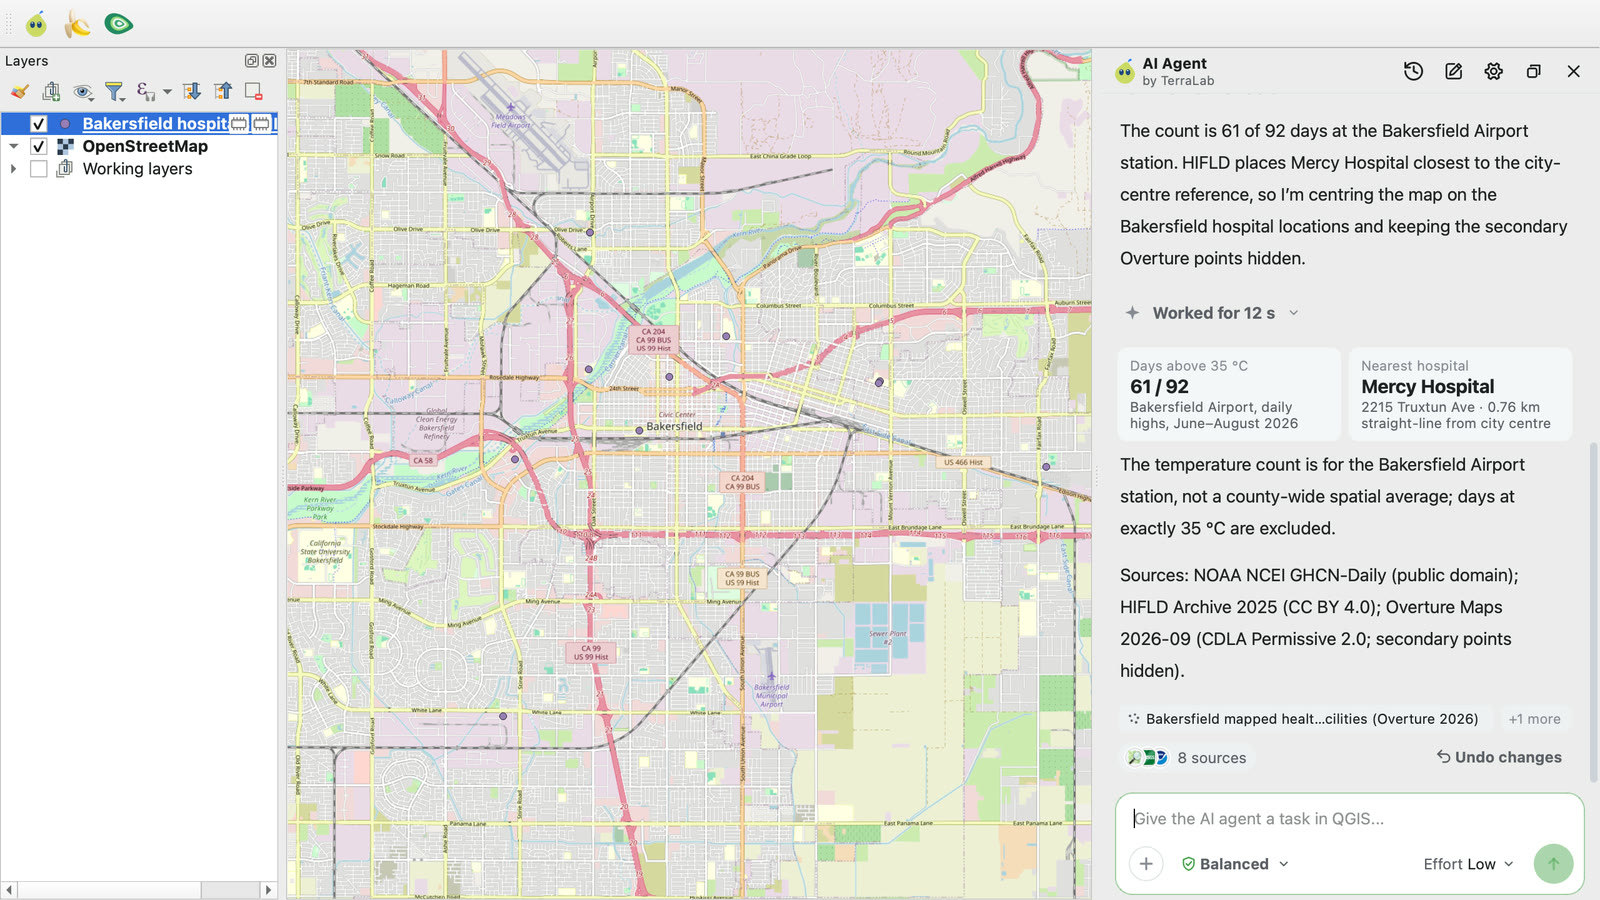
- An wie vielen Tagen lag die Temperatur im vergangenen Sommer (Juni bis August 2026) in Kern County, Kalifornien, über 35 °C? Und welches Krankenhaus liegt Bakersfield, dem Sitz des Countys, am nächsten?
- Antwort
- 61 von 92 Tagen über 35 °C an der Wetterstation des Flughafens von Bakersfield, mit dem Hinweis, dass dies eine einzelne Station ist und kein Durchschnitt des Countys. Das nächste Krankenhaus ist das Mercy Hospital, 0,76 km vom Stadtzentrum entfernt. Etwa 2 Minuten.
- Warum es schwer ist
- Es verknüpft drei Quellen, tägliche Wetteraufzeichnungen, ein Krankenhausregister und eine Karte von Orten, für einen Sommer, der zu aktuell ist, um aus dem Gedächtnis zu antworten.
Ist ein KI-Plugin für QGIS besser als Claude oder ChatGPT mit einem QGIS-MCP-Server?
Bei diesen Benchmarks ja. Ein QGIS-MCP-Server verbindet ein Chat-Modell wie Claude oder ChatGPT über das Model Context Protocol mit QGIS, sodass das Modell QGIS-Funktionen aufrufen kann. Das Modell kann dann QGIS bedienen, muss aber trotzdem die Daten selbst finden, jeden Schritt wählen und seine Arbeit selbst prüfen. Ein Sprachmodell ohne Verbindung antwortet aus dem Gedächtnis.
Das AI Agent QGIS-Plugin gibt dem Modell, was es für Geoarbeit braucht: für GIS gebaute Werkzeuge, lizenzierte Daten, die es nutzen darf, und eine Prüfung jedes Ergebnisses, bevor es antwortet. Es arbeitet direkt in QGIS, sodass das Modell mit echten QGIS-Werkzeugen auf echten Layern handelt und Sie jedes Ergebnis in Ihrem Projekt öffnen können.
Der klarste Vergleich ist ein Modell auf drei Arten. Allein erinnert sich GPT-6 Luna an einige Antworten von GeoKTools und erzielt bei jeder Aufgabe von GeoExpertQueries 0. Über einen allgemeinen MCP-Server mit QGIS verbunden, erzielt es etwa dasselbe. Im Plugin mit Effort Low erreicht dasselbe Modell 53,5 auf GeoKTools und 62,6 auf GeoExpertQueries.
- GPT-6 Luna allein
- GPT-6 Luna + QGIS MCP
- AI Agent QGIS-Plugin
GeoKTools mit Googles deterministischem Scorer, GeoExpertQueries mit seinem Autorater. Der Lauf mit QGIS MCP nutzte einen anderen Server und einen anderen Client als der Lauf mit Claude (siehe Wie haben wir getestet?). Das Plugin mit Effort Low nutzt GPT-6 Luna.
Das Plugin führt auf jeder Schwierigkeitsstufe. Jede Frage von GeoKTools braucht mehrere Arten von Daten. Bei zwei Arten liegt es deutlich vor jedem anderen System. Bei vier tun sich alle Systeme schwer, und das Plugin bleibt vorn.
- AI Agent QGIS-Plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
- GPT-6 Luna allein
- AI Agent, Live-Daten
Bewertet mit Googles Report-Protokoll, auf den 30 zurückgehaltenen Fragen von GeoKTools ohne Bezug zu unserem Tuning: 20 brauchen zwei Datenarten, 5 brauchen drei und 5 brauchen vier. Jede Frage mit einer Datenart stammte aus einer Vorlage, die wir vor der Aufteilung untersucht hatten, daher fehlt diese Gruppe.
- AI Agent QGIS-Plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Googles deterministischer Scorer. Jeder Typ hat 3 bis 5 Fragen, sodass eine Frage seinen Wert stark verschiebt. Das Plugin führt vor Claude bei jedem Typ außer vorhergesagten überfluteten Flächen, die kein System beantwortet. GPT-6 Luna mit QGIS MCP liegt bei Orten in einem Ring einen Punkt vorn. Die beiden Typen, die wir vor der Aufteilung untersucht hatten, Wasserstress rund um einen Punkt und Extrempunkt einer Fläche, fehlen.
- AI Agent QGIS-Plugin
- Claude + QGIS MCP
- GPT-6 Luna + QGIS MCP
Googles Tool-unabhängiger Autorater. Öffentliche Gesundheit hat nur 2 Fragen, sodass eine Frage seinen Wert stark verschiebt; das Plugin und Claude liegen dort gleichauf, und GPT-6 Luna allein erzielte in jedem Bereich 0.
Wie schneidet AI Agent in anderen GIS-Benchmarks ab?
Wir haben AI Agent außerdem auf zwei öffentlichen Benchmarks von außerhalb von Google laufen lassen, ohne dass an AI Agent etwas für sie abgestimmt wurde. Unser eigener Code bewertete jede Antwort anhand der Referenzantworten des jeweiligen Benchmarks. Kein anderer Agent lief unter denselben Bedingungen, daher gibt es hier keinen direkten Vergleich.
GeoBenchX: 62,8 % von 160 Aufgaben
GeoBenchX (arXiv:2503.18129) verlangt mehrstufige GIS-Arbeit mit offenen Daten: Tabellen zusammenführen, Layer verarbeiten und Länder, Städte und Regionen kartieren. Manche Aufgaben verlangen etwas, das die Daten nicht hergeben, und die richtige Antwort ist, das zu sagen. AI Agent bestand im Mittel über zwei Läufe 62,8 % von 160 Aufgaben.
- AI Agent QGIS-Plugin
Per Code bewertet anhand der nachgespielten Referenzlösungen des Benchmarks, ohne KI-Richter. Der Gesamtwert ist das Mittel aus zwei Läufen, 65,0 % und 60,6 %; die beiden anderen Zeilen stammen aus dem ersten Lauf. Die eigenen Ergebnisse von GeoBenchX und die Tabelle von Axis Spatial bewerten mit einem KI-Richter auf einem anderen Aufgabensatz, daher stellen wir unseren Wert nicht neben ihre.
GS-QA2: 61,1 von 100 bei 245 Fragen
GS-QA2 von Shang et al. an der UC Riverside stellt räumliche Fragen zu Orten in den Vereinigten Staaten: das nächste Objekt, eine Richtung oder eine Entfernung, die Neigung, Exposition oder Höhe des Geländes. Jede Referenzantwort stammt aus einem festen Snapshot von OpenStreetMap und einem Höhenmodell. Mit denselben Daten erreicht AI Agent 61,1 von 100. Mit den heutigen Live-Daten erreicht es 22,0, weil Orte, die seit dem Snapshot hinzugefügt, umbenannt oder neu gezeichnet wurden, nicht mehr zur Referenz passen. GPT-6 Luna allein, das Modell, das AI Agent mit Effort Low nutzt, erreicht 15,1.
- AI Agent QGIS-Plugin
- AI Agent, Live-Daten
- GPT-6 Luna allein
Wert von 0 bis 100, Mittel über die 49 Fragevorlagen des Benchmarks, 3 Läufe. Per Code mit den Toleranzen des Papers bewertet, ohne KI-Richter. Axis Spatial veröffentlicht GS-QA2-Werte im gleichen Datensetting, aber auf einer anderen Fragenauswahl und mit einem privaten Prüfer, daher sind sie nicht vergleichbar.
Weitere öffentliche Benchmarks für GIS-Agenten sind GISAgentBench und GeoNatureAgent. Wir haben AI Agent darauf nicht laufen lassen, daher nennt diese Seite dafür keinen Wert.
Wie haben wir getestet?
- Google Research hat GeoKTools und GeoExpertQueries mit seinem Paper veröffentlicht (arXiv:2610.15750), zusammen mit Übungsfragen; die offiziellen Testfragen hält es zurück. Das ist unser eigener Lauf auf den öffentlichen Fragen, kein Leaderboard von Google.
- Wir haben den Agenten an der Hälfte der öffentlichen Fragen verbessert und an den anderen 50 gemessen, aufgeteilt nach Fragevorlage. Davor, beim Erkunden des Benchmarks, hatten wir zwei Vorlagen samt Antworten untersucht. Neun der 50 Fragen stammen daraus, deshalb haben wir sie weggelassen: Jeder Wert hier gilt für die übrigen 41, die zurückgehaltenen Fragen ohne Bezug zu unserem Tuning.
- Jedes System bekam dieselben Fragen, dieselben Anweisungen und Grenzen, ein leeres QGIS-Projekt und 3 Versuche. Googles eigener Scoring-Code bewertete jede Antwort.
- Wir haben das Plugin mit Effort Low (GPT-6 Luna, im kostenlosen Tarif) und mit Effort High (ein anderes Modell, das tiefer plant, mit Pro) laufen lassen. Low erreichte bei beiden Benchmarks mehr, daher ist jeder gezeigte Wert Low.
- Claude Sonnet 5.5 lief am 18. Oktober in Claude Code mit dem QGIS-MCP-Plugin von nkarasiak, Version 0.15.1, mit abgeschalteten eigenen Shell-, Web- und Dateiwerkzeugen. GPT-6 Luna + QGIS MCP lief am 16. und 17. Oktober in der Codex CLI von OpenAI mit dem qgis_mcp-Server von jjsantos01. GPT-6 Luna allein antwortete ohne Werkzeuge.
Technische Details
Benchmarks: GeoKTools und GeoExpertQueries aus google-research/geospatial-reasoning-benchmarks, Commit c21a6d95, Daten unter CC BY 4.0. Der öffentliche Dev-Split (85 Fragen von GeoKTools, 25 von GeoExpertQueries) wurde nach Fragevorlage in zwei Hälften geteilt; die zurückgehaltene Hälfte hat 39 Fragen von GeoKTools und 11 von GeoExpertQueries. Vor der Aufteilung hatten wir die Referenzantworten von zwei Vorlagen von GeoKTools geprüft, Extrempunkt einer Fläche und Wasserstress rund um einen Punkt; ihre 9 Fragen fielen in die zurückgehaltene Hälfte und fehlen in jedem Wert, sodass 30 Fragen von GeoKTools und 11 von GeoExpertQueries bleiben. Jedes System bekam Googles Prompt-Präfix, höchstens 100 Modellaufrufe und 30 Minuten pro Frage sowie 3 vollständige Läufe; ein fehlgeschlagener oder abgelaufener Lauf zählt 0. Scorer, unverändert: deterministischer Scorer von GeoKTools (10 % Toleranz bei Zahlen, Teilpunkte, ROUGE-L bei Text); Report-Protokoll von GeoKTools (exakte Übereinstimmung, sonst ein Richter mit Gemini 3.8 Flash); Tool-unabhängiger Autorater von GeoExpertQueries (Gemini 3.8 Flash, 3 Richterläufe pro Antwort). Das 95-%-Intervall ist ein gepaarter Bootstrap über die Fragen. Läufe: das Plugin mit Effort Low und High am 20. Oktober 2026; Claude + QGIS MCP am 18. Oktober; GPT-6 Luna allein am 19. Oktober. Die Werkzeugaufrufe jedes Versuchs wurden auf Lesezugriffe auf das Benchmark-Repository, seine Fragendatei oder das Paper geprüft, und ein Treffer zählt 0: Beim Plugin gab es keinen, bei den Läufen mit GPT-6 Luna + QGIS MCP 2. Fehlgeschlagene, verweigerte oder abgelaufene Versuche zählen 0 und bleiben in den Durchschnitten (7 von 150 bei GPT-6 Luna + QGIS MCP, keiner der 150 des Plugins mit Low).
GeoBenchX: Solirinai/GeoBenchX bei Commit 0edf6109, MIT-Lizenz, 202 Aufgaben, beschrieben in arXiv:2503.18129. Wir haben 23 Aufgaben weggelassen, die ein veröffentlichtes Audit ausschließt, 3 Kontrollfragen und 16, deren Referenzlösung sich nicht reproduzieren lässt oder eine Zahl verlangt, die die Referenz nicht berechnet, sodass 160 bleiben. AI Agent bearbeitete jede Aufgabe in zwei getrennten Läufen mit Effort Low am 20. Oktober 2026, in QGIS, mit den Daten der Aufgabe in einem Ordner neben einem leeren Projekt: 65,0 % (95-%-Intervall 56,9 bis 72,5) und 60,6 %. Im ersten Lauf löste es 46 der 92 Aufgaben mit Antwort, lehnte 55 der 62 unlösbaren ab und bestand 3 der 6, die beides akzeptieren. Per Code bewertet, ohne KI-Richter, anhand der nachgespielten Referenzlösung: die Werte, die die Karte zeigt, Objektzahlen, die in der Antwort genannte Zahl oder gar keine Karte bei unlösbaren Aufgaben.
GS-QA2: Zoe/GS-QA2 bei Revision 0ccf9453, von Shang et al. (UC Riverside), ODbL 1.0, © OpenStreetMap contributors; ASTER GDEM ist ein Produkt von METI und NASA. 245 Fragen, 5 aus jeder von 49 Vorlagen, nach derselben Regel gezogen wie in der Tabelle von Axis Spatial, aber nicht dieselben Fragen. Drei Settings, je 3 Läufe: AI Agent mit Effort Low mit den OpenStreetMap-Tabellen und der ASTER-Höhe des Benchmarks, auf die Gebiete der Fragen zugeschnitten, in einem Ordner neben einem leeren Projekt, wobei der Prompt nur sagt, wo die Daten liegen (61,1, 95-%-Intervall 57,1 bis 65,2); AI Agent mit Effort Low aus einem leeren Projekt mit Live-Daten (22,0, 19,0 bis 25,2); GPT-6 Luna allein, ein Aufruf ohne Werkzeuge (15,1, 12,2 bis 18,1). Die endgültige Antwort wird mit den Toleranzen des Papers gegen jede Referenzzeile geprüft: Namen nach Token-Überlappung, Orte auf 5 m, Peilung, Exposition und Neigung auf 5°, Höhe auf 10 m, Entfernungen, Flächen und Anzahlen auf 5 %.
Was zeigen diese Ergebnisse nicht?
- Unser Lauf, auf öffentlichen Fragen. Google hält seine Testfragen zurück. Diese Werte stammen von den öffentlichen Fragen, von uns mit Googles Code ausgeführt und bewertet.
- 41 Fragen, nicht 50. Unsere Ankündigungsbeiträge nennen 52,9, den Wert des Plugins im Report-Protokoll auf allen 50 zurückgehaltenen Fragen. Darin stecken die 9 aus den Vorlagen, die wir untersucht hatten, daher lassen alle Werte auf dieser Seite sie weg.
- Kleine Stichproben. GeoExpertQueries hat 11 zurückgehaltene Fragen, und jeder Fragetyp von GeoKTools hat 3 bis 5, sodass eine Frage diese Werte stark verschiebt. Zitieren Sie den Vergleich über alle 41 Fragen.
- Nur die Agenten, die wir getestet haben. Wir haben drei Setups verglichen: Claude Sonnet 5.5 und GPT-6 Luna, jeweils über einen Community-QGIS-MCP-Server, und GPT-6 Luna allein. Andere Modelle, andere MCP-Server und Googles eigener Agent aus dem Paper gehören nicht zu diesem Vergleich.
- Kein direkter Vergleich bei GeoBenchX oder GS-QA2. Veröffentlichte Werte zu diesen Benchmarks nutzen andere Aufgabensätze und andere Bewerter, daher reihen wir AI Agent nicht gegen sie ein.
Wie installiert man das AI Agent QGIS-Plugin?
Das AI Agent QGIS-Plugin ist kostenlos im offiziellen QGIS-Plugin-Repository erhältlich, für QGIS 3.28 und höher, QGIS 4 eingeschlossen. Öffnen Sie in QGIS Plugins, dann Manage and Install Plugins, suchen Sie nach AI Agent von TerraLab, installieren Sie es und melden Sie sich an. Sie brauchen keinen API-Schlüssel und keine Karte.
Der kostenlose Tarif umfasst 5 Aufgaben pro Monat mit Effort Low, der Einstellung hinter jedem Wert oben. Medium und High gibt es mit Pro. Der komplette Leitfaden führt durch eine erste Aufgabe, und was ein KI-Agent in QGIS ist erklärt die Idee.
FAQ
Was ist der beste KI-Agent für QGIS?
Von allen KI-Agenten, die wir in QGIS auf Googles Geo-Benchmarks getestet haben, erzielte das AI Agent QGIS-Plugin von TerraLab den höchsten Wert: 43,8 von 100 bei 41 zurückgehaltenen Fragen, gegenüber 24,9 für Claude Sonnet 5.5 mit einem QGIS-MCP-Server und 22,1 für GPT-6 Luna mit einem QGIS-MCP-Server. Es ist ein kostenloses Plugin im offiziellen QGIS-Plugin-Repository.
Welche KI ist am besten für GIS-Analysen?
Für Analysen in QGIS hatte das AI Agent QGIS-Plugin den höchsten Wert der von uns getesteten Agenten auf Googles Benchmarks GeoKTools und GeoExpertQueries. Werkzeuge für andere GIS-Software, etwa die GeoAI-Werkzeuge von Esri für ArcGIS, haben wir nicht getestet.
Kann ChatGPT in QGIS arbeiten?
ChatGPT allein antwortet aus dem Gedächtnis und kann QGIS nicht bedienen. Über einen QGIS-MCP-Server in Codex von OpenAI verbunden, erreichte GPT-6 Luna 39,5 auf GeoKTools und 8,6 auf GeoExpertQueries, ungefähr so viel wie dasselbe Modell ohne Werkzeuge. Im AI Agent QGIS-Plugin erreichte dasselbe Modell 53,5 und 62,6.
Kann Claude mit QGIS arbeiten?
Ja, über einen QGIS-MCP-Server wie das QGIS-MCP-Plugin von nkarasiak. In unserem Test erreichte Claude Sonnet 5.5 mit diesem Server 33,3 auf GeoKTools und 29,3 auf GeoExpertQueries; das AI Agent QGIS-Plugin erreichte 53,5 und 62,6 und war bei 26 der 41 Fragen besser.
Was ist ein QGIS-MCP-Server?
Eine Brücke, über die ein Chat-Modell wie Claude oder ChatGPT QGIS-Funktionen über das Model Context Protocol aufrufen kann. Das Modell kann dann QGIS bedienen, muss aber die Daten allein finden und seine Arbeit allein prüfen. Unser QGIS-MCP-Leitfaden vergleicht die Server.
Was sind Googles Geo-Reasoning-Benchmarks?
GeoKTools und GeoExpertQueries, von Google Research im Oktober 2026 zusammen mit seinem Paper zum Google Earth AI Geospatial Reasoning Agent veröffentlicht (arXiv:2610.15750). GeoKTools stellt Sachfragen, die ein bis vier Arten von Geodaten brauchen; GeoExpertQueries stellt offene Analystenprobleme, bewertet anhand von Arbeitsabläufen, die Fachleute geschrieben haben.
Gibt es einen Benchmark, der KI-Agenten für GIS vergleicht?
Ja, mehrere. Googles GeoKTools und GeoExpertQueries, GeoBenchX, GS-QA2, GISAgentBench und GeoNatureAgent testen alle Agenten bei Geoaufgaben, jeweils mit eigenen Fragen und eigenem Bewerter, daher lassen sich ihre Werte nicht über Benchmarks hinweg vergleichen.
Wie schneidet AI Agent in anderen Geo-Benchmarks ab?
Bei GeoBenchX, einem öffentlichen Benchmark für mehrstufige GIS-Aufgaben, bestand es 62,8 % von 160 Aufgaben über zwei Läufe. Bei GS-QA2, räumlichen Fragen zu Orten in den USA, geprüft gegen einen festen Karten-Snapshot, erreichte es mit den eigenen Daten des Benchmarks 61,1 von 100. Kein anderer Agent lief unter denselben Bedingungen.
Ist das AI Agent QGIS-Plugin kostenlos?
Ja. Der kostenlose Tarif umfasst 5 Aufgaben pro Monat mit Effort Low, der Einstellung hinter jedem Benchmark-Wert hier, ohne API-Schlüssel und ohne Karte. Medium und High gibt es mit Pro.