Semantische Segmentierung vs. Instanzsegmentierung
Veröffentlicht am Aktualisiert am
Die semantische Segmentierung weist jedem Pixel eines Bildes eine Klasse zu: Dieses Pixel ist Gebäude, jenes ist Straße, das nächste ist Baum. Die Instanzsegmentierung geht einen Schritt weiter und trennt die Objekte einer Klasse voneinander: Dieses Pixel gehört zu Gebäude Nummer 12, jenes zu Gebäude Nummer 13.
Semantische Segmentierung und Instanzsegmentierung: der Unterschied in einer Zeile
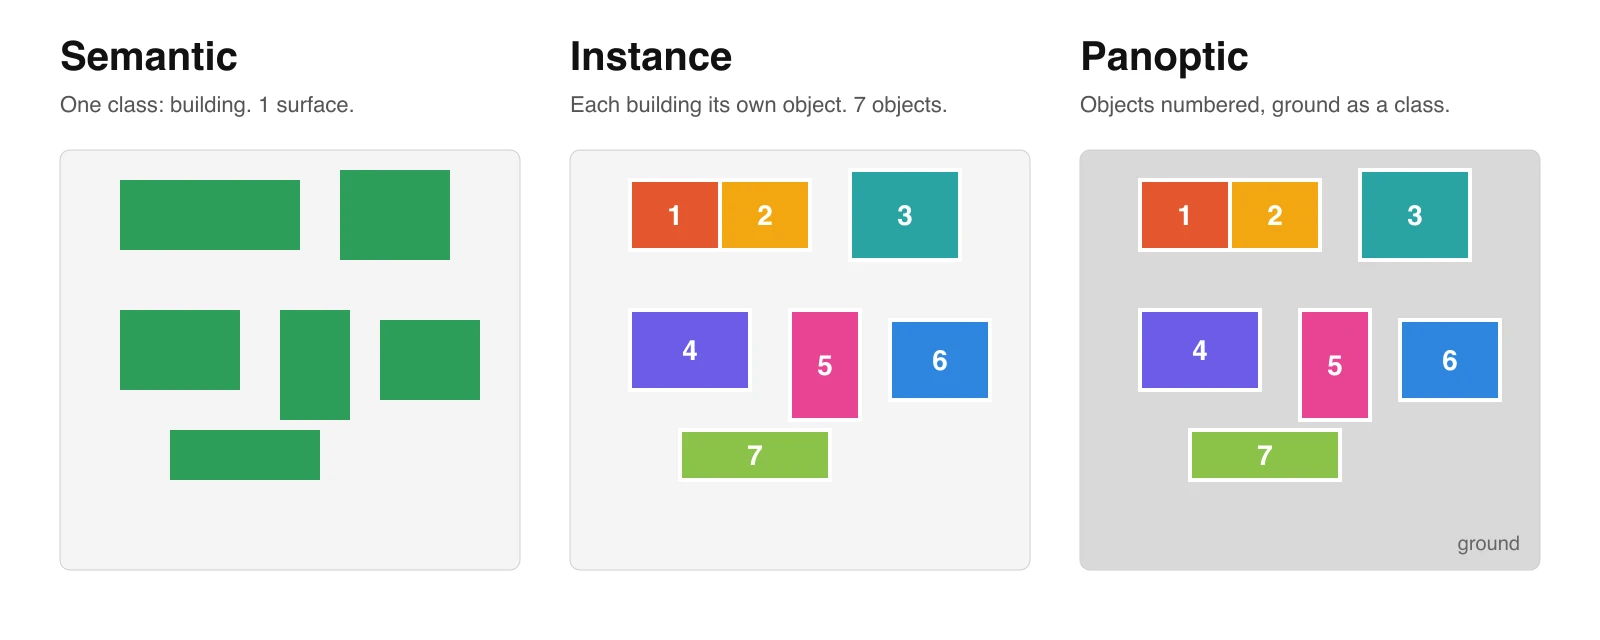
Semantisch beantwortet „wie viel“. Instanz beantwortet „wie viele, und welches“. Panoptisch, der dritte Begriff, beantwortet beides auf derselben Karte.
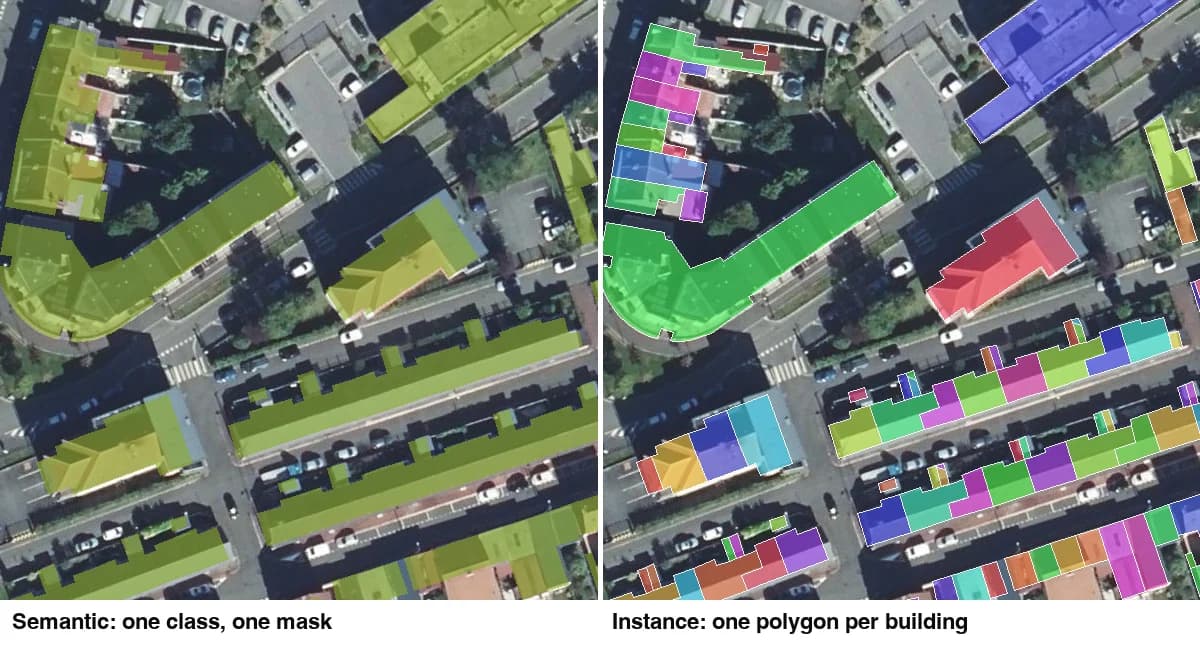
Dasselbe Bild, auf zwei Arten beschriftet. Die semantische Segmentierung färbt jedes Gebäude gleich. Die Instanzsegmentierung gibt jedem Gebäude seinen eigenen Umriss und seine eigene Nummer.
| Semantisch | Instanz | Panoptisch | |
|---|---|---|---|
| Ergebnis | Eine Klasse pro Pixel | Eine Maske pro Objekt | Eine Klasse pro Pixel, dazu eine Objekt-ID für zählbare Dinge |
| Zwei aneinandergrenzende Häuser | Eine Maske | Zwei Objekte | Zwei Objekte |
| Was als Objekt zählt | Nichts: Eine Klasse ist eine Fläche | Jedes Dach, jede Baumkrone, jeder Pool, jedes Auto | Jedes zählbare Ding; Flächen bleiben Flächen |
| Zählen möglich | Nein | Ja | Ja, für die zählbaren Klassen |
| Typischer GIS-Einsatz | Landbedeckung, Kronenbedeckung, versiegelte Fläche, Veränderungen | Bestandsaufnahmen von Gebäuden, Bäumen, Pools und Solarmodulen | Gesamtkarten einer Szene, landwirtschaftliche Parzellen |
| Typische Modelle | U-Net, DeepLab | Mask R-CNN, die Segment-Anything-Familie | Zwei Ausgabeköpfe oder ein Modell, das auf panoptischen Labels trainiert wurde |
| Als Vektor in QGIS | Vektorisieren, dann bereinigen | Schon ein Polygon pro Objekt | Klassen vektorisieren, Objekt-IDs behalten |
Was jede Variante auf einer Karte liefert
Ein semantisches Modell liefert Flächen zum Messen, ein Instanzmodell liefert Objekte zum Zählen.
Semantisch ist eine Landbedeckungskarte mit scharfen Kanten: eine Gebäudemaske, eine Straßenmaske, eine Vegetationsmaske. Das passt für Flächenstatistiken, versiegelte Flächen, Kronenbedeckung und Veränderungen zwischen zwei Zeitpunkten. Es passt nicht, sobald Sie etwas zählen müssen.
Instanz ist eine Bestandsaufnahme. Jedes Dach, jede Baumkrone und jeder Pool kommt als eigenes Polygon mit eigener Zeile in der Attributtabelle. Sie können zählen, jedes Objekt einzeln vermessen und jedem eine Höhe zuordnen. Der Preis: Das Modell muss entscheiden, wo ein Objekt endet. Das ist bei einer Reihenhauszeile schwer, und die Fehler sehen entsprechend aus: zwei Häuser zu einem verschmolzen, eine Krone in drei Teile zerlegt.
Woher die Begriffe kommen. Beide stammen aus der Bildverarbeitung (Computer Vision). 2014 zeigten Long, Shelhamer und Darrell, dass ein Netz, das „Ende-zu-Ende, Pixel zu Pixel“ trainiert wird, semantische Segmentierung leisten kann. 2017 ergänzte Mask R-CNN einen Objektdetektor um „einen Zweig zur Vorhersage einer Objektmaske“, und das ist Instanzsegmentierung. 2023 wurde Segment Anything auf „über 1 Milliarde Masken auf 11 Mio. lizenzierten und datenschutzkonformen Bildern“ trainiert. Mit dieser Familie arbeiten die Instanzwerkzeuge in QGIS heute.
Panoptische Segmentierung, der dritte Begriff
Die panoptische Segmentierung beschriftet jedes Pixel mit einer Klasse, wie die semantische, und gibt zusätzlich jedem zählbaren Objekt eine eigene ID, wie die Instanzsegmentierung. Kirillov und Kollegen benannten die Aufgabe 2018 und definierten sie als eine, die „die üblicherweise getrennten Aufgaben der semantischen Segmentierung (jedem Pixel eine Klassenbezeichnung zuweisen) und der Instanzsegmentierung (jede Objektinstanz erkennen und segmentieren) vereint“.
Die Arbeit teilt Klassen in zwei Arten. Things sind zählbar: Gebäude, Autos, Bäume. Stuff ist formlos: Gras, Wasser, Straßenbelag. Eine panoptische Karte zählt die Things und misst den Stuff, in einem Layer ohne Lücken und ohne Überlappungen. Dieselbe Arbeit schlug eine gemeinsame Kennzahl für beide vor, die panoptische Qualität (PQ), „für alle Klassen (Stuff und Things)“.
Wo GIS sie nutzt. Am klarsten ist der Fall bei landwirtschaftlichen Flächen. PASTIS, ein französischer Benchmark, umfasst 124.422 landwirtschaftliche Parzellen in 2.433 Sentinel-2-Zeitreihen mit 10 m pro Pixel und deckt rund 4.000 km² Frankreichs ab. Jedes Pixel trägt sowohl eine Kulturart als auch einen Parzellenindex. Ein semantisches Modell sagt darauf „Weizen hier“. Ein panoptisches sagt „Weizen, Parzelle 57“, sodass Sie Felder zählen und jedes einzeln vermessen können. Die zugehörige Arbeit nennt die pixelgenaue panoptische Segmentierung von Parzellen eine Aufgabe mit „erheblichen wirtschaftlichen und ökologischen Auswirkungen“.
In der Praxis braucht ein GIS-Team selten ein panoptisches Modell. Lassen Sie ein Instanzwerkzeug für die Things laufen, ein semantisches für den Stuff, und legen Sie beide Layer in QGIS übereinander. Das ergibt dieselbe Karte in zwei Schritten.
Was eine semantische Maske zählt: drei französische Kacheln im Messvergleich
Wer eine semantische Gebäudemaske vektorisiert, zählt Blöcke statt Gebäude: Auf 1 km² im Zentrum von Lens liefert die KI-Landbedeckungskarte des IGN, erstellt aus Luftbildern mit 20 cm Auflösung, 269 Gebäude-Blobs, während das nationale Gebäuderegister 3.006 Gebäude führt. Wir haben das am 23. September 2026 auf drei Kacheln von je 1 km² gemessen, jeweils gegen die Gebäude der BD TOPO des IGN geprüft.
| Auf einer Kachel von 1 km² | Lens, Stadtzentrum | Liévin, Häuser einer Bergbausiedlung | Paris, 11. Arrondissement |
|---|---|---|---|
| Gebäude in der BD TOPO (ab 20 m²) | 3.006 | 952 | 1.759 |
| Blobs in der KI-Maske mit 20 cm (IGN CoSIA) | 269 | 558 | 95 |
| Gefundene Gebäude, die sich ihren Blob teilen | 97,5 % | 63 % | 99,5 % |
| Median der Gebäude in diesem Blob | 30 | 2 | 31 |
| Blobs in der Landbedeckung mit 10 m (ESA WorldCover) | 1 | 29 | 1 |
| Fläche, KI-Maske / Grundrisse / „bebaut“ mit 10 m | 40,5 / 36,3 / 87,2 ha | 14,4 / 12,3 / 46,3 ha | 58,4 / 54,7 / 96,3 ha |
Eine feinere Maske behebt die Zählung nicht. Die Maske findet auf jeder Kachel 96 bis 97 % der Gebäude, aber eine Reihenhauszeile oder ein Wohnblock teilt sich die Wände, sodass nie ein Hintergrundpixel zwei Häuser trennt, weder bei 20 cm noch bei 2 cm. In Lens und Paris liegt ein von der Maske gefundenes Gebäude im Median in einem Blob von etwa 30.
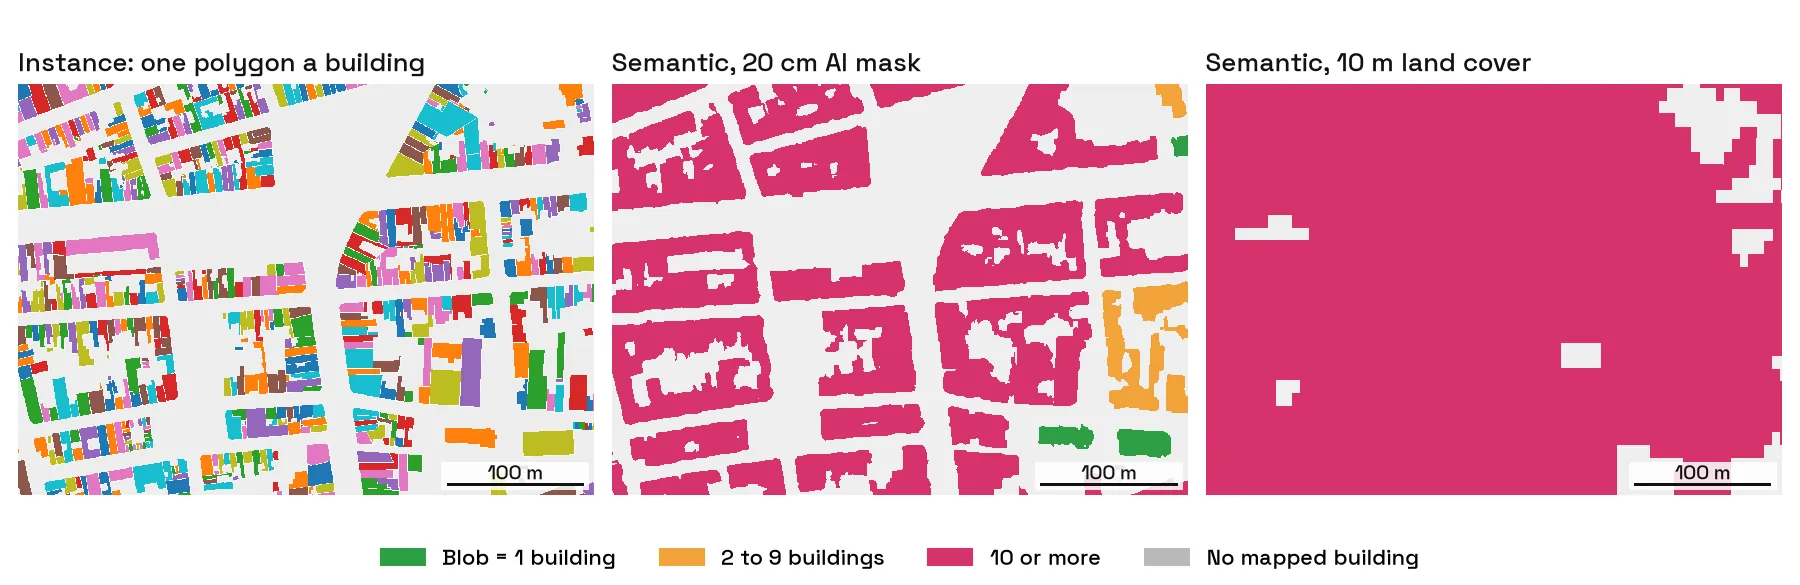
Liévin zeigt, wo eine semantische Maske richtig zählt. Freistehende Häuser kommen als je ein Blob heraus, und 344 der dort gefundenen 926 Gebäude haben einen Blob für sich allein. Die Doppelhäuser und die Zeilen der alten Bergbausiedlung kommen als je ein Blob heraus, deshalb liegt das mediane Gebäude in einem Blob von zwei.
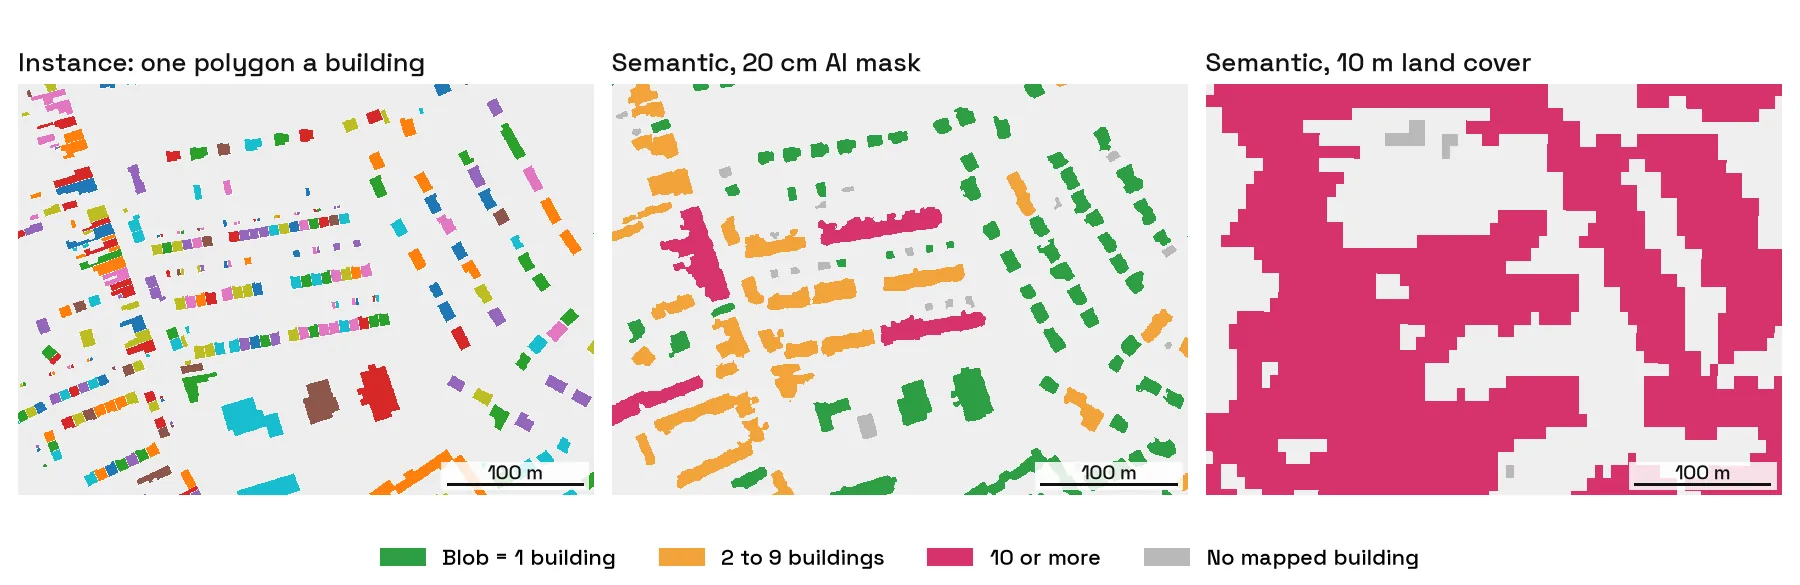
Bei der Fläche liegt die semantische Maske nah dran. Die KI-Maske liegt 7 bis 17 % über der Summe der Grundrisse. Das ist zu erwarten: Sie sieht Dächer, die über die Wände hinausragen, die die BD TOPO nachzeichnet, und kleine Nebengebäude. Die Klasse „bebaut“ mit 10 m ist das 1,8- bis 3,8-Fache der Grundrissfläche, weil ein Pixel von 10 m mit Dach, Hof und Gehweg als bebaut gilt. Sie misst Siedlungsstruktur, nicht Gebäude.
Bäume verschmelzen ebenfalls
Auf der Pariser Kachel liegen 1.296 der 1.583 Bäume aus dem städtischen Baumkataster in der Baumkronenklasse der KI-Maske (innerhalb von 2 m um den Stamm), und 89 % davon teilen sich einen Kronen-Blob mit einem weiteren erfassten Baum. Die bepflanzte Promenade am Boulevard Richard-Lenoir ist ein einziger Blob mit 254 erfassten Bäumen. Baumkronen aus einer Kronenmaske zu zählen funktioniert bei einzeln stehenden Bäumen und scheitert entlang einer bepflanzten Straße.
So haben wir gemessen
Die Kacheln sind Quadrate von 1 km in Lambert 93, zentriert auf Lens (50,432 N, 2,832 O), die Cité Pasteur in Liévin (50,433 N, 2,762 O) und den Boulevard Richard-Lenoir (48,860 N, 2,370 O). Ein Blob ist eine Gruppe aneinandergrenzender Maskenpixel ab 20 m². Das entsteht in QGIS beim Vektorisieren mit den Standardeinstellungen. Ein Gebäude gilt als gefunden, wenn die Hälfte seines Grundrisses unter der Maske liegt. CoSIA wird nur als gestaltete Karte veröffentlicht, deshalb haben wir sie mit etwa 0,4 m ausgelesen und jede Farbe wieder ihrer Klasse zugeordnet. Die wenigen Randpixel, die dabei verloren gehen, zerteilen Blobs, die genannten Anteile sind also eher zu niedrig. Die Fotos hinter CoSIA sind älter als das Register, mit dem wir sie verglichen haben. Die BD TOPO zeichnet ein Doppelhaus manchmal als ein Gebäude. Das Pariser Baumkataster lässt private Bäume aus. Drei Kacheln sind drei Orte, keine landesweite Zahl.
Von der Maske zu Polygonen in QGIS
Eine semantische Maske braucht drei bis vier Verarbeitungsschritte, bis daraus brauchbare Polygone werden. Ein Instanzwerkzeug liefert die Polygone direkt. Hier ist jeder Weg mit den QGIS-Werkzeugen, die ihn gehen.
Aus einer semantischen Maske
- Rauschen entfernen. Starten Sie
Raster > Analyse > Sieb…(englische Oberfläche:Raster > Analysis > Sieve). Das Werkzeug „entfernt Rasterpolygone, die kleiner als ein vorgegebener Schwellenwert (in Pixeln) sind“ und füllt sie mit dem Wert des größten Nachbarn, laut QGIS-Handbuch. Der Standardschwellenwert liegt bei 10 Pixeln. Bei 20 cm sind 10 Pixel nur 0,4 m², erhöhen Sie ihn also passend zum kleinsten Objekt, das Sie interessiert. - Vektorisieren. Starten Sie
Raster > Konvertierung > Vektorisieren (Raster nach Vektor)…(englische Oberfläche:Raster > Conversion > Polygonize (Raster to Vector)). Das Werkzeug „erzeugt Vektorpolygone für alle zusammenhängenden Bereiche von Pixeln im Raster mit gleichem Pixelwert“, wobei der Wert standardmäßig in einem Feld namensDNsteht, laut Handbuch. Lassen Sie „8-Konnektivität verwenden“ ausgeschaltet. Ist es eingeschaltet, verbinden sich zwei Pixel, die sich nur an einer Ecke berühren, und zwei Gebäude, die sich an einer Ecke treffen, werden zu einem Polygon. - Die Klasse behalten. Auch Hintergrundpixel bilden Polygone. Wählen Sie
"DN" = 1(oder Ihren Klassenwert) aus und speichern Sie die Auswahl als neuen Layer. - Festlegen, was ein Objekt bedeutet. Für eine Klassenfläche starten Sie
Vektor > Geoverarbeitungswerkzeuge > Auflösen…ohne Feld: Sie erhalten ein Mehrteilobjekt und eine einzige Flächenzahl. Für Blobs haken Sie „Disjunkte Objekte getrennt halten“ an (ab QGIS 3.32) oder startenMultipart zu Singlepartsaus der Werkzeugkiste, und jeder Blob wird zu einer eigenen Zeile. - Kanten bereinigen. Pixelkanten kommen als Treppen heraus. Die Anleitung zum Umwandeln von Raster in Vektor behandelt Vereinfachen, Glätten und einen Flächenfilter.
Nach Schritt 4 haben Sie ein Polygon pro Blob, nicht pro Objekt. Die Tabelle zu Lens oben zeigt, wie groß dieser Unterschied ist: 269 Blobs für 3.006 Gebäude.
So entstehen auch große Gebäudegrundriss-Datensätze. Die globalen Gebäudegrundrisse von Microsoft entstehen in zwei Stufen: „Semantic Segmentation“, das Erkennen von Gebäudepixeln mit tiefen neuronalen Netzen, dann „Polygonization“, das Umwandeln dieser Pixel in Polygone. Ein Pixel gilt als Gebäude, wenn seine Wahrscheinlichkeit über 0,5 liegt. Im Polygonschritt geschieht die Trennung in einzelne Gebäude, und das ist Mehrarbeit, die ein semantisches Modell Ihnen überlässt.
Aus einem Instanzwerkzeug
- Das Werkzeug auf eine Zone anwenden. Jedes Objekt kommt als eigenes Polygon, eine Zeile in der Attributtabelle.
- Auf Mehrteilobjekte prüfen. Manche Werkzeuge liefern ein Objekt in mehreren Teilen.
Multipart zu Singlepartsteilt sie auf. Prüfen Sie die geteilten Objekte, bevor Sie zählen. - Jedes Objekt vermessen. Fügen Sie im Feldrechner ein Feld mit
$areahinzu und filtern Sie Splitter heraus, die kleiner sind als das kleinste echte Objekt. - Vorhandenes Wissen anfügen. Jedes Polygon kann per räumlicher Verknüpfung eine Höhe, eine Adresse oder eine Register-ID erhalten, was eine Klassenfläche nicht kann.
Mit AI Segmentation fallen die Schritte 1 bis 3 in einen zusammen: „Gebäude“ oder „Swimmingpool“ eingeben, eine Zone wählen, und jedes gefundene Objekt kommt als eigenes Polygon in einem neuen Layer zurück. Mit AI Agent läuft der semantische Weg von oben mit einem Satz in einem Chat-Bedienfeld in QGIS: Sie beschreiben den gewünschten Layer, und das Bedienfeld führt dieselben QGIS-Werkzeuge aus, Sieb, Vektorisieren und Auflösen, und prüft die Karte, bevor es antwortet.
Welche Variante die QGIS-Werkzeuge liefern
Die meisten QGIS-Plugins auf Basis von Landbedeckungsmodellen sind semantisch, die Werkzeuge auf Basis von Segment Anything sind Instanzwerkzeuge.
- Semantisch: Deepness und die meisten Modelle in seinem Modellzoo, das Semi-Automatic Classification Plugin, das Landbedeckungsmodell von Mapflow.
- Instanz: die Segment-Anything-Familie, also Geo-SAM, samgeo und die SAM-Plugins für QGIS. Ein Objekt pro Klick.
- AI Segmentation, das Plugin, das wir bei TerraLab für QGIS entwickeln, ist ein Instanzwerkzeug. Sie benennen das Objekt, ein Gebäude, einen Baum, einen Pool, oder zeichnen ein Beispiel dafür, und es liefert ein Polygon pro Objekt, das in der Zone gefunden wurde. Der Leitfaden zu Gebäudegrundrissen zeigt, wie das in einem dichten Block aussieht. Wo die Gebäude bereits kartiert sind, liefert der kostenlose Download für Gebäudegrundrisse diese Instanzpolygone als GeoJSON, ohne dass Sie etwas ausführen müssen.
 entwickeln, ist ein Instanzwerkzeug. Sie benennen das Objekt, ein Gebäude, einen Baum, einen Pool, oder zeichnen ein Beispiel dafür, und es liefert ein Polygon pro Objekt, das in der Zone gefunden wurde. Der
Häufige Fragen
Die kurzen Antworten unten decken ab, wonach Leute im Umfeld dieser beiden Begriffe als Nächstes suchen.
Was ist der Unterschied zwischen semantischer, Instanz- und panoptischer Segmentierung?
Die semantische Segmentierung weist jedem Pixel eine Klasse zu. Die Instanzsegmentierung trennt jedes Objekt einer Klasse in eine eigene Maske. Die panoptische Segmentierung leistet beides zugleich: Jedes Pixel erhält eine Klasse, und jedes zählbare Objekt, etwa ein Gebäude oder ein Auto, erhält zusätzlich eine eigene ID.
Welche Variante sollte ich für ein GIS-Projekt verwenden?
Nehmen Sie die semantische, wenn die Antwort eine Fläche oder ein Anteil ist: Kronenbedeckung, versiegelte Fläche, überflutetes Land. Nehmen Sie die Instanzsegmentierung, wenn die Antwort eine Anzahl oder ein Attribut pro Objekt ist: Gebäude, Bäume, Pools, Solarmodule. Brauchen Sie beides, lassen Sie je eines laufen und legen Sie die Layer übereinander.
Ist Objekterkennung dasselbe wie Instanzsegmentierung?
Nein. Die Objekterkennung liefert ein Rechteck um jedes Objekt. Die Instanzsegmentierung liefert seinen Umriss, Pixel für Pixel. Für eine Karte wollen Sie fast immer den Umriss.
Kann ich eine semantische Maske in Instanzen umwandeln?
Manchmal. Vektorisieren Sie die Maske und teilen Sie die Polygone dann an ihren Engstellen. Das klappt bei getrennten Dingen wie Baumkronen in einer Obstplantage. Bei einer Reihenhauszeile scheitert es, weil es keine Engstelle gibt, an der sich schneiden ließe.
Verändert die Auflösung der Bilddaten das Ergebnis?
Ja, aber weniger, als man erwartet. Bei 10 m ist ein Haus ein oder zwei Pixel groß, und es gibt nichts zu trennen, deshalb ist Landbedeckung aus Satellitenbildern notgedrungen semantisch. Bei 20 cm besteht ein Haus aus Tausenden Pixeln, und die Instanzsegmentierung wird möglich. Eine semantische Maske mit 20 cm verschmilzt dennoch jedes Haus, das eine Wand teilt: Im Zentrum von Lens teilen sich 97,5 % der von ihr gefundenen Gebäude einen Blob.
Warum ergibt meine vektorisierte Maske ein Polygon für einen ganzen Block?
Weil die Häuser in diesem Block Wände teilen und deshalb in der Maske kein Hintergrundpixel zwischen ihnen liegt. Das Vektorisieren verbindet jedes zusammenhängende Pixel mit gleichem Wert zu einem Polygon. Nur ein Instanzmodell, das jedes Objekt für sich zeichnet, trennt sie.
Ist Segment Anything Instanzsegmentierung?
Ja, was die Ausgabe betrifft: Es liefert eine Maske pro Objekt, auf das Sie zeigen, zwei aneinandergrenzende Dächer kommen also als zwei Masken zurück. Das ursprüngliche Modell vergibt allerdings keine Klassenbezeichnung. Es trennt Objekte, ohne sie zu benennen, und die darauf aufbauenden QGIS-Werkzeuge übernehmen die Klasse aus Ihrem Klick oder Ihrem Prompt.
Sowohl die semantische als auch die Instanzsegmentierung gehören zur größeren Kategorie GeoAI. Was GeoAI bedeutet erklärt den Begriff, für den diese beiden Verfahren Beispiele sind. Baumkronen kartieren zeigt beide Seiten an Bäumen: Kronenbedeckung aus einer Maske oder ein Polygon pro Krone. Der QGIS-AI-Hub bündelt, was KI in QGIS kann und was nicht.