Segmentazione semantica e per istanze nelle immagini aeree
Pubblicato il Aggiornato il
La segmentazione semantica assegna una classe a ogni pixel di un'immagine: questo pixel è edificio, quello è strada, il prossimo è albero. La segmentazione per istanze fa un passo in più e separa tra loro gli oggetti di una stessa classe: questo pixel è l'edificio numero 12, quello è l'edificio numero 13.
La differenza in una riga
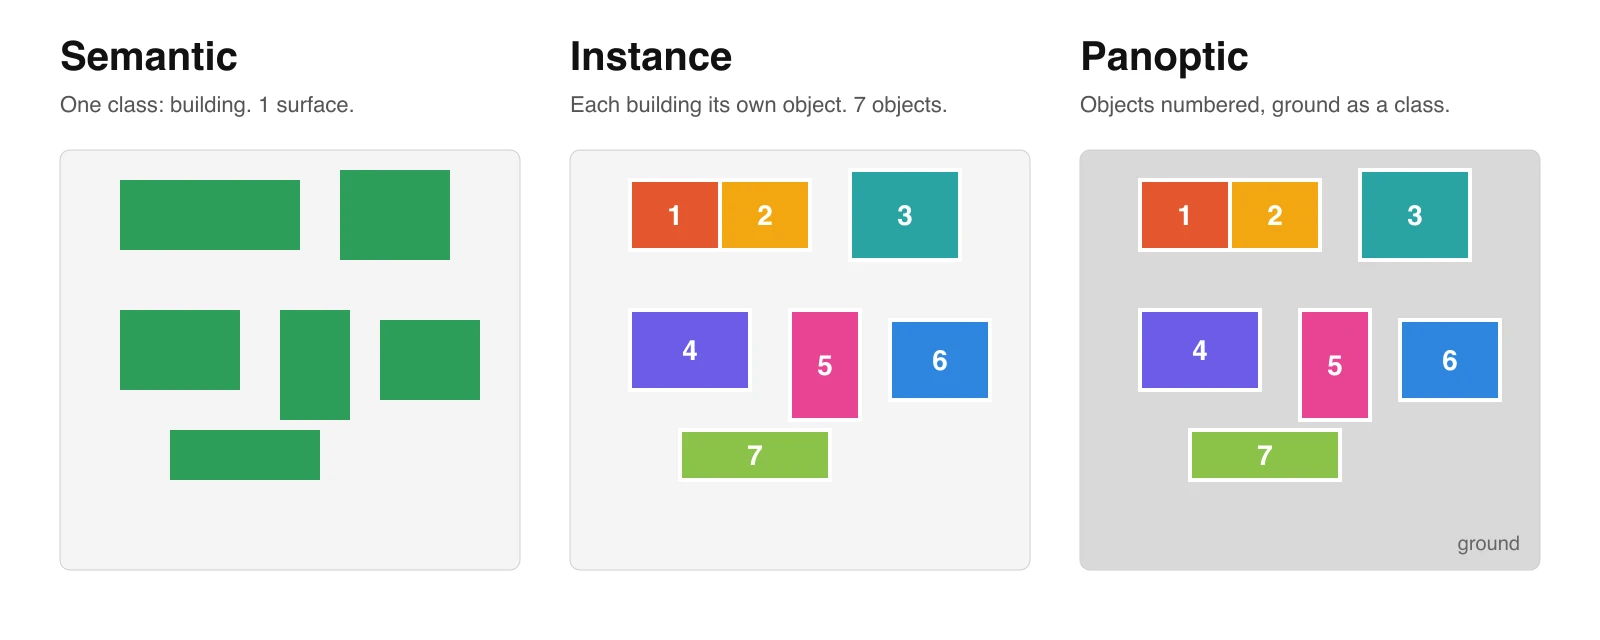
La semantica risponde a "quanto". Le istanze rispondono a "quanti, e quale". La panottica, il terzo termine, risponde a entrambe sulla stessa mappa.
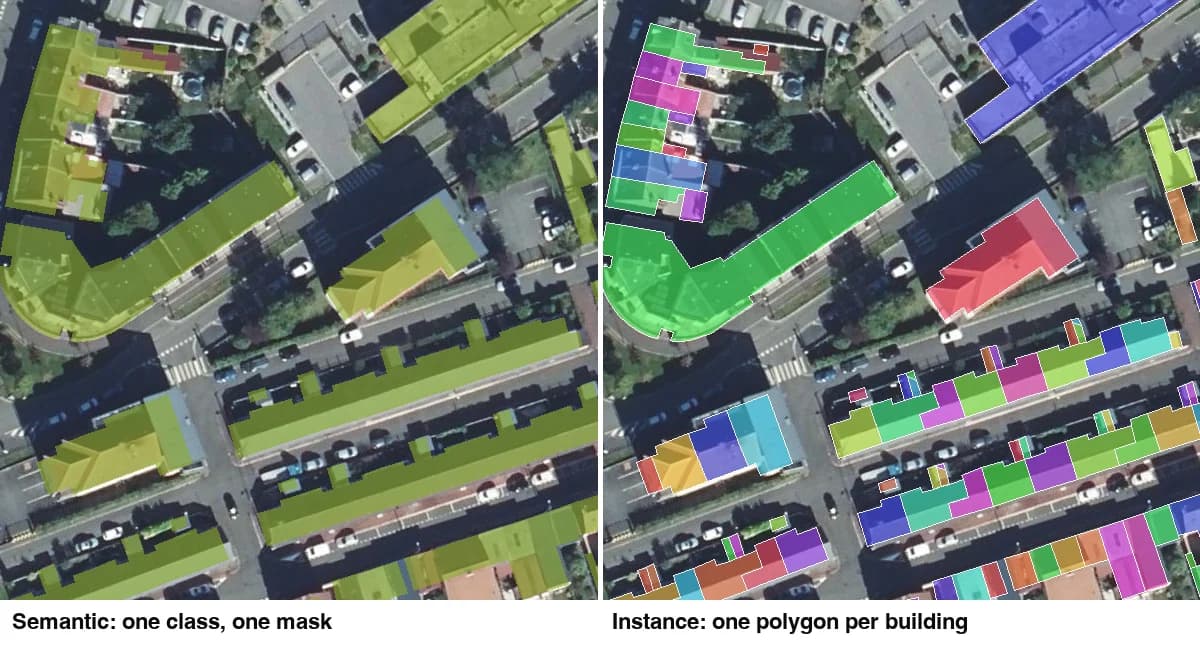
Ecco la stessa immagine etichettata in due modi. La segmentazione semantica colora tutti gli edifici con lo stesso colore. Quella per istanze dà a ciascuno il proprio contorno e il proprio numero.
| Semantica | Per istanze | Panottica | |
|---|---|---|---|
| Output | Una classe per pixel | Una maschera per oggetto | Una classe per pixel, più un ID oggetto sulle cose numerabili |
| Due case a contatto | Una maschera | Due oggetti | Due oggetti |
| Cosa conta come oggetto | Niente: una classe è una superficie | Ogni tetto, chioma, piscina o auto | Ogni cosa numerabile; le superfici restano superfici |
| Si può contare | No | Sì | Sì, per le classi numerabili |
| Uso tipico in GIS | Copertura del suolo, quota di chioma, superficie impermeabile, cambiamenti | Inventari di edifici, alberi, piscine e pannelli | Mappe complete della scena, particelle agricole |
| Modelli tipici | U-Net, DeepLab | Mask R-CNN, la famiglia Segment Anything | Due teste, oppure un solo modello addestrato su etichette panottiche |
| Verso il vettoriale in QGIS | Poligonizzazione, poi pulizia | Già un poligono per oggetto | Poligonizza le classi, conserva gli ID degli oggetti |
Cosa ti danno sulla mappa
Un modello semantico ti dà superfici da misurare, un modello per istanze ti dà oggetti da contare.
Semantica è una mappa di copertura del suolo con i bordi netti: una maschera degli edifici, una delle strade, una della vegetazione. Va bene per statistiche di area, superficie impermeabile, copertura arborea, cambiamenti tra due date. Non va bene per tutto ciò che richiede un conteggio.
Per istanze è un inventario. Ogni tetto, chioma o piscina arriva come poligono a sé, con la sua riga nella tabella attributi. Puoi contare, misurare ciascun oggetto, associare a ciascuno un'altezza. Il prezzo è che il modello deve decidere dove finisce un oggetto, cosa difficile su una schiera di case, e gli errori si vedono: due case fuse in una, una chioma spezzata in tre.
Da dove vengono i nomi. Sono entrambi termini di computer vision. Nel 2014 Long, Shelhamer e Darrell hanno mostrato che una rete addestrata “end-to-end, pixels-to-pixels” poteva fare segmentazione semantica. Nel 2017 Mask R-CNN ha aggiunto a un rilevatore di oggetti “un ramo per predire la maschera di un oggetto”, cioè la segmentazione per istanze. Nel 2023 Segment Anything è stato addestrato su “oltre 1 miliardo di maschere su 11 milioni di immagini con licenza e rispettose della privacy”, ed è la famiglia su cui girano oggi gli strumenti per istanze di QGIS.
Segmentazione panottica, il terzo termine
La segmentazione panottica assegna una classe a ogni pixel, come la semantica, e dà anche a ogni oggetto numerabile un proprio ID, come quella per istanze. Kirillov e colleghi hanno dato un nome al compito nel 2018 e lo hanno definito come quello che “unifica i compiti tipicamente distinti della segmentazione semantica (assegnare un'etichetta di classe a ogni pixel) e della segmentazione per istanze (rilevare e segmentare ogni istanza di oggetto)”.
L'articolo divide le classi in due tipi. Le cose (things) sono numerabili: edifici, auto, alberi. Lo sfondo (stuff) è amorfo: erba, acqua, superficie stradale. Una mappa panottica conta le cose e misura lo sfondo, in un unico layer senza vuoti né sovrapposizioni. Lo stesso articolo ha proposto un unico punteggio per entrambi, la qualità panottica (PQ), “per tutte le classi (sfondo e cose)”.
Dove la usa il GIS. Il caso più chiaro sono i campi agricoli. PASTIS, un benchmark francese, contiene 124.422 particelle agricole su 2.433 serie temporali Sentinel-2 a 10 m per pixel, per circa 4.000 km² di Francia. Ogni pixel porta sia un tipo di coltura sia un indice di particella. Un modello semantico dice "grano qui". Uno panottico dice "grano, particella 57", così puoi contare i campi e misurarli uno per uno. L'articolo che lo accompagna definisce la segmentazione panottica delle particelle a livello di pixel un compito con “importanti implicazioni economiche e ambientali”.
In pratica, un team GIS raramente ha bisogno di un modello panottico. Usa uno strumento per istanze per le cose, uno semantico per lo sfondo e sovrapponi i due layer in QGIS. Ottieni la stessa mappa in due passaggi.
Cosa conta una maschera semantica: tre tasselli francesi, misurati
Se poligonizzi una maschera semantica degli edifici conti blocchi, non edifici: su 1 km² del centro di Lens, la mappa di copertura del suolo AI dell'IGN, prodotta da foto aeree a 20 cm, dà 269 blob di edifici dove il registro nazionale degli edifici ne conta 3.006. Lo abbiamo misurato il 23 settembre 2026 su tre tasselli di 1 km², ciascuno confrontato con gli edifici BD TOPO dell'IGN.
| Su un tassello di 1 km² | Lens, centro città | Liévin, case dei minatori | Parigi 11° |
|---|---|---|---|
| Edifici in BD TOPO (20 m² o più) | 3.006 | 952 | 1.759 |
| Blob nella maschera AI a 20 cm (IGN CoSIA) | 269 | 558 | 95 |
| Edifici trovati che condividono il blob | 97,5% | 63% | 99,5% |
| Mediana di edifici in quel blob | 30 | 2 | 31 |
| Blob nella copertura del suolo a 10 m (ESA WorldCover) | 1 | 29 | 1 |
| Area, maschera AI / impronte / “costruito” a 10 m | 40,5 / 36,3 / 87,2 ha | 14,4 / 12,3 / 46,3 ha | 58,4 / 54,7 / 96,3 ha |
Una maschera più fine non risolve il conteggio. La maschera trova dal 96 al 97% degli edifici di ogni tassello, ma una casa a schiera o un condominio condividono i muri, quindi nessun pixel di sfondo separa mai due case, né a 20 cm né a 2 cm. A Lens e a Parigi un edificio trovato dalla maschera sta, in mediana, in un blob di circa 30.
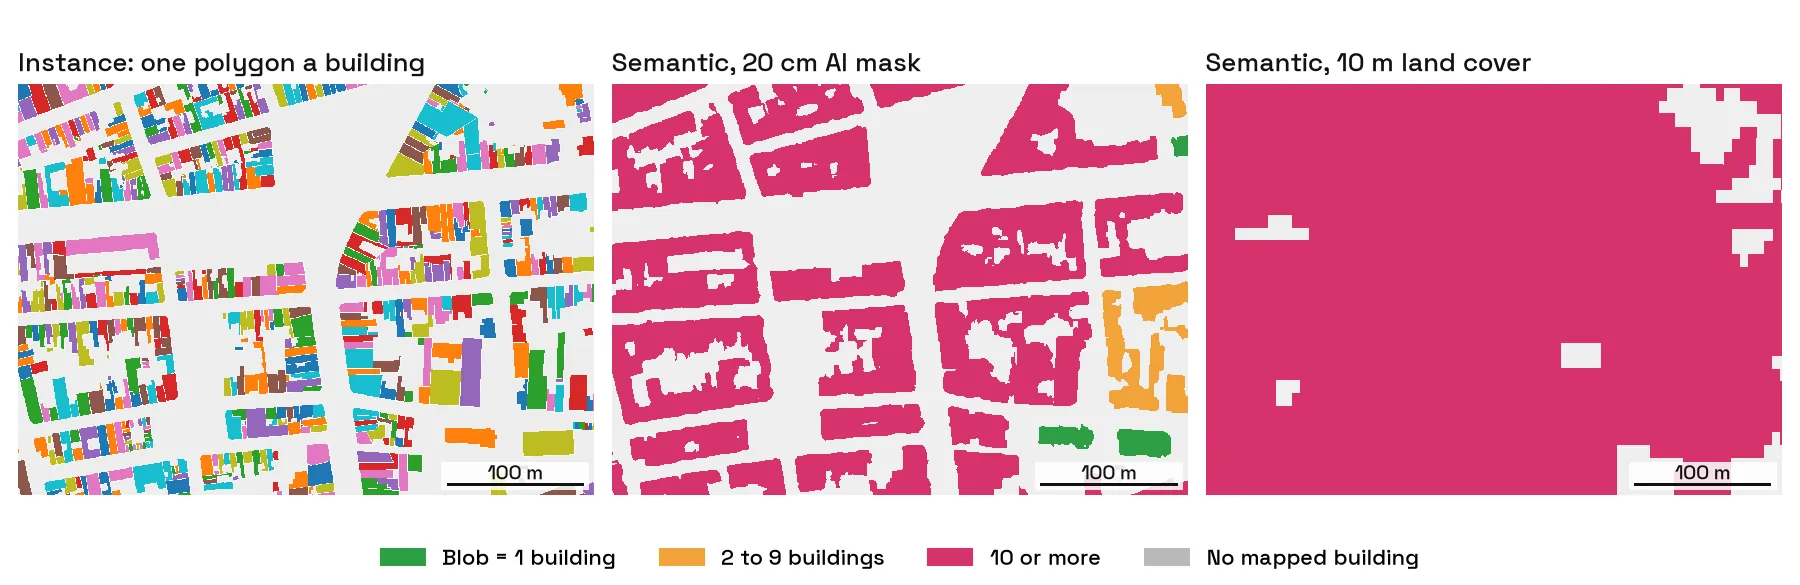
Liévin mostra dove una maschera semantica conta bene. Le case isolate escono come un blob ciascuna, e 344 dei 926 edifici trovati lì hanno un blob tutto per sé. Le case bifamiliari e le schiere del vecchio quartiere minerario escono come un blob ciascuna, ed è per questo che l'edificio mediano sta in un blob di due.
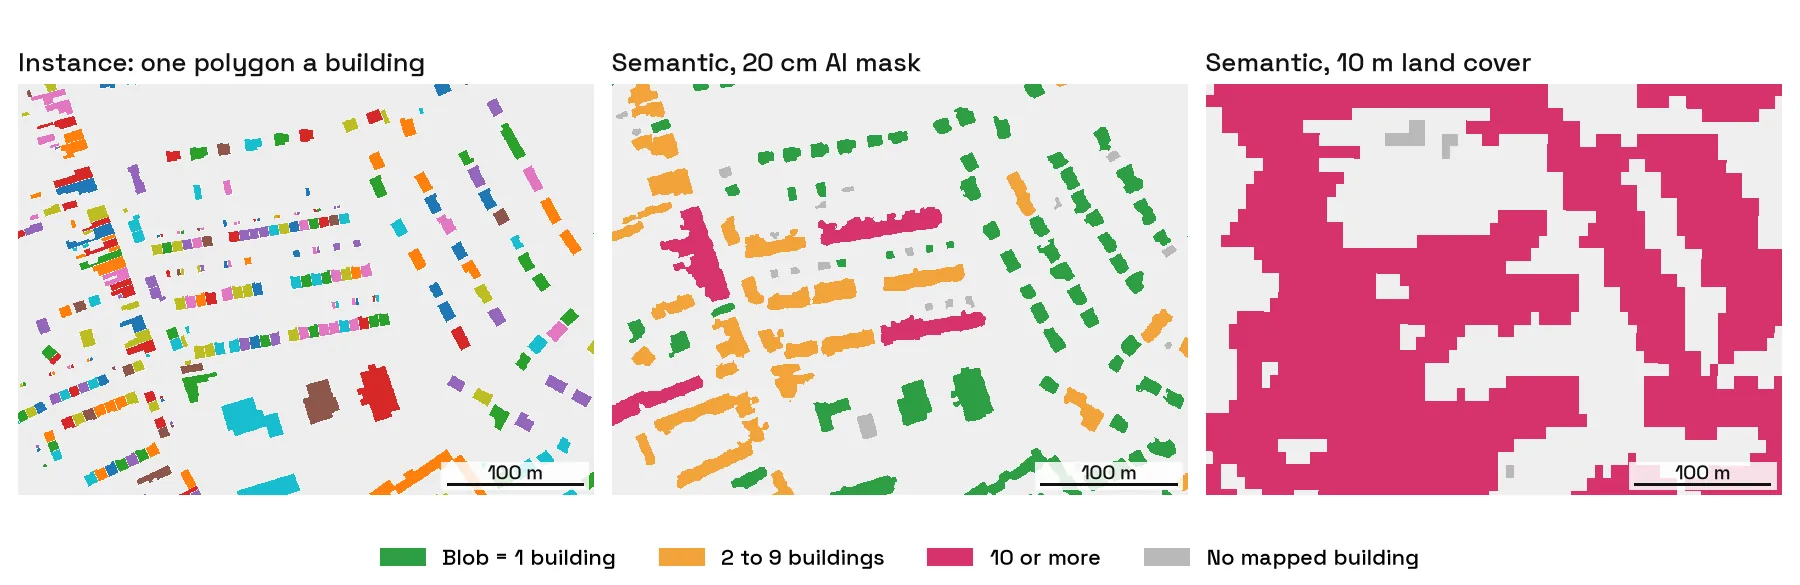
Per l'area la maschera semantica è vicina. La maschera AI risulta dal 7 al 17% sopra la somma delle impronte, com'è prevedibile: vede i tetti, che sporgono oltre i muri tracciati da BD TOPO, e i piccoli annessi. La classe “costruito” a 10 m vale da 1,8 a 3,8 volte l'area delle impronte, perché un pixel di 10 m che contiene un tetto, un cortile e un marciapiede viene etichettato come costruito. Misura il tessuto urbano, non gli edifici.
Anche gli alberi si fondono
Sul tassello di Parigi, 1.296 dei 1.583 alberi censiti dal Comune cadono nella chioma della maschera AI (entro 2 m dal tronco), e l'89% di essi condivide un blob di chioma con un altro albero censito. Il viale alberato lungo boulevard Richard-Lenoir è un unico blob che contiene 254 alberi censiti. Contare le chiome da una maschera di copertura arborea funziona per gli alberi isolati e fallisce lungo una strada alberata.
Come l'abbiamo misurato
I tasselli sono quadrati di 1 km in Lambert 93 centrati su Lens (50,432 N, 2,832 E), sulla Cité Pasteur a Liévin (50,433 N, 2,762 E) e su boulevard Richard-Lenoir (48,860 N, 2,370 E). Un blob è un gruppo di pixel di maschera a contatto di 20 m² o più, cioè quello che produce Poligonizzazione di QGIS con le impostazioni predefinite, e un edificio conta come trovato quando metà della sua impronta sta sotto la maschera. CoSIA è pubblicata solo come mappa con stile, quindi l'abbiamo letta a circa 0,4 m e riportato ogni colore alla sua classe. I pochi pixel di bordo persi così spezzano i blob, quindi le quote qui sopra sono, semmai, per difetto. Le foto alla base di CoSIA sono precedenti al registro con cui le abbiamo confrontate. BD TOPO a volte disegna una casa bifamiliare come un solo edificio. L'inventario di Parigi esclude gli alberi privati. Tre tasselli sono tre luoghi, non un dato nazionale.
Dalla maschera ai poligoni in QGIS
Una maschera semantica richiede tre o quattro passaggi di elaborazione per diventare poligoni utilizzabili, mentre uno strumento per istanze ti consegna direttamente i poligoni. Ecco i due percorsi con gli strumenti di QGIS che li eseguono.
Da una maschera semantica
- Elimina il rumore. Esegui
Raster > Analisi > Filtro(Sieve). “Rimuove i poligoni raster più piccoli di una soglia indicata (in pixel)” e li riempie con il valore del vicino più grande, secondo il manuale di QGIS. La soglia predefinita è 10 pixel. A 20 cm, 10 pixel sono solo 0,4 m², quindi alzala in base all'oggetto più piccolo che ti interessa. - Poligonizza. Esegui
Raster > Conversione > Poligonizzazione (da raster a vettore). “Crea poligoni vettoriali per tutte le regioni connesse di pixel raster che condividono lo stesso valore”, con il valore in un campo chiamatoDNper impostazione predefinita, secondo il manuale. Lascia disattivata l'opzione Usa 8-connectedness. Se è attiva, due pixel che si toccano solo in un angolo si uniscono, quindi due edifici che si incontrano in un solo angolo diventano un unico poligono. - Conserva la classe. Anche i pixel di sfondo formano poligoni. Seleziona
"DN" = 1(o il valore della tua classe) e salva la selezione come nuovo layer. - Decidi cosa significa un elemento. Per la superficie di una classe, esegui
Vettore > Strumenti di geoprocessing > Dissolvisenza campo: ottieni un unico elemento multiparte e un solo valore di area. Per i blob, seleziona Mantieni separati gli elementi disgiunti (QGIS 3.32 o successivo), oppure esegui Da multi parte a parti singole dagli Strumenti di Processing, e ogni blob diventa una riga. - Pulisci i bordi. I bordi dei pixel escono a scalini. La guida da raster a vettore tratta semplificazione, smussatura e filtro per area.
Dopo il passaggio 4 hai un poligono per blob, non per oggetto. La tabella di Lens qui sopra mostra cosa significa questa differenza: 269 blob per 3.006 edifici.
È anche così che si costruiscono i grandi dataset di impronte. Le impronte globali degli edifici di Microsoft nascono in due fasi: la “segmentazione semantica”, che riconosce i pixel di edificio con reti neurali profonde, poi la “poligonizzazione”, che converte quei pixel in poligoni. Un pixel conta come edificio quando la sua probabilità supera 0,5. È nel passaggio dei poligoni che avviene la separazione in edifici, un lavoro in più che un modello semantico lascia a te.
Da uno strumento per istanze
- Esegui lo strumento su una zona. Ogni oggetto arriva come poligono a sé, una riga nella tabella attributi.
- Controlla le multiparte. Alcuni strumenti restituiscono un oggetto in più pezzi. Da multi parte a parti singole li separa, poi controlla quelli separati prima di contare.
- Misura ogni oggetto. Aggiungi un campo con
$areanel calcolatore di campi e scarta le schegge sotto il più piccolo oggetto reale. - Associa ciò che sai. Ogni poligono può ricevere un'altezza, un indirizzo o un ID di registro con un join spaziale, cosa che la superficie di una classe non permette.
Con AI Segmentation i passaggi da 1 a 3 si riducono a uno: scrivi "building" o "swimming pool", scegli una zona e ogni oggetto trovato torna come poligono a sé in un nuovo layer. Con AI Agent, il percorso semantico qui sopra parte da una sola frase in un pannello di chat dentro QGIS: descrivi il layer che vuoi, e l'agente esegue gli stessi strumenti di QGIS, Filtro, Poligonizzazione e Dissolvi, poi controlla la mappa prima di risponderti.
Quale producono gli strumenti di QGIS
La maggior parte dei plugin QGIS basati su modelli di copertura del suolo è semantica, mentre gli strumenti basati su Segment Anything lavorano per istanze.
- Semantici: Deepness e la maggior parte dei modelli del suo zoo, il Semi-Automatic Classification Plugin, il modello di copertura del suolo di Mapflow.
- Per istanze: la famiglia Segment Anything, quindi Geo-SAM, samgeo e i plugin SAM per QGIS. Un oggetto per clic.
- AI Segmentation, il plugin che sviluppiamo in TerraLab per QGIS, lavora per istanze. Indichi l'oggetto, un edificio, un albero, una piscina, oppure ne disegni un esempio, e ottieni un poligono per ogni oggetto trovato nella zona. La guida alle impronte degli edifici mostra il risultato su un isolato denso. Dove gli edifici sono già mappati, il downloader gratuito di impronte ti dà quei poligoni per istanze in GeoJSON senza eseguire nulla.
 , lavora per istanze. Indichi l'oggetto, un edificio, un albero, una piscina, oppure ne disegni un esempio, e ottieni un poligono per ogni oggetto trovato nella zona. La
Domande frequenti
Le risposte brevi qui sotto coprono ciò che le persone cercano accanto a questi due termini.
Qual è la differenza tra segmentazione semantica, per istanze e panottica?
La segmentazione semantica assegna una classe a ogni pixel. La segmentazione per istanze separa ogni oggetto di una classe in una maschera propria. La segmentazione panottica fa entrambe le cose insieme: ogni pixel riceve una classe, e ogni oggetto numerabile, come un edificio o un'auto, riceve anche un proprio ID.
Quale devo usare per un progetto GIS?
Usa la semantica quando la risposta è un'area o una quota: copertura arborea, superficie impermeabile, terreno allagato. Usa le istanze quando la risposta è un conteggio o un attributo per oggetto: edifici, alberi, piscine, pannelli solari. Se ti servono entrambe, esegui una di ciascuna e sovrapponi i layer.
Il rilevamento di oggetti è la stessa cosa della segmentazione per istanze?
No. Il rilevamento di oggetti restituisce un rettangolo attorno a ogni oggetto. La segmentazione per istanze ne restituisce il contorno, pixel per pixel. Per una mappa quasi sempre ti serve il contorno.
Posso trasformare una maschera semantica in istanze?
A volte. Poligonizza la maschera, poi dividi i poligoni dove si restringono. Funziona su cose separate come le chiome di un frutteto. Fallisce su una schiera di case, dove non c'è nessun restringimento in cui tagliare.
La risoluzione delle immagini cambia la risposta?
Sì, ma meno di quanto si pensi. A 10 m una casa è uno o due pixel e non c'è nulla da separare, quindi la copertura del suolo da satellite è semantica per necessità. A 20 cm una casa è fatta di migliaia di pixel e la segmentazione per istanze diventa possibile, ma una maschera semantica a 20 cm fonde comunque ogni casa che condivide un muro: nel centro di Lens il 97,5% degli edifici che trova condivide un blob.
Perché la mia maschera poligonizzata dà un unico poligono per un intero isolato?
Perché le case di quell'isolato condividono i muri, quindi nella maschera nessun pixel di sfondo le separa. La poligonizzazione unisce in un poligono tutti i pixel connessi dello stesso valore. Solo un modello per istanze, che disegna ogni oggetto per conto suo, le separa.
Segment Anything fa segmentazione per istanze?
Sì, per quanto riguarda l'output: restituisce una maschera per ogni oggetto che indichi, quindi due tetti a contatto tornano come due maschere. Il modello originale però non assegna alcuna etichetta di classe. Separa gli oggetti senza dargli un nome, e gli strumenti QGIS costruiti su di esso prendono la classe dal tuo clic o dal tuo prompt.
Segmentazione semantica e per istanze rientrano nella più ampia categoria della GeoAI. Cosa significa GeoAI spiega il termine di cui queste due sono esempi. La mappatura della copertura arborea mostra entrambi i lati sugli alberi: copertura da una maschera, oppure un poligono per ogni chioma. L'hub QGIS AI raccoglie ciò che l'AI può e non può fare dentro QGIS.